Записки IT специалиста
 Информационные технологии стремительно развиваются, если раньше виртуализация и кластера были уделом крупных организаций, то сегодня эти технологии становятся доступны даже небольшим предприятиям. Виртуализация позволяет существенно экономить на аппаратных ресурсах, но в тоже время предъявляет гораздо более серьезные требования к отказоустойчивости, поэтому еще на этапе планирования следует принять необходимые меры для ее обеспечения. Одна из таких мер — создание отказоустойчивого кластера.
Научиться настраивать MikroTik с нуля или систематизировать уже имеющиеся знания можно на углубленном курсе по администрированию MikroTik. Автор курса, сертифицированный тренер MikroTik Дмитрий Скоромнов, лично проверяет лабораторные работы и контролирует прогресс каждого своего студента. В три раза больше информации, чем в вендорской программе MTCNA, более 20 часов практики и доступ навсегда.
Начнем с того, что термин отказоустойчивый не совсем применим к кластерным решениям, он возник в результате неверного перевода термина failover cluster. Правильный перевод — с обработкой отказа, хотя сегодня все чаще употребляется иной термин — высокой доступности (high availability), который, на наш взгляд, наиболее точно отражает суть дел.
Чтобы понять, почему кластер не является отказоустойчивым, разберем более подробно его устройство и схему работы. Сразу уточним, что кластеры применяются не только для обеспечения отказоустойчивости, также кластерные схемы применяют для балансировки нагрузки или наращивания вычислительной мощности. Однако в рамках данного материала мы будем говорить именно о высокодоступных кластерах.
Классическая схема кластера содержит минимум два узла и общее хранилище, связанные между собой несколькими сетевыми соединениями.
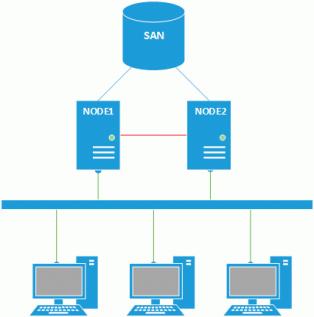
Во-первых это служебная сеть кластера для передачи сигнала «пульса» (heartbeat), по которому кластер следит за состоянием своих узлов (на схеме показана красным), сеть хранения данных (SAN, синяя), в недорогих решениях это чаще всего iSCSI через отдельную Ethernet-сеть, но это может быть также и FibreChanell или иные технологии. Для обслуживания клиентов кластер включается в существующую локальную сеть.
По схеме работы узлы могут работать в режиме активный-пассивный или активный-активный. В первом случае все клиентские запросы обслуживаются одним из узлов, второй узел вступает в работу только при отказе первого. Второй вариант предусматривает обработку клиентских запросов обоими узлами, при этом также можно осуществлять балансировку нагрузки и увеличивать вычислительные ресурсы, путем добавления новых узлов кластера. В случае отказа одного из узлов клиентские запросы обрабатывают оставшиеся ноды.
Важный момент — каждый клиентский запрос обслуживается только одним из узлов кластера и в случае его выхода из строя подключенные клиенты получат отказ в обслуживании, однако они могут тут-же переключиться на оставшиеся доступными узлы. Именно поэтому такая схема не является отказоустойчивой, отказ узла вызывает отказ в обслуживании, однако клиент всегда может подключиться к другому работающему узлу, что реализует как раз схему высокой доступности сервиса.
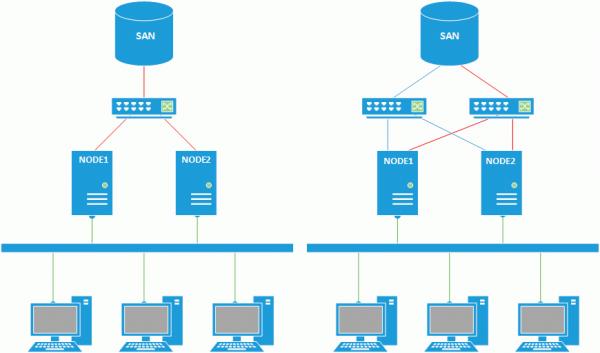
Внимательный читатель должен обратить внимание на существование в приведенной выше схеме точки отказа — хранилища. Действительно, для обеспечения высокой доступности хранилище также должно быть отказоустойчивым или высокодоступным. Это может быть реализовано как покупкой специальных аппаратных моделей, так и программно, в том числе и на базе открытого ПО.
Если в качестве хранилища используется iSCSI, то служебную сеть кластера и сеть хранения данных можно объединить. Но при этом у нас остается точка отказа — сеть, поэтому в ответственных системах следует использовать для доступа к SAN не менее двух сетей. Кроме повышения надежности данный подход позволяет повысить пропускную способность, что тоже актуально.
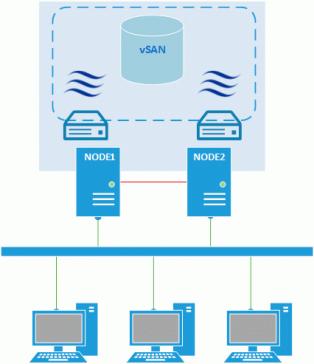
Нельзя не упомянуть и про программные решения, позволяющие создать отказоустойчивый кластер только на двух нодах, используя в качестве SAN виртуальное хранилище. Например, StarWind Virtual SAN, который создает виртуальное iSCSI хранилище на базе локальных дисков каждого из узлов. Это позволяет снизить затраты на создание и размещение отказоустойчивого хранилища, но в тоже время повышает требование к производительности сети между узлами кластера, так как при записи на диск все изменения тут-же синхронизируются между узлами.
После того, как вы создадите кластер, он появится в сетевом окружении как еще один хост со своим именем и IP-адресом. После чего нам потребуется развернуть на нем высокодоступные роли. Это могут быть файловые сервера, SQL или Exchange, а также иные, поддерживающие кластеризацию, приложения. Каждая отказоустойчивая роль кластера также появляется в сети в виде отдельного хоста, к которому происходит обращение клиентов. При этом клиент понятия не имеет, какой именно узел выполняет его запрос, в случае отказа, например, из-за выхода из строя одного из узлов, ему потребуется всего лишь повторить запрос к сервису.
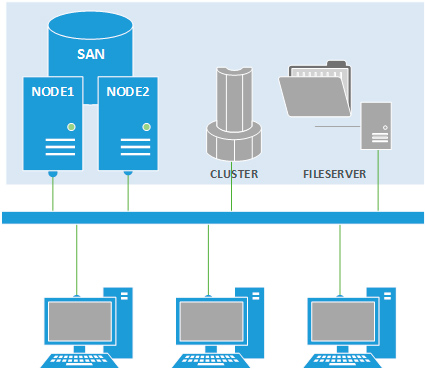
В настоящее время кластера все чаще применяются для систем виртуализации, в этом случае виртуальные машины вручную распределяются администратором между узлами, с учетом их вычислительных ресурсов. Для каждой виртуалки указываются доступные узлы в порядке убывания приоритета. Это позволяет избежать попадания ресурсоемких виртуальных машин на слабые узлы. В случае корректного завершения работы одного из узлов кластера все работающие на нем виртуальные машины с помощью механизмов живой миграции передаются на другие узлы без остановки их работы или с постановкой на паузу.
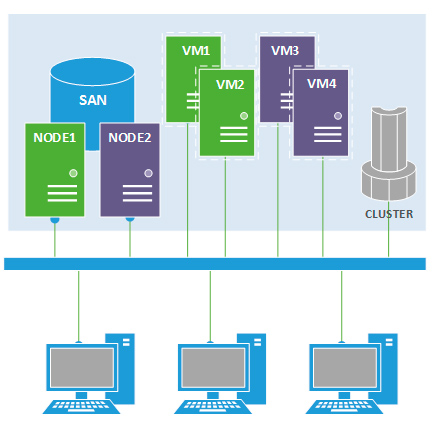
При отказе узла все выполнявшиеся на нем виртуальные машины будут перезапущены на других узлах, согласно выставленного приоритета.
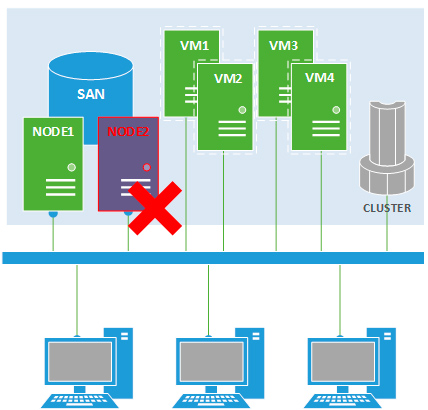
Чтобы избежать черезмерной нагрузки на хранилище и сеть хранения данных, в настройках виртуальных машин можно задать задержку восстановления, так критичные виртуалки могут быть перезапущены немедленно, второстепенные — спустя некоторое время.
В наших следующих материалах мы рассмотрим практическую реализацию отказоустойчивого кластера на базе Hyper-V.
Научиться настраивать MikroTik с нуля или систематизировать уже имеющиеся знания можно на углубленном курсе по администрированию MikroTik. Автор курса, сертифицированный тренер MikroTik Дмитрий Скоромнов, лично проверяет лабораторные работы и контролирует прогресс каждого своего студента. В три раза больше информации, чем в вендорской программе MTCNA, более 20 часов практики и доступ навсегда.
Cluster Failover — When Availability Matters
Technology is always present in our lives. Sometimes we take it for granted as it works in the background getting things done. But when things go wrong technology suddenly lunges to the forefront of our mind. Recently, a friend called from the airport to inform me that her trip was not going as planned. The system had gone down and the ticket agents had to fill out forms by hand, check names against a list, and then go to the back office to print the boarding pass. This got me thinking; was that airline’s IT department not aware that high availability of service is crucial to business success? I began to wonder if the airline had neglected to properly implement failover clustering.
For any IT department, maintaining high availability of software to its end users is of the utmost importance. High availability of a service or application means that systems have minimal downtime, whether planned or unplanned, and that they need to be available on a 24-hours-a-day basis. One way to improve availability is to implement fault-tolerant mechanisms. These mechanisms minimize how failures of the application’s components and dependent nodes affect the system. Fault tolerance can be achieved by implementing redundancy to single points of failure, such as with failover clustering.
Redundancy can definitely be achieved with Windows Server 2012 R2, wherein a failover cluster can have 64 physical nodes and can run 8,000 virtual machines on each cluster. Each node in the cluster can:
• Have full connectivity and communication with the other nodes in the cluster.
• Be aware when another node joins or leaves the cluster.
• Be connected to a network through which client computers can access the cluster.
• Be connected through a shared bus or iSCSI connection to shared storage.
• Be aware of the services or applications that are running locally, and the resources that are running on all other cluster nodes.
So what is a failover cluster? Below is a simplified diagram.
A failover cluster is a group of independent servers that work together to increase the availability of applications and services. Failover clustering provides high scalability to many server workloads such as Microsoft Exchange Server, Hyper-V, Microsoft SQL Server, and file servers. The server applications can run on physical servers or virtual machines. If one of the cluster nodes fails, another node begins to provide service. This process is known as failover. With failover, service disruptions are minimized.
The failover clustering solution shown above consists of several components, which include:
• Nodes — computers that are members of a failover cluster, that run services, resources, and applications associated with a cluster.
• Network — across which cluster nodes can communicate with one another and with clients.
• Cluster storage — the storage system that is usually shared between cluster nodes.
• Clients — The computers or users that are using the Cluster service.
• Service or application — The software that is presented to clients and used by clients.
For Windows Server 2012 R2, the requirements for failover clustering storage have changed from previous versions. For example, parallel SCSI is no longer a supported storage technology for any of the clustered disks. Below are the requirements that need to be met for the storage components:
• Disks available for the cluster must be Fibre Channel, iSCSI, or Serial Attached SCSI.
• Each cluster node must have a dedicated network interface card for iSCSI connectivity. The network interface card you use for iSCSI should not be used for network communication.
•Multipath software must be based on Microsoft’s Multipath I/O (MPIO).
- Storage drivers must be based on storport.sys.
• Drivers and firmware for the storage controllers on each server node in the cluster should be identical.
• Storage components must be marked with the “Certified for Windows Server 2012 R2” logo.
In addition, there are network requirements that must be met for Failover Clustering:
• Cluster nodes should be connected to multiple networks for communication redundancy.
• Network adapters should be the same make, use the same driver, and have the firmware version in each cluster node.
• Network components must be marked with the “Certified for Windows Server 2012 R2” logo.
Although the exact hardware will depend on the clustered application, a few requirements are standard:
• Server components must be marked with the “Certified for Windows Server 2012 R2” logo.
• Although not explicitly required, server hardware should match and contain the same or similar components.
• All of the Validate A Configuration Wizard tests must pass.
Microsoft supports a cluster solution only if the complete configuration passes all validation tests and if all hardware is certified for the version of Windows Server that the cluster nodes are running. Before you create the failover cluster, you should validate the configuration to make sure that the hardware and hardware settings are compatible with failover clustering. Note: You must have at least two nodes to run all tests. If you have only one node, many of the critical storage tests do not run.
If you are considering implementing failover clusters, you will be glad to know that in Windows Server 2012 R2, the Failover Cluster Manager console has a dashboard where you can quickly see the health status of all managed failover clusters. In the console, next to each failover cluster you manage, are icons that indicate whether the cluster is running, the number and status of clustered roles, node status, and event status. Efficiently utilizing the dashboard can assist in increasing availability and reducing downtime of applications and services which is crucial to any business’ success.
Below are the steps for:
1. Verifying the prerequisites
2. Installing the Failover Clustering feature
3. Validating the configuration
4. Creating the failover cluster
5. Creating clustered roles to host cluster workloads
1. Verifying the prerequisites
- Make sure that all servers that you want to add as cluster nodes are running the same version of Windows Server.
- Review the hardware requirements to make sure that your configuration is supported.
- If you want to add clustered storage during cluster creation, make sure that all servers can access the storage. (You can also add clustered storage after you create the cluster.)
- Make sure that all servers that you want to add as cluster nodes are joined to the same Active Directory domain.
- (Optional) Create an organizational unit (OU) and move the computer accounts for the servers that you want to add as cluster nodes into the OU. As a best practice, we recommend that you place failover clusters in their own OU in AD DS. This can help you better control which Group Policy settings or security template settings affect the cluster nodes. By isolating clusters in their own OU, it also helps prevent against accidental deletion of cluster computer objects.
- Additionally, verify the following account requirements: Make sure that the account you want to use to create the cluster is a domain user who has administrator rights on all servers that you want to add as cluster nodes.
- Make sure that either of the following is true:
a) The user who creates the cluster has the Create Computer objects permission to the OU or the container where the servers that will form the cluster reside.
b) If the user does not have the Create Computer objects permission, ask a domain administrator to pre-stage a cluster computer object for the cluster.
2. Installing the Failover Clustering feature
When following the instructions for this step, keep in mind that you must install the Failover Clustering feature on every server that you want to add as a failover cluster node. Here’s how:
- Start ServerManager.
- On the Manage menu, click Add Roles and Features.
- On the Before you begin page, click Next.
- On the Select installation type page, click Role-based or feature-based installation, and then click Next.
- On the Select destination server page, click the server where you want to install the feature, and then click Next.
- On the Select server roles page, click Next.
- On the Select features page, select the Failover Clustering check box.
- To install the failover cluster management tools, click Add Features, and then click Next.
9. On the Confirm installation selections page, click Install.
(Note: A server restart is not required for the Failover Clustering feature).
10. When the installation is completed, click Close.
11. Repeat this procedure on every server that you want to add as a failover cluster node.
3. Validating the configuration
- On a computer that has the Failover Cluster Management Tools installed from the Remote Server Administration Tools, or on a server where you installed the Failover Clustering feature, start Failover Cluster Manager. To do this on a server, start Server Manager, and then on the Tools menu, click Failover Cluster Manager.
- In the Failover Cluster Manager pane, under Management, click validate Configuration.
3. On the Before You Begin page, click Next.
4. On the Select Servers or a Cluster page, in the Enter name box, enter the NetBIOS name or the fully qualified domain name of a server that you plan to add as a failover cluster node, and then click Add. Repeat this step for each server that you want to add. To add multiple servers at the same time, separate the names by a comma or by a semicolon. For example, enter the names in the format server1.contoso.com, server2.contoso.com. When you are finished, click Next.
5. On the Testing Options page, click Run all tests (recommended), and then click Next.
6. On the Confirmation page, click Next.
The Validating page displays the status of the running tests.
7. On the Summary page, do one of the following:
a) If the results indicate that the tests completed successfully and the configuration is suited for clustering, and you want to create the cluster immediately, make sure that the Create the cluster now using the validated nodes check box is selected, and then click Finish. Then, continue to step 4 of the Create the failover cluster procedure.
b) If the results indicate that there were warnings or failures, click View Report to view the details and determine which issues must be corrected. Realize that a warning for a particular validation test indicates that this aspect of the failover cluster can be supported, but might not meet the recommended best practices.
4. Create the failover cluster
To complete this step, make sure that the user account that you log on as meets the requirements that are outlined in the Verify the prerequisites section of this topic.
To create the failover cluster:
1. Start Server Manager.
2. On the Tools menu, click Failover Cluster Manager.
3. In the Failover Cluster Manager pane, under Management, click Create Cluster. (The Create Cluster Wizard opens).
4. On the Before You Begin page, click Next.
5. If the Select Servers page appears, in the Enter name box, enter the NetBIOS name or the fully qualified domain name of a server that you plan to add as a failover cluster node, and then click Add. Repeat this step for each server that you want to add. To add multiple servers at the same time, separate the names by a comma or a semicolon. For example, enter the names in the format server1.contoso.com; server2.contoso.com. When you are finished, click Next.
Note: If you chose to create the cluster immediately after running validation in the procedure Validate the configuration, you will not see the Select Servers page. The nodes that were validated are automatically added to the Create Cluster Wizard so that you do not have to enter them again.
6. If you skipped validation earlier, the Validation Warning page appears. We strongly recommend that you run cluster validation. Only clusters that pass all validation tests are supported by Microsoft. To run the validation tests, click Yes, and then click Next. Complete the Validate a Configuration Wizard as described in the procedure Validate the configuration.
7. On the Access Point for Administering the Cluster page, do the following:
a. In the Cluster Name box, enter the name that you want to use to administer the cluster. Before you do, review the following information:
1) During cluster creation, this name is registered as the cluster computer object (also known as the cluster name object or CNO) in AD DS. If you specify a NetBIOS name for the cluster, the CNO is created in the same location where the computer objects for the cluster nodes reside. This can be either the default Computers container or an OU.
2) To specify a different location for the CNO, you can enter the distinguished name of an OU in the Cluster Name box. For example: CN=ClusterName, OU=Clusters, DC=Contoso, DC=com.
3) If a domain administrator has prestaged the CNO in a different OU than where the cluster nodes reside, specify the distinguished name that the domain administrator provides.
b. If the server does not have a network adapter that is configured to use DHCP, you must configure one or more static IP addresses for the failover cluster. Select the check box next to each network that you want to use for cluster management. Click the Address field next to a selected network, and then enter the IP address that you want to assign to the cluster. This IP address (or addresses) will be associated with the cluster name in Domain Name System (DNS).
c. When you are finished, click Next.
8. On the Confirmation page, review the settings. By default, the Add all eligible storage to the cluster check box is selected. Clear this check box if you want to do either of the following:
a. You want to configure storage later.
b. You plan to create clustered storage spaces through Failover Cluster Manager or through the Failover Clustering Windows PowerShell cmdlets, and have not yet created storage spaces in File and Storage Services.
9. Click Next to create the failover cluster.
10. On the Summary page, confirm that the failover cluster was successfully created. If there were any warnings or errors, view the summary output or click View Report to view the full report. Click Finish.
The great thing about creating redundancy using Microsoft’s Failover Cluster Manager is that your work is being validated at multiple points in the process. This ensures that your clusters are configured correctly, thus mitigating the chances of a systems crash due to a single server going down.
I think it’s safe to say that had the airline implemented failover clustering, the agents would not have had to re-process the tickets by hand, and my friend would have had a more enjoyable flight experience.
Что нового в Windows Server 2016 Failover Clustering
Всем привет! Совсем недавно была объявлена глобальная доступность Windows Server 2016, означающая возможность уже сейчас начать использование новой версии продукта в Вашей инфраструктуре. Список нововведений довольно обширный и мы уже описывали часть из них (тут и тут), но в этой статье разберем службы высокой доступности, которые, на мой взгляд, являются самыми интересными и используемыми (особенно в средах виртуализации).
Cluster OS Rolling upgrade
Миграция кластера в прошлых версиях Windows Server является причиной значительного простоя из-за недоступности исходного кластера и создания нового на базе обновленной ОС на узлах с последующей миграцией ролей между кластерами. Такой процесс несет повышенные требования к квалификации персонала, определенные риски и неконтролируемые трудозатраты. Данный факт особенно касается CSP или других заказчиков, которые имеют ограничения по времени недоступности сервисов в рамках SLA. Не стоит описывать, что для поставщика ресурсов означает значительное нарушение SLA )
Windows Server 2016 ситуацию исправляет через возможность совмещения Windows Server 2012 R2 и Windows Server 2016 на узлах в рамках одного кластера во время его апгрейда (Cluster OS Rolling Upgrade (далее CRU)).

Из названия можно догадаться, что процесс миграции кластера заключается в основном в поэтапной переустановке ОС на серверах, но об этом поговорим подробнее чуть позже.
Определим сначала список «плюшек», которые CRU предоставляет:
- Полное отсутствие простоя при апгрейде кластеров WS2012R2 Hyper-V/SOFS. Для других кластерных ролей (к примеру, SQL Server) возможна их недоступность (менее 5 минут), необходимая для отработки разового failover.
- Нет необходимости в дополнительном аппаратном обеспечении. Как правило, кластер строится из учета возможной недоступности одного или нескольких узлов. В случае с CRU, недоступность узлов будет планируемой и поэтапной. Таким образом, если кластер может безболезненно пережить временное отстутствие хотя бы 1 из узлов, то для достижения zero-downtime дополнительных узлов не требуется. Если планируется апгрейд сразу нескольких узлов (это поддерживается), то необходимо заранее спланировать распределение нагрузки между доступными узлами.
- Создание нового кластера не требуется. CRU использует текущий CNO.
- Процесс перехода обратим (до момента повышения уровня кластера).
- Поддержка In-Place Upgrade. Но, стоит отметить, что рекомендуемым вариантом обновления узлов кластера является полноценная установка WS2016 без сохранения данных (clean-os install). В случае с In-Place Upgrade обязательна проверка полной функциональности после обновления каждого из узлов (журналы событий и т.д.).
- CRU полностью поддерживается VMM 2016 и может быть автоматизирован дополнительно через PowerShell/WMI.
-
Рекомендуется предварительное резервное копирование кластера (БД) и выполняемых ресурсов. Кластер должен быть в работоспособном состоянии, узлы доступны. При необходимости следует исправить имеющиеся проблемы перед миграцией и приостановить задачи резервного копирования перед стартом перехода.


PS C:\Windows\system32> Update-ClusterFunctionalLevel
Updating the functional level for cluster hvcl.
Warning: You cannot undo this operation. Do you want to continue?
[Y] Yes [A] Yes to All [N] No [L] No to All [S] Suspend [?] Help (default is Y): a
Перечень версий ВМ, поддерживаемые 2016 RTM:
Cloud Witness
В любой кластерной конфигурации необходимо учитывать особенности размещения Witness для обеспечения дополнительного голоса и общего кворума. Witness в 2012 R2 может строиться на базе общего внешнего файлового ресурса или диска, доступных каждому из узлов кластера. Напомню, что необходимость конфигурации Witness рекомендована при любом количестве узлов, начиная с 2012 R2 (динамический кворум).
В Windows Server 2016 для обеспечения возможности построения DR на базе Windows Server и для других сценариев доступна новая модель кворумной конфигурации на базе Cloud Witness.
Cloud Witness использует ресурсы Microsoft Azure (Azure Blob Storage, через HTTPS, порты на узлах должны быть доступны) для чтения/записи служебной информации, которая изменяется при смене статуса кластерных узлов. Наименование blob-файла производится в соответствии с уникальным идентификатором кластера, — поэтому один Storage Account можно предоставлять нескольким кластерам сразу (1 blob-файл на кластер в рамках создаваемого автоматически контейнера msft-cloud-witness). Требования к размеру облачного хранилища минимальны для обеспечения работы witness и не требует больших затрат на его поддержку. Так же размещение в Azure избавляет от необходимости третьего сайта при конфигурации Stretched Cluster и решения по его аварийному восстановлению.

Cloud Witness может применяться в следующих сценариях:
- Для обеспечения DR кластера, размещенного в разных сайтах (multi-site).
- Кластеры без общего хранилища (Exchange DAG, SQL Always-On и другие).
- Гостевые кластеры, выполняющиеся как в Azure, так и в on-premises.
- Кластеры хранения данных с или без общего хранилища (SOFS).
- Кластеры в рамках рабочей группы или разных доменах (новая функциональность WS2016).
-
Создайте новый Azure Storage Account (Locally-redundant storage) и в свойствах аккаунта скопируйте один из ключей доступа.


Для упрощения можно использовать PowerShell:

Workgroup and Multi-Domain Clusters
В Windows Server 2012 R2 и предыдущих версиях необходимо соблюдение глобального требования перед созданием кластера: узлы должны быть членами одного и того же домена. Active Directory Detached кластер, презентованный в 2012 R2, имеет подобное требование и не упрощает его существенным образом.
В Windows Server 2016 возможно создание кластера без привязки к AD в рамках рабочей группы или между узлами, являющиеся членами разных доменов. Процесс схож с созданием deattached -кластера в 2012 R2, но имеет некоторые особенности:
- Поддерживается только в рамках среды WS2016.
- Требуется роль Failover Clustering.

При появлении ошибки “Requested Registry access is not allowed” необходимо изменить значение политики LocalAccountTokenFilterPolicy.

Virtual Machine Load Balancing / Node Fairness
Динамическая оптимизация, доступная в VMM, частично перекочевала в Windows Server 2016 и предоставляет базовое распределение нагрузки на узлах в автоматическом режиме. Для перемещения ресурсов используется Live Migration и эвристики, на базе которых кластер каждые 30 минут решает проводить балансировку или нет:
- Текущий % использования памяти на узле.
- Средняя загрузка по CPU в 5 минутном интервале.
| AutoBalancerLevel | Агрессивность балансировки | Комментарий |
|---|---|---|
| 1 (по умолчанию) | Low | Осуществлять балансировку при загрузке узла более 80% по одной из эвристик |
| 2 | Medium | При загрузке более 70% |
| 3 | High | При загрузке более 60% |
Параметры балансировщика можно определить и в GUI (cluadmin.msc). По умолчанию, используется Low уровень агрессивности и режим постоянной балансировки.

Для проверки я использую следующие параметры:
AutoBalancerLevel: 2
AutoBalancerMode: 2
Имитируем нагрузку сначала по CPU (около 88%) и затем по RAM (77%). Т.к. определен средний уровень агрессивности при принятии решения о балансировке и наши значения по загрузке выше определенного значения (70%) виртуальные машины на загруженном узле должны переехать на свободный узел. Скрипт ожидает момент живой миграции и выводит затраченное время (от точки начала загрузки на узла до осуществления миграции ВМ).
В случае с большой нагрузкой по CPU балансировщик переместил более 1 ВМ, при нагрузке RAM – 1 ВМ была перемещена в рамках обозначенного 30 минутного интервала, в течение которого происходит проверка загрузки узлов и перенос ВМ на другие узлы для достижения <=70% использования ресурсов.

При использовании VMM встроенная балансировка на узлах автоматически отключается и заменяется на более рекомендуемый механизм балансировки на базе Dynamic Optimization, который позволяет расширенно настроить режим и интервал выполнения оптимизации.
Virtual machine start ordering
Изменение логики старта ВМ в рамках кластера в 2012 R2 строится на понятии приоритетов (low,medium,high), задача которых обеспечивать включение и доступность более важных ВМ перед запуском остальных «зависимых» ВМ. Обычно это требуется для multi-tier сервисов, построенных, к примеру, на базе Active Directory, SQL Server, IIS.
Для повышения функциональности и эффективности в Windows Server 2016 добавлена возможность определять зависимости между ВМ или группами ВМ для решения обеспечения корректного их старта, используя Set или наборы кластерных групп. Преимущественно нацелены на использование совместно с ВМ, но могут быть использованы и для других кластерных ролей.

Для примера используем следующий сценарий:
1 ВМ Clu-VM02 является приложением, зависимым от доступности Active Directory, выполняемой на вирт. машине Clu-VM01. А ВМ Clu-VM03, в свою очередь, зависит от доступности приложения, расположенного на ВМ Clu-VM02.
Создадим новый set, используя PowerShell:

ВМ с Active Directory:
PS C:\> New-ClusterGroupSet -Name AD -Group Clu-VM01
Name: AD
GroupNames:
ProviderNames: <>
StartupDelayTrigger: Delay
StartupCount: 4294967295
IsGlobal: False
StartupDelay: 20
Приложение:
New-ClusterGroupSet -Name Application -Group Clu-VM02
Зависимый сервис от приложения:
New-ClusterGroupSet -Name SubApp -Group Clu-VM03
Добавляем зависимости между set’ами:
Add-ClusterGroupSetDependency -Name Application -Provider AD
Add-ClusterGroupSetDependency -Name SubApp -Provider Application
В случае необходимости можно изменить параметры set’а, используя Set-ClusterGroupSet. Пример:
StartupDelayTrigger определяет действие, которое необходимо произвести после старта группы:
- Delay – ожидать 20 секунд (по умолчанию). Используется совместно с StartupDelay.
- Online – ожидать состояния доступности группы в set.
isGlobal – определяет необходимость запуска set’а перед стартом других наборов кластерных групп (к примеру, set с группами ВМ Active Directory должен быть глобально доступен и, следовательно, стартовать раньше других коллекций).
Попробуем стартовать ВМ Clu-VM03:
Происходит ожидание доступности Active Directory на Clu-VM01 (StartupDelayTrigger – Delay, StartupDelay – 20 секунд)

После запуска Active Directory происходит запуск зависимого приложения на Clu-VM02 (StartupDelay применяется и на этом этапе).

И последним шагом является запуск самой ВМ Clu-VM03.

VM Compute/Storage Resiliency
В Windows Server 2016 появились новые режимы работы узлов и ВМ для повышения степени их устойчивости в сценариях проблемного взаимодействия между кластерными узлами и для предотвращения полной недоступности ресурсов за счет реакции на «малые» проблемы перед возникновением более глобальных (проактивное действие).
Режим изоляции (Isolated)
На узле HV01 внезапно стала недоступна служба кластеризации, т.е. у узла появляются проблемы интра-кластерного взаимодействия. При таком сценарии узел помещается в состояние Isolated (ResiliencyLevel) и временно исключается из кластера.

Виртуальные машины на изолированном узле продолжают выполняться* и переходят в статус Unmonitored (т.е. служба кластера не «заботится» о данных ВМ).

*При выполнении ВМ на SMB: статус Online и корректное выполнение (SMB не требует «кластерного удостоверения» для доступа). В случае с блочным типом хранилища ВМ уходят статус Paused Critical из-за недоступности Cluster Shared Volumes для изолированного узла.
Если узел в течение ResiliencyDefaultPeriod (по умолчанию 240 секунд) не вернет службу кластеризации в строй (в нашем случае), то он переместит узел в статус Down.
Режим карантина (Quarantined)
Предположим, что узел HV01 успешно вернул в рабочее состояние службу кластеризации, вышел из Isolated режим, но в течение часа ситуация повторилась 3 или более раза (QuarantineThreshold). При таком сценарии WSFC поместит узел в режим карантина (Quarantined) на дефолтные 2 часа (QuarantineDuration) и переместит ВМ данного узла на заведомо «здоровый».


При уверенности, что источник проблем был ликвидирован, можем ввести узел обратно в кластер:

Важно отметить, что в карантине одновременно могут находиться не более 25% узлов кластера.
Для кастомизации используйте вышеупомянутые параметры и cmdlet Get-Cluster:
Storage Resiliency
В предыдущих версиях Windows Server отработка недоступности r/w операций для вирт. диска (потеря соединения с хранилищем) примитивная – ВМ выключаются и требуется cold boot на последующем старте. В Windows Server 2016 при возникновении подобных проблем ВМ переходит в статус Paused-Critical (AutomaticCriticalErrorAction), предварительно «заморозив» своё рабочее состояние (её недоступность сохранится, но неожиданного выключения не будет).
При восстановлении подключения в течение таймаута (AutomaticCriticalErrorActionTimeout, 30 минут по умолчанию), ВМ выходит из paused-critical и становится доступной с той «точки», когда проблема была идентифицирована (аналогия – pause/play).
Если таймаут будет достигнут раньше возвращения хранилища в строй, то произойдет выключение ВМ (действие turn off)

Site-Aware/Stretched Clusters и Storage Replica
Тема, заслуживающая отдельного поста, но постараемся кратко познакомиться уже сейчас.
Ранее нам советовали сторонние решения (много $) для создания полноценных распределенных кластеров (обеспечение SAN-to-SAN репликации). С появлением Windows Server 2016 сократить бюджет в разы и повысить унификацию при построении подобных систем становится действительностью.
Storage Replica позволяет осуществлять синхронную (!) и асинхронную репликацию между любыми системами хранения (включая Storage Spaces Direct) и поддерживающая любые рабочие нагрузки, — лежит основе multi-site кластеров или полноценного DR -решения. SR доступна только в редакции Datacenter и может применяться в следующих сценариях:
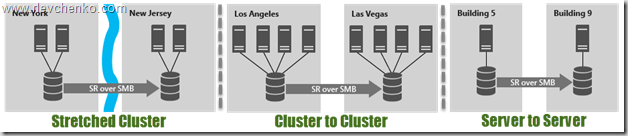
Использование SR в рамках распределенного кластера особенно ещё наличием автоматической отработки по отказу и тесной работы с site-awareness, который был презентован так же в Windows Server 2016. Site-Awarieness позволяет определять группы узлов кластера и привязывать их к физическому месторасположению (site fault domain/сайт) для формирования кастомных политик отказа (failover), размещения данных Storage Spaces Direct и логики распределения VM. Кроме того, возможна привязка не только на уровне сайтов, но и на более низкие уровни (node, rack, chassis).
Как создать отказоустойчивый кластер в ОС Windows Server 2019
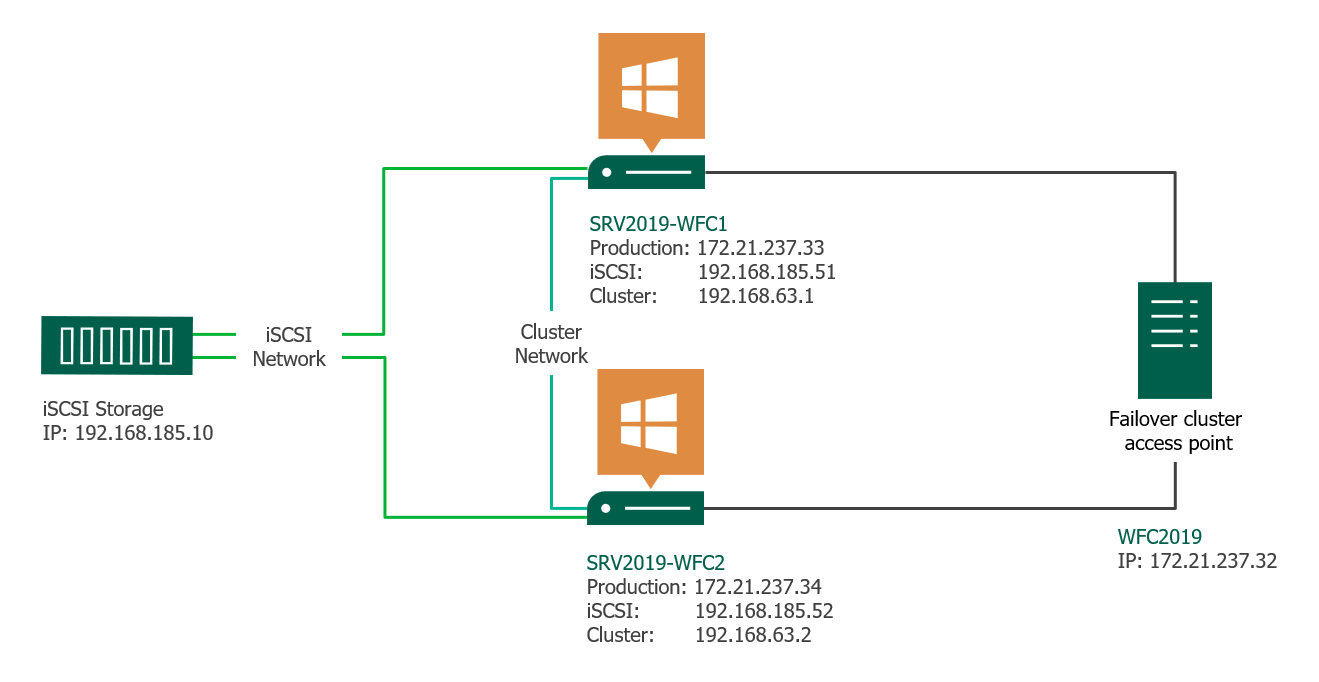
В статье приводится краткий обзор создания отказоустойчивого кластера Microsoft Windows (WFC) в ОС Windows Server 2019 или 2016. В результате вы получите двухузловой кластер с одним общим диском и кластерный вычислительный ресурс (объект «компьютер» в Active Directory).
Подготовка
Не имеет значения, какие машины вы используете — физические или виртуальные, главное, чтобы технология подходила для создания кластеров Windows. Перед тем, как начать, проверьте соответствие необходимым требованиям:
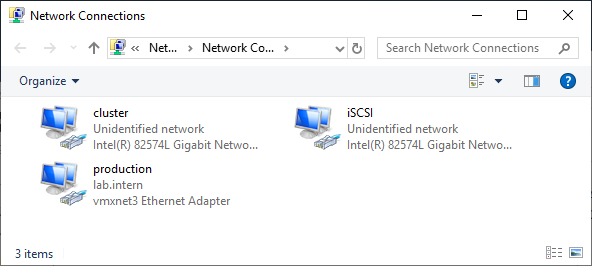
Две машины Windows 2019 с установленными последними обновлениями. У них должно быть по крайней мере два сетевых интерфейса: один для производственного трафика и один для кластерного трафика. В моем примере у машин три сетевых интерфейса (один дополнительный для трафика iSCSI). Я предпочитаю статические IP-адреса, но также можно использовать DHCP.
Введите оба сервера в домен Microsoft Active Directory и убедитесь, что они видят общий ресурс хранения, доступный в Disk Management. Пока не переводите диск в режим «онлайн».
Далее необходимо добавить функциональность Failover clustering (Server Manager > Аdd roles and features).
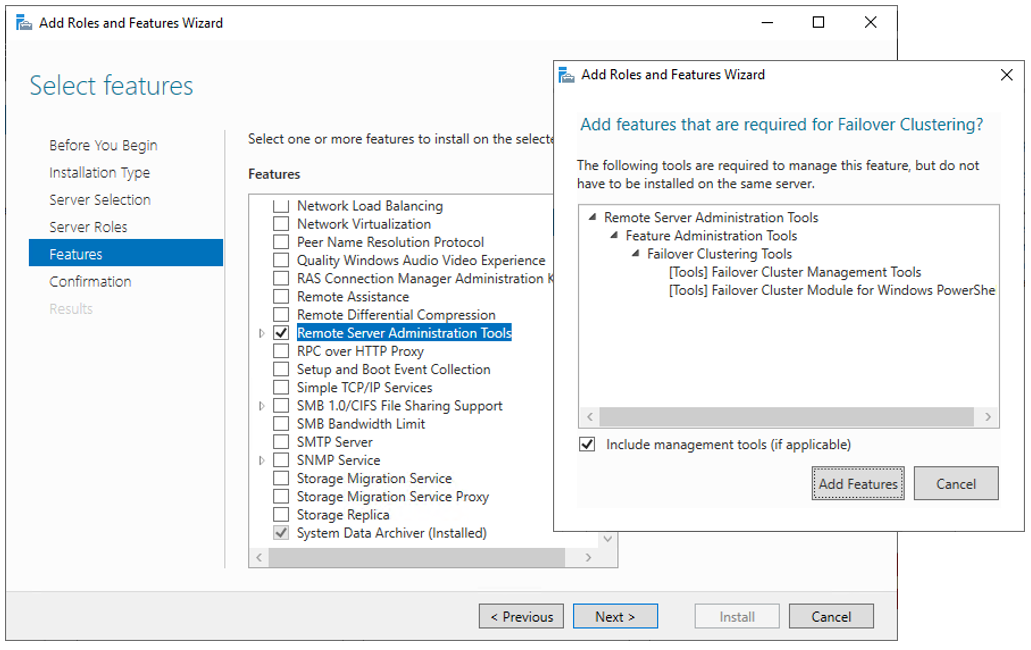
Перезапустите сервер, если требуется. В качестве альтернативы можно использовать следующую команду PowerShell:
Install-WindowsFeature -Name Failover-Clustering –IncludeManagementTools
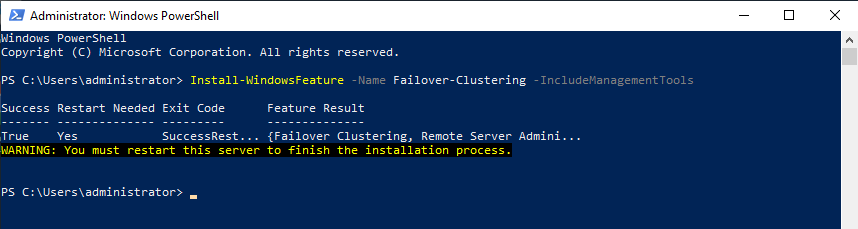
После успешной установки в меню Start, в Windows Administrative Tools появится Failover Cluster Manager .
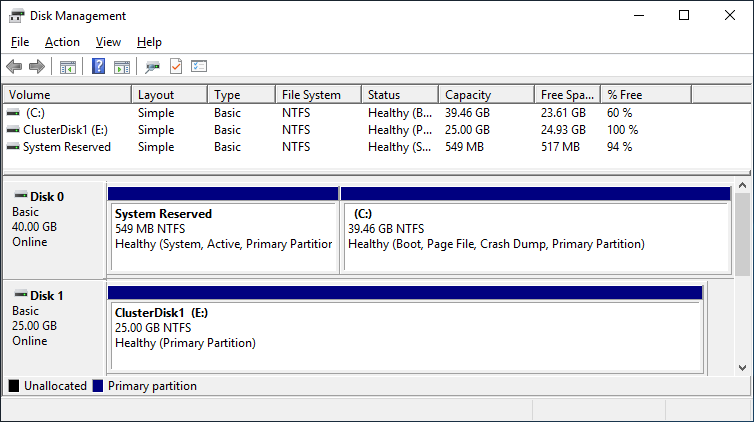
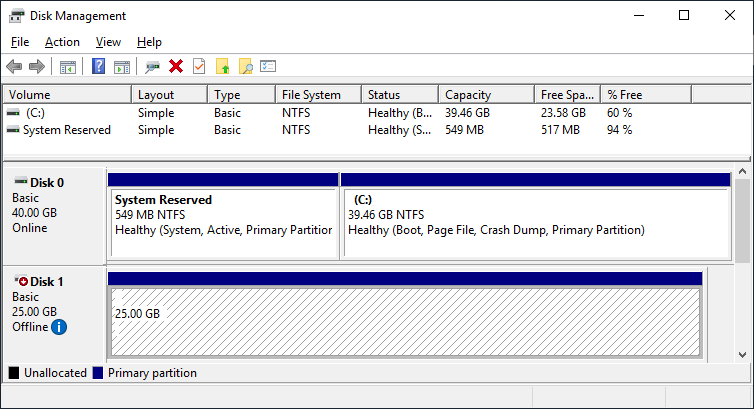
После установки Failover-Clustering можно перевести общий диск в режим «онлайн» и отформатировать его на одном из серверов. Не меняйте ничего на втором сервере. Там диск остается в режиме offline.
Обновив Disk Management, вы увидите что-то типа такого:
Server 1 Disk Management (disk status online)
Server 2 Disk Management (disk status offline)
Проверка готовности отказоустойчивого кластера
Перед созданием кластера необходимо убедиться, что все настройки правильно сконфигурированы. Запустите Failover Cluster Manager из меню Start, прокрутите до раздела Management и кликните Validate Configuration.
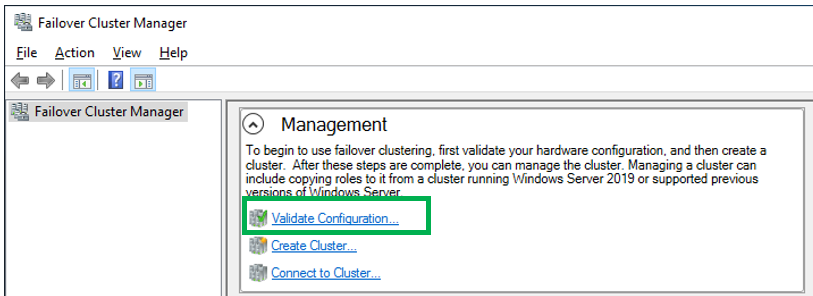
Выберите для валидации оба сервера.
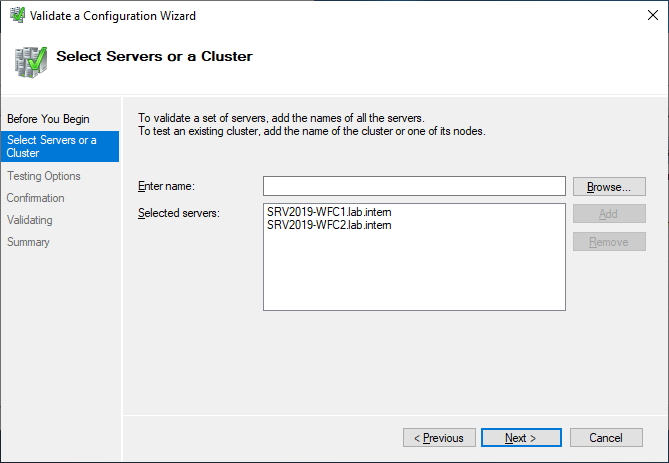
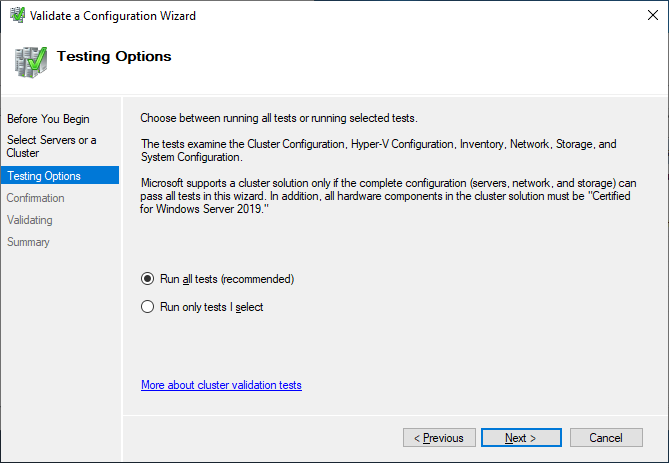
Выполните все тесты. Там же есть описание того, какие решения поддерживает Microsoft.
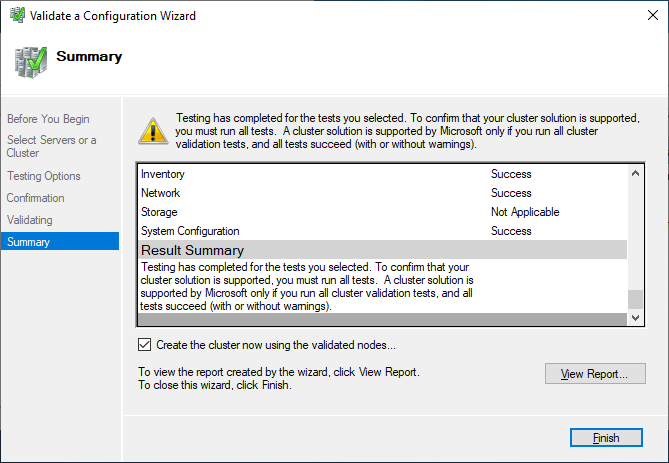
После успешного прохождения всех нужных тестов, можно создать кластер, установив флажок Create the cluster now using the validated nodes (создать кластер с помощью валидированных узлов), или это можно сделать позже. Если во время тестирования возникали ошибки или предупреждения, можно просмотреть подробный отчет, кликнув на View Report.
Создание отказоустойчивого кластера
Если вы решите создать кластер, кликнув на Create Cluster в Failover Cluster Manager, потребуется снова выбрать узлы кластера. Если вы используете флажок Create the cluster now using the validated nodes в мастере валидации кластера, выбирать узлы не понадобится. Следующим шагом будет создание точки доступа для администрирования кластера — Access Point for Administering the Cluster. Это будет виртуальный объект, с которым позже будут коммуницировать клиенты. Это объект «компьютер» в Active Directory.
В мастере нужно будет задать имя кластера — Cluster Name и сетевую конфигурацию.
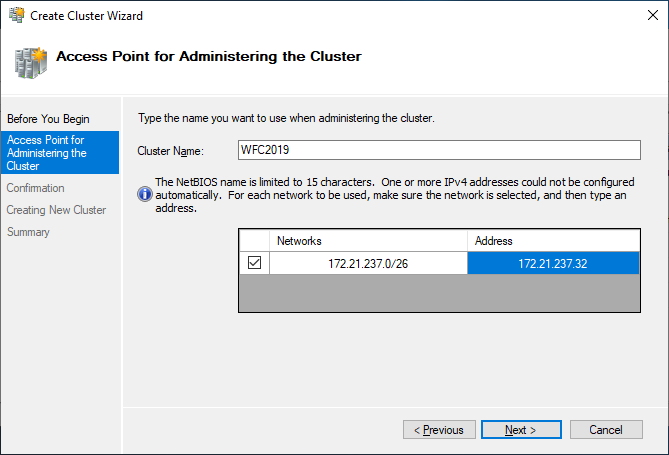
На последнем шаге подтвердите выбранные настройки и подождите создания кластера.
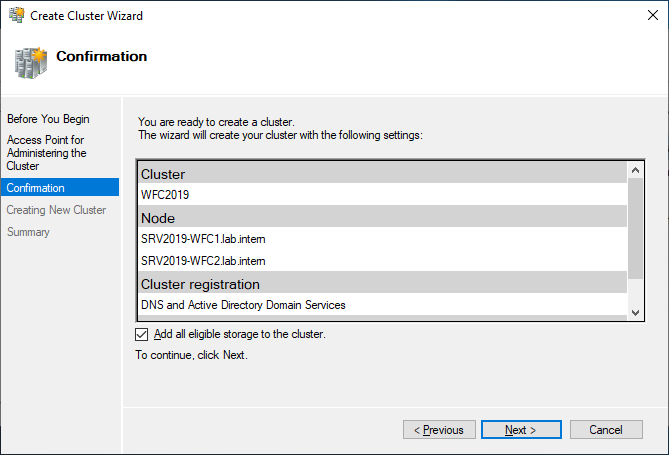
По умолчанию мастер автоматически добавит общий диск к кластеру. Если вы его еще не сконфигурировали, будет возможность сделать это позже.
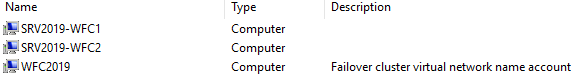
В результате вы увидите новый объект «компьютер» Active Directory под названием WFC2019.
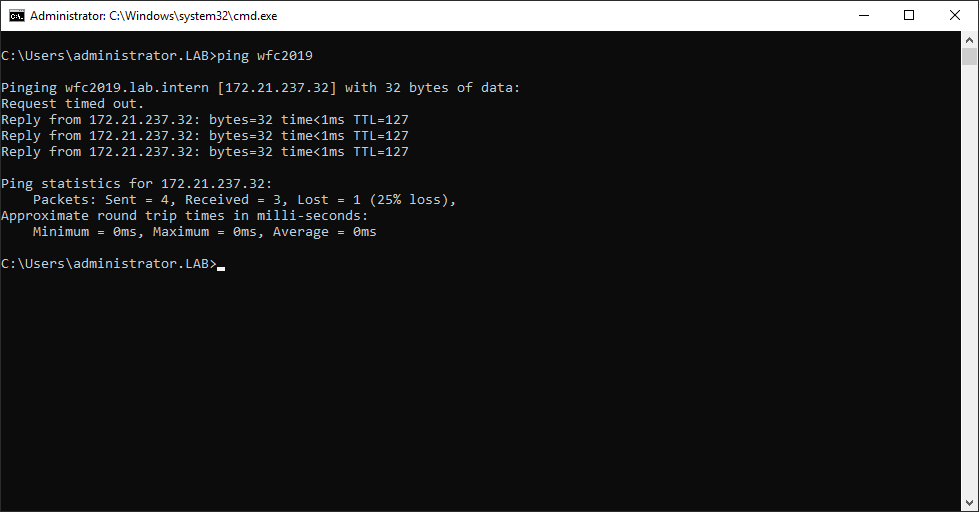
Вы можете отправить запрос к новому компьютеру, чтобы убедиться в его доступности (если ICMP-запросы разрешены в брандмауере Windows).
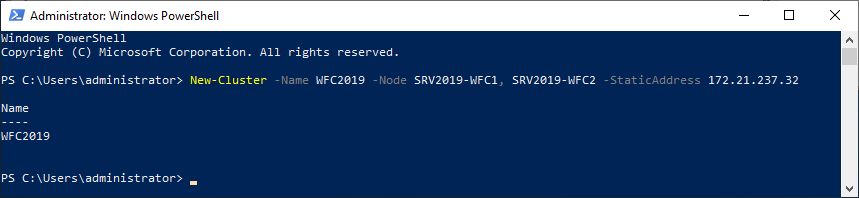
В качестве альтернативы можно создать кластер с помощью PowerShell. Следующая команда автоматически добавит подходящее хранилище:
New-Cluster -Name WFC2019 -Node SRV2019-WFC1 , SRV2019-WFC2 -StaticAddress 172.21.237.32
Результат можно будет увидеть в Failover Cluster Manager, в разделах Nodes и Storage > Disks.
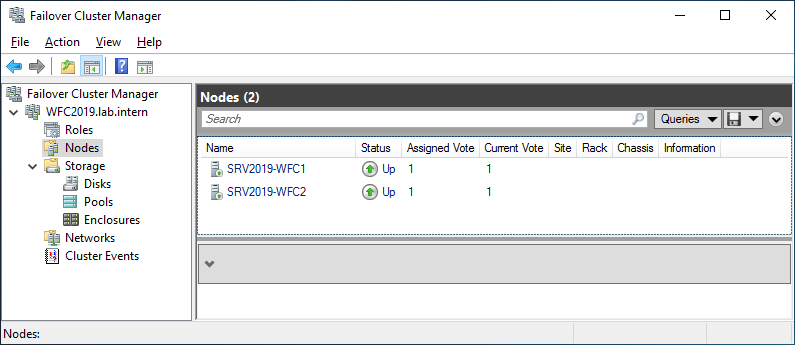
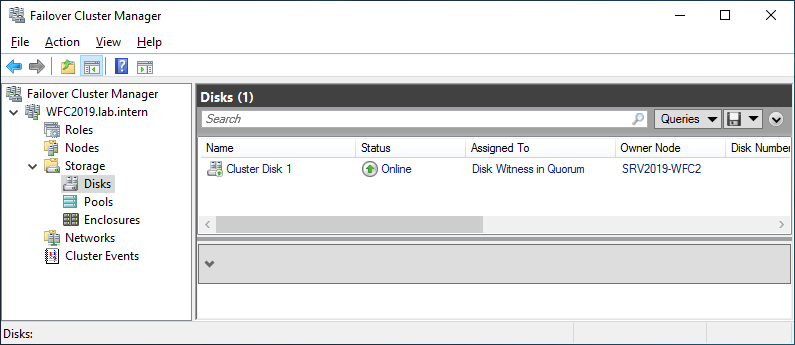
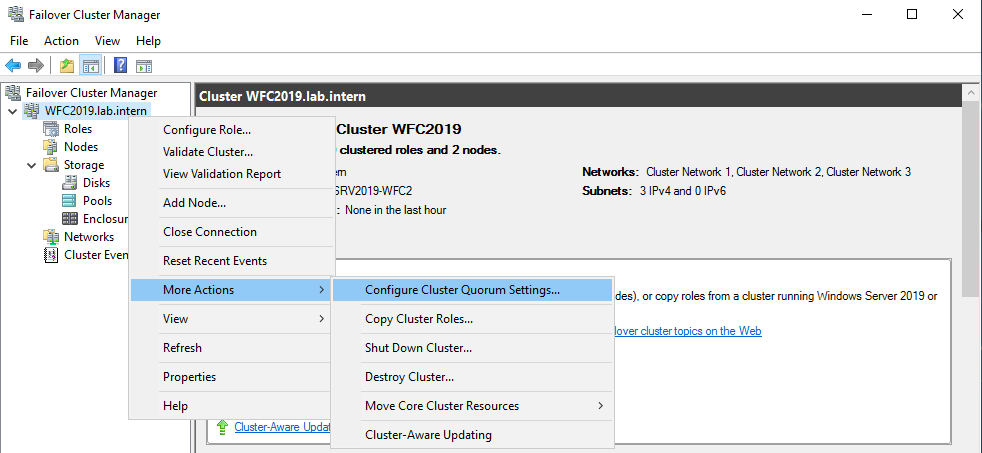
Иллюстрация показывает, что в данный момент диск используется в качестве кворума. Поскольку мы хотим использовать этот диск для данных, нам необходимо сконфигурировать кворум вручную. Из контекстного меню кластера выберите More Actions > Configure Cluster Quorum Settings (конфигурирование настроек кворума).
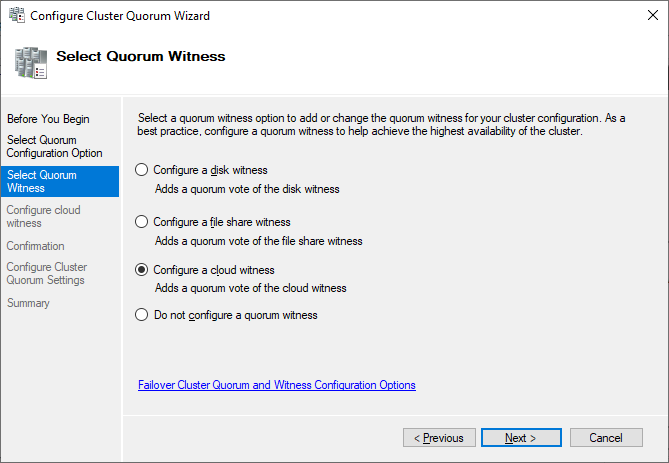
Мы хотим выбрать диск-свидетель вручную.
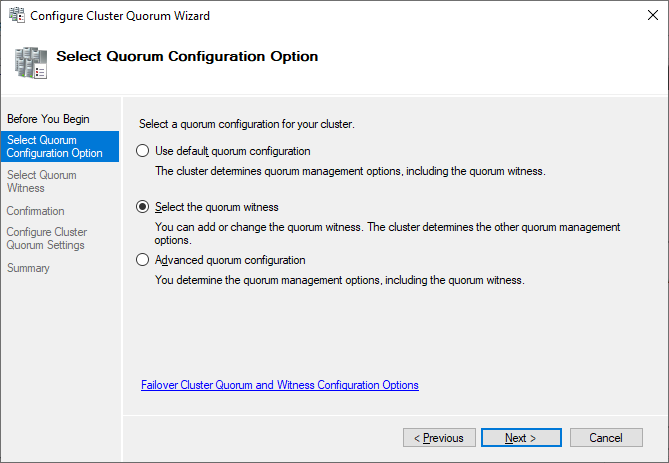
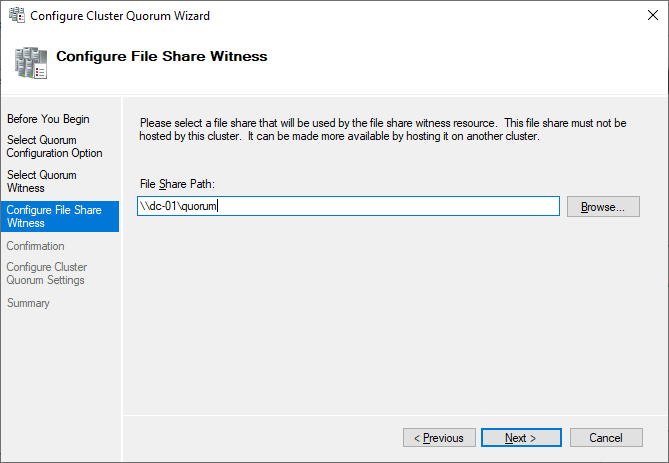
В данный момент кластер использует диск, ранее сконфигурированный как диск-свидетель. Альтернативно можно использовать в качестве свидетеля общую папку или учетную запись хранилища Azure. В этом примере мы используем в качестве свидетеля общую папку. На веб-сайте Microsoft представлены пошаговые инструкции по использованию свидетеля в облаке. Я всегда рекомендую конфигурировать свидетель кворума для правильной работы. Так что, последняя опция для производственной среды не актуальна.
Просто укажите путь и завершите мастер установки.
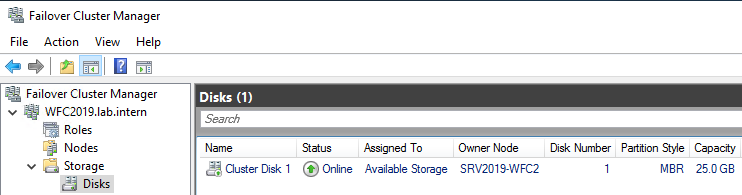
После этого общий диск можно использовать для работы с данными.
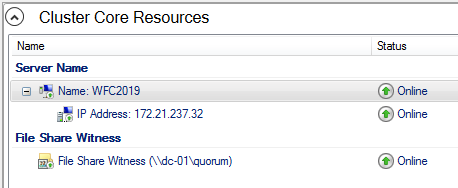
Поздравляю, вы сконфигурировали отказоустойчивый кластер Microsoft с одним общим диском.
Следующие шаги и резервное копирование
Одним из следующих шагов будет добавление роли для кластера, но это выходит за рамки данной статьи. Когда кластер будет содержать данные, пора будет подумать о его резервном копировании. Veeam Agent for Microsoft Windows может применяться для резервного копирования отказоустойчивых кластеров Windows с общими дисками. Мы также рекомендуем осуществлять резервное копирование «всей системы» кластера. При этом выполняется резервное копирование операционных систем узлов кластера. Это поможет ускорить восстановление отказавшего узла кластера, так как вам не придется искать драйверы и прочее при восстановлении.
Руководство по созданию отказоустойчивых кластеров для Windows Server 2019