Глава 7. Ввод–вывод
Возможности ввода-вывода не являются частью самого языка Си, поэтому мы подробно и не рассматривали их до сих пор. Между тем реальные программы взаимодействуют со своим окружением гораздо более сложным способом, чем те, которые были затронуты ранее. В этой главе мы опишем стандартную библиотеку, набор функций, обеспечивающих ввод-вывод, работу со стрингами, управление памятью, стандартные математические функции и разного рода сервисные Си-программы. Но особое внимание уделим вводу-выводу.
Библиотечные функции ввода–вывода точно определяются стандартом ANSI, так что они совместимы на любых установках, где поддерживается Си. Программы, которые в своем взаимодействии с системным окружением не выходят за рамки возможностей стандартной библиотеки, можно без изменений переносить с одной машины на другую.
Свойства библиотечных функций специфицированы в более чем дюжине головных файлов; вам уже встречались некоторые из них, в том числе <stdio.h> , <string.h> и <ctype.h> . Мы не рассматриваем здесь всю библиотеку, так как нас больше интересует написание Си-программ, чем использование библиотечных функций. Стандартная библиотека подробно описана в приложении B.
7.1. Стандартный ввод–вывод
Как уже говорилось в гл. 1, библиотечные функции реализуют простую модель текстового ввода-вывода. Текстовый поток состоит из последовательности строк; каждая строка заканчивается литерой новая_строка. Если система в чем-то не следует принятой модели, библиотека сделает так, чтобы казалось, что эта модель удовлетворяется полностью. Например, пара литер — возврат_каретки и перевод_строки — при вводе могла бы быть преобразована в одну литеру новая_строка, а при выводе выполнялось бы обратное преобразование.
Простейший механизм ввода — это чтение одной литеры из стандартного ввела (обычно с клавиатуры) функцией getchar :
В качестве результата каждого своего вызова функция getchar возвращает следующую литеру ввода или, если обнаружен конец файла, EOF . Именованная константа EOF (аббревиатура от end of file — конец файла) определена в <stdio.h> . Обычно значение EOF равно -1, но, чтобы не зависеть от конкретного значения этой константы, ссылаться на нее следует по имени ( EOF ).
Во многих системах клавиатуру можно заменить файлом, перенаправив ввод при помощи значка < . Так, если программа prog использует getchar , то командная строка
предпишет программе prog читать литеры из infile , а не с клавиатуры. Переключение ввода делается так, что сама программа prog не замечает подмены; в частности, стринг « <infile » не будет включен в аргументы командной строки argv . Переключение ввода будет также незаметным, если ввод исходит от другой программы и передается через «трубопроводный» механизм. В некоторых системах командная строка
приведет к тому, что две программы, otherprog и prog , соединятся напрямую, т.е. стандартный вывод otherprog станет стандартным вводом для prog .
используется для вывода: putchar(c) отправляет литеру c в стандартный вывод, под которым по умолчанию подразумевается экран. Функция putchar в качестве результата возвращает посланную литеру или, в случае ошибки, EOF . То же и в отношении вывода: при помощи записи вида >имя_файла вывод можно перенаправить в файл. Например, если prog использует для вывода функцию putchar , то
будет направлять стандартный вывод не на экран, а в outfile . А командная строка
соединит стандартный вывод программы prog со стандартным вводом программы anotherprog .
Вывод, осуществляемый функцией printf , также отправляется в стандартный выходной поток. Вызовы putchar и printf могут как угодно чередоваться, при этом вывод будет формироваться в той последовательности, в которой происходили вызовы этих функций.
Любой исходный Си-файл, использующий хотя бы одну функцию библиотеки ввода-вывода, должен содержать в себе строку
причем она должна быть расположена до первого обращения к вводу-выводу. Если имя головного файла заключено в угловые скобки < и > , это значит, что поиск головного файла ведется в стандартном месте (например, в системе UNIX это обычно директория /usr/include ).
Многие программы читают только из одного входного потока и пишут только в один выходной поток. Для организации ввода-вывода таким программам вполне хватит функций getchar , putchar и printf , а для начального обучения ознакомления с этими функциями уж точно достаточно. В частности, перечисленных функций достаточно, когда требуется вывод одной программы соединить с вводом следующей. В качестве примера рассмотрим программу lower , переводящую свой ввод на нижний регистр:
Функция tolower определена в <ctype.h> . Она переводит буквы верхнего регистра в буквы нижнего регистра, а остальные литеры возвращает без изменений. Как мы уже упоминали, «функции» типа getchar и putchar из библиотеки <stdio.h> и функция tolower из библиотеки <ctype.h> часто реализуют в виде макросов, чтобы исключить накладные расходы от вызова функции на каждую отдельную литеру. В разд. 8.5 мы покажем, как это делается. Независимо от того, как на той или иной машине реализованы функции библиотеки <ctype.h> , использующие их программы могут ничего не знать о кодировке литер.
Упражнение 7.1.
Напишите программу, осуществляющую перевод ввода с верхнего регистра на нижний или с нижнего на верхний в зависимости от имени, по которому она вызывается и текст которого находится в arg[0] .
7.2. Форматный вывод ( printf )
Функция printf переводит внутренние значения в текст.
В предыдущих главах мы использовали printf неформально. Здесь мы покажем наиболее типичные случаи применения этой функции; полное ее описание дано в приложении B.
Функция printf преобразует, форматирует и печатает свои аргументы в стандартном выводе под управлением формата. Возвращает она количество напечатанных литер.
Форматный стринг содержит два вида объектов: обычные литеры, которые впрямую копируются в выходной поток, и спецификации преобразования, каждая из которых вызывает преобразование и печать очередного аргумента printf . Любая спецификация преобразования начинается знаком % и заканчивается литерой–спецификатором. Между % и литерой–спецификатором могут быть расположены (в указанном ниже порядке) следующие элементы:
- Знак минус, предписывающий «прижать» преобразованный аргумент к левому краю поля.
- Число, специфицирующее минимальную ширину поля. Преобразованный аргумент будет занимать поле по крайней мере указанной ширины. При необходимости лишние позиции слева (или справа при левостороннем расположении) будут заполнены пробелами.
- Точка, отделяющая ширину поля от величины, устанавливающей точность.
- Число (точность), специфицирующее максимальное количество печатаемых литер стринга, или количество цифр после десятичной точки — для плавающего значения, или минимальное количество цифр — для целого.
- Буква h , если печатаемое целое должно рассматриваться как short , или l (латинская буква эль), если целое должно рассматриваться как long .
Литеры–спецификаторы перечислены в табл. 7.1. Если за % не помещена литера–спецификатор, поведение функции printf будет не определено.
Таблица 7.1. Основные преобразования printf
| Литера | Тип аргумента; вид печати |
|---|---|
| d, i | int ; десятичное целое. |
| o | int ; беззнаковое восьмеричное (octal) целое (без ведущего нуля). |
| x, X | int ; беззнаковое шестнадцатиричное целое (без ведущих 0x и 0X ), для 10. 15 используются abcdef или ABCDEF . |
| u | int ; беззнаковое десятичное целое. |
| c | int ; одиночная литера. |
| s | char * ; печатает литеры, расположенные до знака \0 , или в количестве, заданном точностью. |
| f | double ; [-]m.dddddd , где количество цифр d задается точностью (по умолчанию равно 6). |
| e, E | double ; [-]m.dddddde+-xx или [-]m.ddddddE+-xx , где количество цифр d задается точностью (по умолчанию равно 6). |
| g, G | double ; использует %e или %E , если экспонента меньше, чем -4, или больше или равна точности; в противном случае использует %f . «Хвостовые» нули и «хвостовая» десятичная точка не печатаются. |
| p | void * ; указатель (представление зависит от реализации). |
| % | аргумент не преобразуется; печатается знак % . |
Ширину и точность можно специфицировать при помощи * ; значение ширины (или точности) в этом случае берется из следующего аргумента (который должен быть типа int ). Например, чтобы напечатать не более max литер из стринга s . годится следующая запись:
Большая часть форматных преобразований была продемонстрирована в предыдущих главах. Исключение составляет задание точности для стрингов. Далее приводится перечень спецификаций и показывается их влияние на печать стринга "hello, world" , состоящего из 12 литер. Поле специально обрамлено двоеточиями, чтобы была видна его протяженность.
| :%s: |
| :%10s: |
| :%.10s: |
| :%-10s: |
| :%.15s: |
| :%-15s: |
| :%15.10s: |
| :%-15.10s: |
Предостережение: функция printf использует свой первый аргумент, чтобы определить, сколько еще ожидается аргументов и какого они будут типа. Вы не получите правильного результата, если аргументов будет не хватать или они будут принадлежать не тому типу. Вы должны также понимать разницу в следующих двух обращениях:
Функция sprintf выполняет те же преобразования, что и printf , но вывод запоминает в стринге
Эта функция форматирует arg1 , arg2 и т.д. в соответствии с информацией, заданной аргументом format так, как мы ранее описывали, но результат помещает не в стандартный вывод, а в string . Заметим, что string должен быть достаточно большим, чтобы в нем поместился результат.
Упражнение 7.2.
Напишите программу, которая будет печатать разумным способом любой ввод. Как минимум она должна уметь печатать неграфические литеры в восьмеричном или шестнадцатиричном виде (в форме, принятой на вашей машине), обрывая длинные текстовые строки.
7.3. Списки аргументов переменной длины
Этот раздел содержит реализацию минимальной версии printf . Приводится она для того, чтобы показать, как надо писать функции со списками аргументов переменной длины, причем такие, которые были бы переносимы. Поскольку нас главным образом интересует обработка аргументов, функцию minprintf напишем таким образом, что она в основном будет работать со стрингом, задающим формат, и аргументами; что же касается форматных преобразований, то они будут осуществляться при помощи стандартного printf .
Декларация стандартной функции printf выглядит так:
Многоточие в декларации означает, что число и типы аргументов могут изменяться. Знак многоточие может стоять только в конце списка аргументов. Наша функция minprintf декларируется как
поскольку она не будет выдавать число литер, как это делает printf .
Вся сложность в том, каким образом minprintf будет продвигаться вдоль списка аргументов, — ведь у этого списка нет даже имени. Стандартный головной файл <stdarg.h> содержит набор макроопределений, которые определяют, как шагать по списку аргументов. Наполнение этого головного файла может изменяться от машины к машине, но представленный им интерфейс везде одинаков.
Тип va_list служит для описания переменной, которая будет по очереди ссылаться на каждый из аргументов; в minprintf эта переменная имеет имя ap (от «argument pointer» — указатель на аргумент). Макрос va_start инициализирует переменную ap , чтобы она указывала на первый безымянный аргумент. К va_start нужно обратиться до первого использования ap . Среди аргументов по крайней мере один должен быть именованным; от последнего именованного аргумента этот макрос «отталкивается» при начальной установке.
Макрос va_arg на каждом своем вызове выдает очередной аргумент, а ap передвигает на следующий; по имени типа он определяет тип возвращаемого значения и размер шага для выхода на следующий аргумент. Наконец, макрос va_end делает очистку всего, что необходимо. К va_end следует обратиться перед самым выходом из функции.
Перечисленные средства образуют основу нашей упрощенной версии printf .
Упражнение 7.3.
Дополните minprintf другими возможностями printf .
7.4. Форматный ввод ( scanf )
Функция scanf обеспечивающая ввод, является аналогом printf ; она выполняет многие из упоминавшихся преобразований, но в противоположном направлении. Ее декларация имеет следующий вид:
Функция scanf читает литеры из стандартною входного потока, интерпретирует их согласно спецификациям стринга format и рассылает результаты в свои остальные аргументы. Аргумент — формат мы опишем позже; другие аргументы, каждый из которых должен быть указателем, определяют, где будут запоминаться должным образом преобразованные данные. Как и для printf , в этом разделе дается сводка наиболее полезных, но отнюдь не всех возможностей данной функции.
Функция scanf прекращает работу, когда оказывается, что исчерпался формат или вводимая величина не соответствует управляющей спецификации. В качестве результата scanf возвращает количество успешно введенных элементов данных. По исчерпании файла она выдает EOF . Существенно то, что значение EOF не равно нулю, поскольку нуль scanf выдает, когда вводимая литера не соответствует первой спецификации форматного стринга. Каждое очередное обращение к scanf продолжает ввод с литеры, следующей сразу за последней обработанной.
Существует также функция sscanf , которая читает из стринга (а не из стандартного ввода).
Функция sscanf просматривает string согласно формату format и рассылает полученные значения в arg1 , arg2 и т.д. Последние должны быть указателями.
Формат обычно содержит спецификации, которые используются для управления преобразованиями ввода. В него могут входить следующие элементы:
- Пробелы или табуляции, которые игнорируются.
- Обычные литеры (исключая % ), которые, как ожидается, совпадут с очередными непробельными литерами входного потока.
- Спецификации преобразования, каждая из которых начинается со знака % и завершается литерой–спецификатором типа преобразования. В промежутке между этими двумя литерами в любой спецификации могут располагаться, причем в том порядке, как они здесь указаны: знак * (признак подавления присваивания); число, определяющее ширину поля; буква h , l или L , указывающая на размер получаемого значения.
Спецификация преобразования управляет преобразованием следующего вводимого поля. Обычно результат помещается в переменную, на которую указывает соответствующий аргумент. Однако если в спецификации преобразования присутствует * , то поле ввода пропускается и никакое присваивание не выполняется. Поле ввода определяется как стринг без пробельных литер; оно простирается до следующей пробельной литеры или же ограничено шириной поля, если она задана. Поскольку литера новая_строка относится к пробельным литерам, это значит, что scanf при чтении будет переходить с одной строки на другую. (Пробельными литерами являются литеры пробела, табуляции, новой_строки, возврата_каретки, вертикальной_табуляции и перевода_страницы.)
Литера–спецификатор указывает, каким образом следует интерпретировать очередное поле ввода. Соответствующий аргумент должен быть указателем, как того требует механизм передачи параметров по значению, принятый в Си. Литеры–спецификаторы приведены в табл. 7.2.
Таблица 7.2. Основные преобразования scanf
| Литера | Вводимые данные; тип аргумента |
|---|---|
| d | десятичное целое; int * . |
| i | целое; int * . Целое может быть восьмеричными (с ведущим 0) или шестнадцатиричным (с ведущими 0x или 0X ). |
| o | восьмеричное целое (с ведущим нулем или без него); int * . |
| u | беззнаковое десятичное целое; unsigned int * . |
| x | шестнадцатиричное целое (с ведущими 0x или 0X или без них); |
| c | литеры; char * . Следующие литеры ввода (по умолчанию одна) размещаются в указанном месте. Обычный пропуск пробельных литер подавляется; чтобы прочесть очередную литеру, отличную от пробельной, используйте %1s . |
| s | стринг литер (без обрамляющих кавычек); char * , указывающий на массив литер, достаточный для стринга и завершающей литеры ‘\0’ , которая будет добавлена. |
| e, f, g | число с плавающей точкой, возможно, со знаком; обязательно присутствие либо десятичной точки, либо экспоненциальной части, а возможно, и обеих вместе; float * . |
| % | сам знак % , никакое присваивание не выполняется. |
Перед литерами–спецификаторами d , i , o , u и x может стоять буква h , указывающая на то, что соответствующий аргумент должен иметь тип short * (а не int * ), или l (латинская эль), указывающая на тип long * . Аналогично, перед литерами–спецификаторами e , f и g может стоять l , указывающая, что тип аргумента — double * (а не float * ).
Чтобы построить первый пример, обратимся к программе калькулятора из гл. 4, в которой организуем ввод с помощью функции scanf :
Предположим, что нам нужно прочитать строки ввода, содержащие данные вида
Обращение к scanf выглядит следующим образом:
Знак & перед monthday не нужен, так как имя массива есть указатель.
В стринге формата могут присутствовать литеры, не участвующие ни в одной из спецификаций; это значит, что эти литеры должны появиться на вводе. Так, мы могли бы читать даты вида mm/dd/yy при помощи следующего обращения к scanf :
В своем формате функция scanf игнорирует пробелы и табуляции. Кроме того, при поиске следующей порции ввода она пропускает во входном потоке все пробельные литеры (пробелы, табуляции, новые_строки и т.д.). Воспринимать входной поток, не имеющий фиксированного формата, часто оказывается удобнее, если вводить всю строку целиком и для каждого отдельного случая подбирать подходящий вариант sscanf . Предположим, например, что нам нужно читать строки с датами, записанными в любой из приведенных выше форм. Тогда мы могли бы написать:
Обращения к scanf могут перемежаться с вызовами других функций ввода. Любая функция ввода, вызванная после scanf , продолжит чтение с первой еще непрочитанной литеры.
В завершение еще раз напомним, что аргументы scanf и sscanf должны быть указателями.
Одна из самых распространенных ошибок состоит в том, что вместо того, чтобы написать
Компилятор о подобной ошибке ничего не сообщает.
Упражнение 7.4.
Напишите свою версию scanf по аналогии с minprintf из предыдущего раздела.
Упражнение 7.5.
Перепишите основанную на постфиксной записи программу калькулятора из гл. 4 таким образом, чтобы для ввода и преобразования чисел она использовала scanf и/или sscanf .
7.5. Доступ к файлам
Во всех предыдущих примерах мы имели дело со стандартным вводом и стандартным выводом, которые для программы автоматически предопределены операционной системой конкретной машины.
Следующий шаг — научиться писать программы, которые имели бы доступ к файлам, заранее не подсоединенным к программам. Одна из программ, в которой возникает такая необходимость — это программа cat , объединяющая несколько именованных файлов и направляющая результат в стандартный вывод. Функция cat часто применяется для выдачи файлов на экран, а также как универсальный «коллектор» файловой информации тех программ, которые не имеют возможности обратиться к файлу по имени. Например, команда
направит в стандартный вывод содержимое файлов x.c и y.c (и ничего более).
Возникает вопрос: что надо сделать, чтобы именованные файлы можно было читать; иначе говоря, как связать внешние имена, придуманные пользователем, с инструкциями чтения данных?
На этот счет имеются простые правила. Для того чтобы можно было читать из файла или писать в файл, он должен быть предварительно открыт при помощи библиотечной функции fopen . Функция fopen получает внешнее имя типа x.c или y.c , после чего осуществляет некоторые организационные действия и «переговоры» с операционной системой (технические детали которых здесь не рассматриваются) и возвращает указатель, используемый в дальнейшем для доступа к файлу.
Этот указатель, называемый указателем файла, ссылается на структуру, содержащую информацию о файле (адрес буфера, положение текущей литеры в буфере, открыт файл на чтение или на запись, были ли ошибки при работе с файлом и встретился ли конец файла). Пользователю не нужно знать подробности, поскольку определения, полученные из <stdio.h> , включают описание такой структуры, называемой FILE . Единственное, что требуется для определения указателя файла, — это задать декларации такого, например, вида:
Из этой записи следует, что fp есть указатель на FILE , а fopen возвращает указатель на FILE . Заметим, что FILE есть имя типа, наподобие int , а не тег структуры. Оно определено при помощи typedef . (Детали того, как можно реализовать fopen в системе UNIX, приводятся в разд. 8.5.)
Обращение к fopen в программе может выглядеть следующим образом:
Первый аргумент — стринг, содержащий имя файла. Второй аргумент несет информацию о режиме. Это тоже стринг: в нем указывается, каким образом пользователь намерен использовать файл. Возможны следующие режимы: чтение ( read — "r" ), запись ( write — "w" ) и добавление ( append — "a" ), т.е. запись информации в конец уже существующего файла. В некоторых системах различаются текстовые и бинарные файлы; в случае последних в стринг режима необходимо добавить букву "b" (binary — бинарный).
Тот факт, что некий файл, которого раньше не было, открывается на запись или добавление, означает, что он создается (если такая процедура физически возможна). Открытие уже существующего файла на запись приводит к выбрасыванию его старого содержимого, в то время как при открытии файла на добавление его старое содержимое сохраняется. Попытка читать несуществующий файл является ошибкой. Могут иметь место и другие ошибки; например, ошибкой считается попытка чтения файла, который по статусу запрещено читать. При наличии любой ошибки fopen возвращает NULL . (Возможна более точная идентификация ошибки; детальная информация по этому поводу приводится в конце разд. 1 приложения B.)
Следующее, что нам необходимо знать, — это как читать из файла или писать в файл, коль скоро он открыт. Существует несколько способов сделать это, из которых самый простой состоит в том, чтобы воспользоваться функциями getc и putc . Функция getc возвращает следующую литеру из файла; ей необходимо сообщить указатель файла, чтобы она знала откуда брать литеру.
Функция getc возвращает следующую литеру из потока, на который ссылаются при помощи *fp ; в случае исчерпания файла или ошибки она возвращает EOF .
Функция putc пишет литеру c в файл fp и возвращает записанную литеру или EOF , в случае ошибки. Аналогично getchar и putchar , программы getc и putc могут быть реализованы в виде макросов, а не функций.
При запуске Си-программы операционная система всегда открывает три файла и обеспечивает три файловые ссылки на них. Этими файлами являются: стандартный ввод, стандартный вывод и стандартный файл ошибок; соответствующие им указатели называются stdin , stdout и stderr ; они описаны в <stdio.h> . Обычно stdin соотнесен с клавиатурой, а stdout и stderr — с экраном. Однако stdin и stdout можно связать с файлами или, используя механизм «трубопровода», соединить напрямую с другими программами, как это описывалось в разд. 7.1.
При помощи getc , putc , stdin и stdout функции getchar и putchar теперь можно определить следующим образом:
Форматный ввод-вывод файлов можно построить на функциях fscanf и fprintf . Они идентичны scanf и printf с той лишь разницей, что первым их аргументом является указатель, ссылающийся на файл, для которого осуществляется ввод-вывод, формат же указывается вторым аргументом.
Вот теперь мы располагаем теми сведениями, которые достаточны для написания программы cat , предназначенной для конкатенации (последовательного соединения) файлов. Предлагаемая версия функции cat , как оказалось, удобна для многих программ. Если в командной строке присутствуют аргументы, они рассматриваются как имена последовательно обрабатываемых файлов. Если аргументов нет, то обработке подвергается стандартный ввод.
Файловые указатели stdin и stdout представляют собой объекты типа FILE * . Это константы, а не переменные, следовательно, им нельзя ничего присваивать.
— обратная по отношению к fopen ; она разрывает связь между файловым указателем и внешним именем (которая раньше была установлена при помощи fopen ), освобождая тем самым этот указатель для других файлов. Так как в большинстве операционных систем количество одновременно открытых одной программой файлов ограничено, то файловые указатели, если они больше не нужны, лучше освобождать, как это и делается в программе cat . Есть еще одна причина применить fclose к файлу вывода, — это необходимость «опорожнить» буфер, в котором putc накопила, предназначенные для вывода данные. При нормальном завершении работы программы для каждого открытого файла fclose вызывается автоматически. (Вы можете закрыть stdin и stdout , если они вам не нужны. Воспользовавшись библиотечной функцией freopen их можно создать заново.)
7.6. Управление ошибками ( stderr и exit )
Обработка ошибок в cat нельзя признать идеальной. Беда в том, что если файл по какой-либо причине недоступен, сообщение об этом мы получим по окончании конкатенируемого вывода. Это нас устроило бы, если бы вывод отправлялся только на экран, а не в файл или другой программе, напрямую по «трубопроводу».
Чтобы лучше справиться с этой проблемой, программе помимо стандартного вывода stdout придается еще один выходной поток, называемый stderr . Вывод в stderr обычно отправляется на экран, даже если вывод stdout перенаправлен в другое место.
Перепишем cat так, чтобы сообщения об ошибках отправлялись в stderr .
Программа сигнализирует об ошибках двумя способами. Первый — сообщение об ошибке при помощи fprintf посылается в stderr с тем, чтобы оно попало на экран, а не оказалось в «трубопроводе» или в другом файле вывода. Имя программы, хранящееся в argv[0] , мы включили в сообщение, чтобы в случаях, когда данная программа работает совместно с другими, был ясен источник ошибки.
Второй способ указать на ошибку — обратиться к библиотечной функции exit , завершающей работу программы. Аргумент функции exit доступен некоторому процессу, вызвавшему данный процесс. А следовательно, успешное или ошибочное завершение программы можно проконтролировать с помощью некоей программы, которая рассматривает эту программу в качестве подчиненного процесса. По общей договоренности возврат нуля сигнализирует о том, что работа прошла нормально, в то время как ненулевые значения обычно говорят об ошибках. Чтобы опустошить буфера, накопившие информацию для всех открытых файлов вывода, функция exit вызывает fclose .
Инструкция главной программы return выр эквивалентна обращению к функции exit(выр) . Последняя запись (при помощи exit ) имеет то преимущество, что она пригодна для выхода и из других функций, и, кроме того, ее легко обнаружить при помощи программы контекстного поиска, похожей на ту, которую мы рассматривали в гл. 5.
Функция ferror выдает ненулевое значение, если в файле fp была обнаружена ошибка.
Хотя при выводе редко возникают ошибки, все же они встречаются (например, оказался переполненным диск); поэтому в программах широкого пользования они должны тщательно контролироваться.
Функция feof(FILE *) аналогична функции ferror ; она возвращает ненулевое значение, если встретился конец указанного в аргументе файла.
В наших небольших иллюстративных программах мы не заботились о выдаче статуса выхода, т.е. выдаче некоторого числа, характеризующего состояние программы в момент завершения: работа закончилась нормально или прервана из-за ошибки? Если работа прервана в результате ошибки, то какой? Любая серьезная программа должна выдавать статус выхода.
7.7. Ввод–вывод строк
В стандартной библиотеке имеется программа ввода fgets , аналогичная программе getline , которой мы пользовались в предыдущих главах.
Функция fgets читает следующую строку ввода (включая и литеру новая_строка) из файла fp в массив литер line , причем она может прочитать не более maxline-1 литер. Переписанная строка дополняется литерой ‘\0’ . Обычно fgets возвращает line , а по исчерпании файла или в случае ошибки — NULL . (Наша getline возвращала длину строки, которой мы потом пользовались, и нуль по концу файла.)
Функция вывода fputs пишет стринг (который может и не заканчиваться литерой новая_строка) в файл.
Эта функция возвращает EOF , если возникла ошибка, и нуль в противном случае.
Библиотечные функции gets и puts подобны функциям fgets и fputs . Отличаются они тем, что оперируют только стандартными файлами stdin и stdout , и, кроме того, gets выбрасывает последнюю литеру ‘\n’ , а puts ее добавляет.
Чтобы показать, что ничего особенного в функциях типа fgets и fputs нет, мы приводим их здесь в том виде, в каком они существуют в стандартной библиотеке на нашей системе.
Упражнение 7.6.
Напишите программу, сравнивающую два файла и печатающую первую строку, в которой они различаются.
Упражнение 7.7.
Модифицируйте программу поиска по образцу из гл. 5 таким образом, чтобы она брала текст из множества именованных файлов, а если имен файлов в аргументах нет, то — из стандартного ввода. Следует ли печатать имя файла, в котором найдена подходящая строка?
Упражнение 7.8.
Напишите программу, печатающую несколько файлов. Каждый файл должен начинаться с новой страницы, предваряться заголовком и иметь свою нумерацию страниц.
7.8. Другие библиотечные функции
В стандартной библиотеке представлен широкий спектр различных функций. Настоящий раздел содержит краткий обзор наиболее полезных из них. Более подробно эти и другие функции описаны в приложении B.
7.8.1. Операции со стрингами
Мы уже упоминали функции strlen , strcpy , strcat и strcmp , описание которых даны в <string.h> . Далее, до конца подраздела, предполагается, что s и t имеют тип char * , c и n — тип int .
| strcat(s, t) | конкатенирует t в конец s |
| strncat(s, t, n) | конкатенирует n литер t в конец s |
| strcmp(s, t) | возвращает отрицательное число, нуль или положительное число для s < t , s == t или s > t соответственно |
| strncmp(s, t, n) | делает то же, что и strcmp , но количество сравниваемых литер не может превышать n |
| strcpy(s, t) | копирует t в s |
| strncpy(s, t, n) | копирует не более n литер t в s |
| strlen(s) | возвращает длину s |
| strchr(s, c) | возвращает указатель на первое появление литеры c в s или, если c нет в s , NULL |
| strrchr(s, c) | возвращает указатель на последнее появление литеры c в s или, если c нет в s , NULL |
7.8.2. Анализ класса литер и преобразование литер
Несколько функций из библиотеки <ctype.h> выполняют проверки и преобразование литер. Далее, до конца подраздела, переменная c — это переменная типа int , которая может быть представлена значением unsigned char или EOF . Функции возвращают значения типа int .
| isalpha(c) | не нуль, если c — буква; 0 в противном случае |
| isupper(c) | не нуль, если c — буква верхнего регистра; 0 в противном случае |
| islower(c) | не нуль, если c — буква нижнего регистра; 0 в противном случае |
| isdigit(c) | не нуль, если c — цифра; 0 в противном случае |
| isalnum(c) | не нуль, если или isalpha(c) , или isdigit(c) истинны; 0 в противном случае |
| isspace(c) | не нуль, если c — литера пробела, табуляции, новой_строки, возврата_каретки, перевода_страницы, вертикальной_табуляции |
| toupper(c) | возвращает c , приведенную к верхнему регистру |
| tolower(c) | возвращает c , приведенную к нижнему регистру |
7.8.3. Функция ungetc
В стандартной библиотеке содержится более ограниченная версия функции ugetch по сравнению с той, которую мы написали в гл. 4. Называется она ungetc . Эта функция, имеющая прототип
отправляет литеру c назад в файл fp и возвращает c или EOF , в случае ошибки. Для каждого файла гарантирован возврат не более одной литеры. Функцию ungetc можно использовать совместно с любой из функций ввода типа scanf , getc , getchar и т.д.
7.8.4. Исполнение команд операционной системы
Функция system(char *s) выполняет команду системы, содержащуюся в стринге s , и затем возвращается к выполнению текущей программы. Содержимое s , строго говоря, зависит от конкретной операционной системы. Рассмотрим простой пример: в системе UNIX инструкция
вызовет программу date , которая направит дату и время в стандартный вывод. Функция возвращает зависящий от системы статус выполненной команды. В системе UNIX возвращаемый статус — это значение, переданное функцией exit .
7.8.5. Управление памятью
Функции malloc и calloc получают динамически запрашиваемые ими области памяти. Функция malloc с прототипом
возвращает указатель на n байт неинициализированной памяти или NULL , если запрос удовлетворить нельзя. Функция calloc с прототипом
возвращает указатель на область, достаточную для хранения массива из n объектов указанного размера ( size ), или NULL , если запрос не удается удовлетворить. Выделенная память обнуляется.
Указатель, возвращаемый функциями malloc и calloc , будет выдан с учетом выравнивания, выполненного согласно указанному типу объекта. Тем не менее к нему должна быть применена операция приведения к соответствующему типу, как это сделано в следующем фрагменте программы:
Функция free(p) освобождает область памяти, на которую указывает p , — указатель, первоначально полученный с помощью malloc или calloc . Никаких ограничений на порядок, в котором будет освобождаться память, нет, но ужасной ошибкой считается освобождение тех областей, которые не были получены при помощи calloc или malloc .
Нельзя также использовать те области памяти, которые уже освобождены. Следующий пример демонстрирует типичную ошибку в цикле, освобождающем элементы списка.
Правильным будет, если вы до освобождения сохраните то, что вам потребуется, как в следующем цикле:
В разд. 8.7 мы рассмотрим реализацию программы управления памятью типа malloc , позволяющую освобождать выделенные блоки памяти в любой последовательности.
7.8.6. Математические функции
В <math.h> описано более двадцати математических функций. Здесь же приведены наиболее употребительные. Каждая из них имеет один или два аргумента типа double и возвращает результат также типа double .
| sin(x) | синус x , x в радианах |
| cos(x) | косинус x , x в радианах |
| atan2(y, x) | арктангенс y/x , y/x в радианах |
| exp(x) | экспоненциальная функция e x |
| log(x) | натуральный (по основанию e) логарифм x ( x > 0 ) |
| log10(x) | обычный (по основанию 10) логарифм x ( x > 0 ) |
| pow(x, y) | x y |
| sqrt(x) | корень квадратный x (x >= 0) |
| fabs(x) | абсолютное значение x |
7.8.7. Генератор случайных чисел
Функция rand() вычисляет последовательность псевдослучайных целых в диапазоне от нуля до значения, заданного именованной константой RAMD_MAX , которая определена в <stdlib.h> . Привести случайные числа к значениям с плавающей точкой, большим или равным 0 и меньшим 1 , можно по формуле
(Если в вашей библиотеке уже есть функция для получения случайных чисел с плавающей точкой, вполне возможно, что ее статистические характеристики лучше указанной.)
Функция srand(unsigned) осуществляет «начальную затравку» для rand . Реализации rand и srand , предлагаемые стандартом и, следовательно, переносимые на различные машины, рассмотрены в разд. 2.7.
Упражнение 7.9.
Реализуя функции типа isupper , можно либо экономить память, либо время. Напишите оба варианта функции.
How to send EOF via Windows terminal
I’m trying to comprehend Example 1.9 from the K&R book, but I don’t get how to send EOF. Some sources mentioned Ctr+Z, but that simply terminates the program. I somehow managed to send EOF with a combination of Enter and Ctrl+Z and maybe Ctrl+V, but I can’t reproduce it.
3 Answers 3
You can simulate EOF with CTRL+D (for *nix) or CTRL+Z then Enter (for Windows) from command line.

In widows, when you are ready to complete the input, press the Enter key and then press Ctrl+Z and then Enter to complete the input.

In the end, it can’t be done easily on Windows given the simple K&R code which was meant for Unix-like systems. You can send ‘^Z^M’ (Ctrl-Z and then Enter) to send Windows equivalent of EOF but the char ‘EOF’ you are checking for in this C program is not the same.
Short answer: you can’t.

-
The Overflow Blog
Linked
Related
Hot Network Questions
Subscribe to RSS
To subscribe to this RSS feed, copy and paste this URL into your RSS reader.
Site design / logo © 2023 Stack Exchange Inc; user contributions licensed under CC BY-SA . rev 2023.3.3.43278
By clicking “Accept all cookies”, you agree Stack Exchange can store cookies on your device and disclose information in accordance with our Cookie Policy.
EOF — это не символ
Недавно я читал книгу «Компьютерные системы: архитектура и программирование. Взгляд программиста». Там, в главе про систему ввода-вывода Unix, авторы упомянули о том, что в конце файла нет особого символа EOF .
Если вы читали о системе ввода-вывода Unix/Linux, или экспериментировали с ней, если писали программы на C, которые читают данные из файлов, то это заявление вам, вероятно, покажется совершенно очевидным. Но давайте поближе присмотримся к следующим двум утверждениям, относящимся к тому, что я нашёл в книге:
- EOF — это не символ.
- В конце файлов нет некоего особого символа.
EOF — это не символ
Почему кто-то говорит или думает, что EOF — это символ? Полагаю, это может быть так из-за того, что в некоторых программах, написанных на C, можно найти код, в котором используется явная проверка на EOF с использованием функций getchar() и getc() .
Это может выглядеть так:
Если заглянуть в справку по getchar() или getc() , можно узнать, что обе функции считывают следующий символ из потока ввода. Вероятно — именно это является причиной возникновения заблуждения о природе EOF . Но это — лишь мои предположения. Вернёмся к мысли о том, что EOF — это не символ.
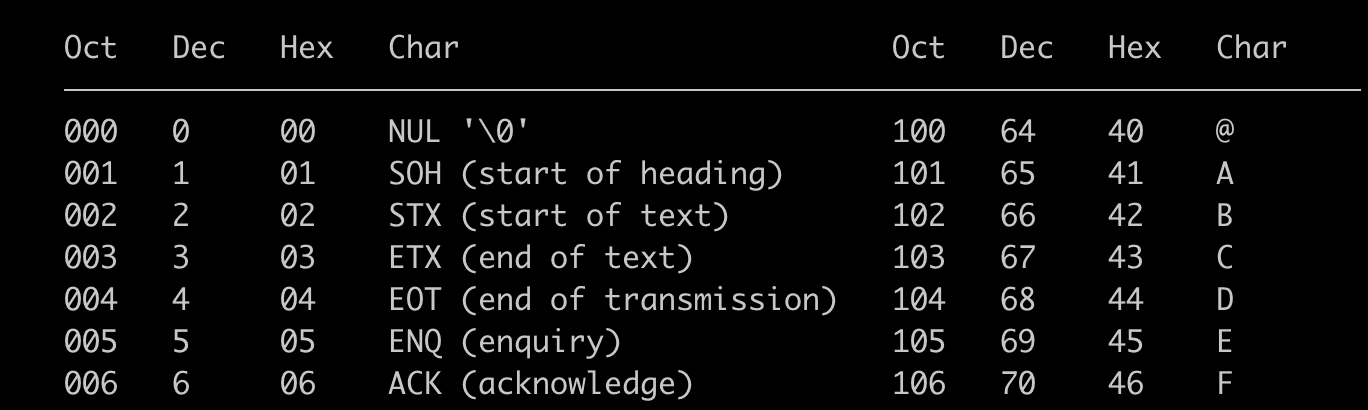
А что такое, вообще, символ? Символ — это самый маленький компонент текста. «A», «a», «B», «b» — всё это — разные символы. У символа есть числовой код, который в стандарте Unicode называют кодовой точкой. Например — латинская буква «A» имеет, в десятичном представлении, код 65. Это можно быстро проверить, воспользовавшись командной строкой интерпретатора Python:
Или можно взглянуть на таблицу ASCII в Unix/Linux:
Выясним, какой код соответствует EOF , написав небольшую программу на C. В ANSI C константа EOF определена в stdio.h , она является частью стандартной библиотеки. Обычно в эту константу записано -1 . Можете сохранить следующий код в файле printeof.c , скомпилировать его и запустить:
Скомпилируем и запустим программу:
У меня эта программа, проверенная на Mac OS и на Ubuntu, сообщает о том, что EOF равняется -1 . Есть ли какой-нибудь символ с таким кодом? Тут, опять же, можно проверить коды символов в таблице ASCII, можно взглянуть на таблицу Unicode и узнать о том, в каком диапазоне могут находиться коды символов. Мы же поступим иначе: запустим интерпретатор Python и воспользуемся стандартной функцией chr() для того, чтобы она дала бы нам символ, соответствующий коду -1 :
Как и ожидалось, символа с кодом -1 не существует. Значит, в итоге, EOF , и правда, символом не является. Переходим теперь ко второму рассматриваемому утверждению.
В конце файлов нет некоего особого символа
Может, EOF — это особенный символ, который можно обнаружить в конце файла? Полагаю, сейчас вы уже знаете ответ. Но давайте тщательно проверим наше предположение.
Возьмём простой текстовый файл, helloworld.txt, и выведем его содержимое в шестнадцатеричном представлении. Для этого можно воспользоваться командой xxd :
Как видите, последний символ файла имеет код 0a . Из таблицы ASCII можно узнать о том, что этот код соответствует символу nl , то есть — символу новой строки. Это можно выяснить и воспользовавшись Python:
Так. EOF — это не символ, а в конце файлов нет некоего особого символа. Что же такое EOF ?
Что такое EOF?
EOF (end-of-file) — это состояние, которое может быть обнаружено приложением в ситуации, когда операция чтения файла доходит до его конца.
Взглянем на то, как можно обнаруживать состояние EOF в разных языках программирования при чтении текстового файла с использованием высокоуровневых средств ввода-вывода, предоставляемых этими языками. Для этого напишем очень простую версию cat , которая будет называться mcat . Она побайтно (посимвольно) читает ASCII-текст и в явном виде выполняет проверку на EOF . Программу напишем на следующих языках:
- ANSI C
- Python 3
- Go
- JavaScript (Node.js)
ANSI C
Начнём с почтенного C. Представленная здесь программа является модифицированной версией cat из книги «Язык программирования C».
Вот некоторые пояснения, касающиеся вышеприведённого кода:
- Программа открывает файл, переданный ей в виде аргумента командной строки.
- В цикле while осуществляется копирование данных из файла в стандартный поток вывода. Данные копируются побайтово, происходит это до тех пор, пока не будет достигнут конец файла.
- Когда программа доходит до EOF , она закрывает файл и завершает работу.
Python 3
В Python нет механизма явной проверки на EOF , похожего на тот, который имеется в ANSI C. Но если посимвольно читать файл, то можно выявить состояние EOF в том случае, если в переменной, хранящей очередной прочитанный символ, будет пусто:
Запустим программу и взглянём на возвращаемые ей результаты:
Вот более короткая версия этого же примера, написанная на Python 3.8+. Здесь используется оператор := (его называют «оператор walrus» или «моржовый оператор»):
Запустим этот код:
В Go можно явным образом проверить ошибку, возвращённую Read(), на предмет того, не указывает ли она на то, что мы добрались до конца файла:
JavaScript (Node.js)
В среде Node.js нет механизма для явной проверки на EOF . Но, когда при достижении конца файла делается попытка ещё что-то прочитать, вызывается событие потока end.
Низкоуровневые системные механизмы
Как высокоуровневые механизмы ввода-вывода, использованные в вышеприведённых примерах, определяют достижение конца файла? В Linux эти механизмы прямо или косвенно используют системный вызов read(), предоставляемый ядром. Функция (или макрос) getc() из C, например, использует системный вызов read() и возвращает EOF в том случае, если read() указывает на возникновение состояния достижения конца файла. В этом случае read() возвращает 0 . Если изобразить всё это в виде схемы, то получится следующее:
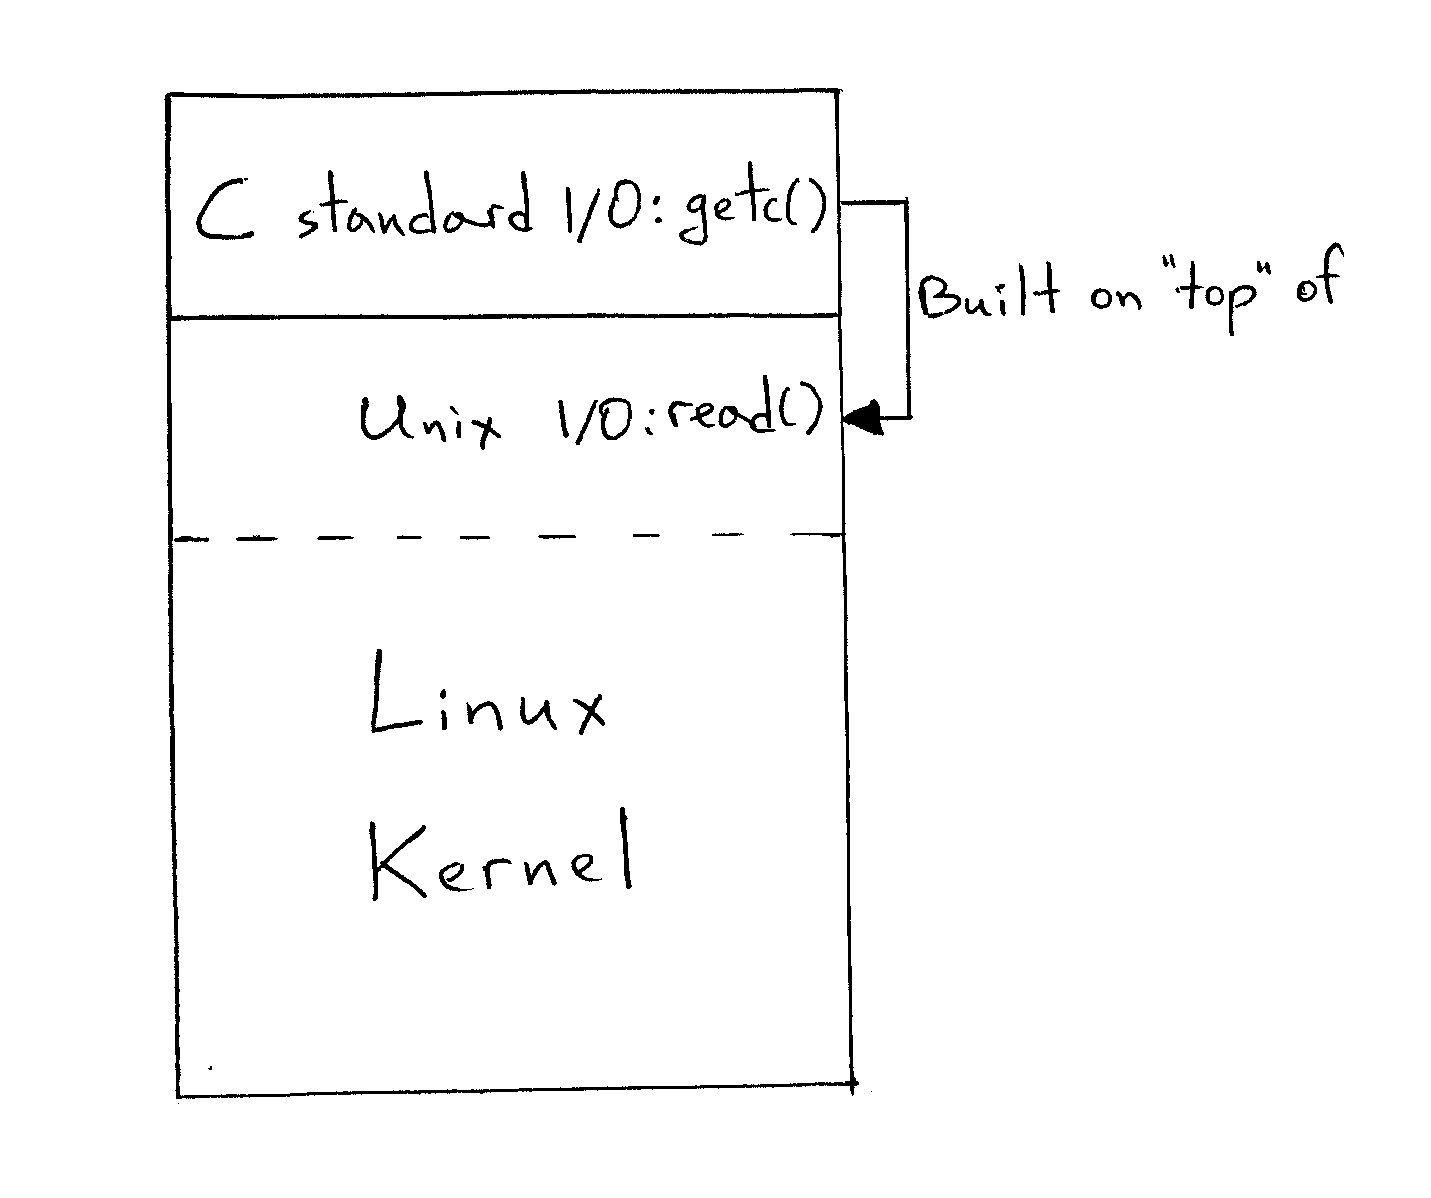
Получается, что функция getc() основана на read() .
Напишем версию cat , названную syscat , используя только системные вызовы Unix. Сделаем мы это не только из интереса, но и из-за того, что это вполне может принести нам какую-то пользу.
Вот эта программа, написанная на C:
В этом коде используется тот факт, что функция read() , указывая на достижение конца файла, возвращает 0 .
Работа с текстовыми файлами
Р абота с текстовым файлом похожа работу с консолью: с помощью функций форматированного ввода мы сохраняем данные в файл, с помощью функций форматированного вывода считываем данные из файла. Есть множество нюансов, которые мы позже рассмотрим. Основные операции, которые необходимо проделать, это
- 1. Открыть файл, для того, чтобы к нему можно было обращаться. Соответственно, открывать можно для чтения, записи, чтения и записи, переписывания или записи в конец файла и т.п. Когда вы открываете файл, может также произойти куча ошибок – файла может не существовать, это может быть файл не того типа, у вас может не быть прав на работу с файлом и т.д. Всё это необходимо учитывать.
- 2. Непосредственно работа с файлом — запись и чтение. Здесь также нужно помнить, что мы работаем не с памятью с произвольным доступом, а с буферизированным потоком, что добавляет свою специфику.
- 3. Закрыть файл. Так как файл является внешним по отношению к программе ресурсом, то если его не закрыть, то он продолжит висеть в памяти, возможно, даже после закрытия программы (например, нельзя будет удалить открытый файл или внести изменения и т.п.). Кроме того, иногда необходимо не закрывать, а «переоткрывать» файл для того, чтобы, например, изменить режим доступа.
Кроме того, существует ряд задач, когда нам не нужно обращаться к содержимому файла: переименование, перемещение, копирование и т.д. К сожалению, в стандарте си нет описания функций для этих нужд. Они, безусловно, имеются для каждой из реализаций компилятора. Считывание содержимого каталога (папки, директории) – это тоже обращение к файлу, потому что папка сама по себе является файлом с метаинформацией.
Иногда необходимо выполнять некоторые вспомогательные операции: переместиться в нужное место файла, запомнить текущее положение, определить длину файла и т.д.
Для работы с файлом необходим объект FILE. Этот объект хранит идентификатор файлового потока и информацию, которая нужна, чтобы им управлять, включая указатель на его буфер, индикатор позиции в файле и индикаторы состояния.
Объект FILE сам по себе является структурой, но к его полям не должно быть доступа. Переносимая программа должна работать с файлом как с абстрактным объектом, позволяющим получить доступ до файлового потока.
Создание и выделение памяти под объект типа FILE осуществляется с помощью функции fopen или tmpfile (есть и другие, но мы остановимся только на этих).
Функция fopen открывает файл. Она получает два аргумента – строку с адресом файла и строку с режимом доступа к файлу. Имя файла может быть как абсолютным, так и относительным. fopen возвращает указатель на объект FILE, с помощью которого далее можно осуществлять доступ к файлу.
Например, откроем файл и запишем в него Hello World
Функция fopen сама выделяет память под объект, очистка проводится функцией fclose. Закрывать файл обязательно, самостоятельно он не закроется.
Функция fopen может открывать файл в текстовом или бинарном режиме. По умолчанию используется текстовый. Режим доступа может быть следующим
| Тип | Описание |
|---|---|
| r | Чтение. Файл должен существовать. |
| w | Запись нового файла. Если файл с таким именем уже существует, то его содержимое будет потеряно. |
| a | Запись в конец файла. Операции позиционирования (fseek, fsetpos, frewind) игнорируются. Файл создаётся, если не существовал. |
| r+ | Чтение и обновление. Можно как читать, так и писать. Файл должен существовать. |
| w+ | Запись и обновление. Создаётся новый файл. Если файл с таким именем уже существует, то его содержимое будет потеряно. Можно как писать, так и читать. |
| a+ | Запись в конец и обновление. Операции позиционирования работают только для чтения, для записи игнорируются. Если файл не существовал, то будет создан новый. |
Если необходимо открыть файл в бинарном режиме, то в конец строки добавляется буква b, например “rb”, “wb”, “ab”, или, для смешанного режима “ab+”, “wb+”, “ab+”. Вместо b можно добавлять букву t, тогда файл будет открываться в текстовом режиме. Это зависит от реализации. В новом стандарте си (2011) буква x означает, что функция fopen должна завершиться с ошибкой, если файл уже существует. Дополним нашу старую программу: заново откроем файл и считаем, что мы туда записали.
Вместо функции fgets можно было использовать fscanf, но нужно помнить, что она может считать строку только до первого пробела.
fscanf(file, «%127s», buffer);
Также, вместо того, чтобы открывать и закрывать файл можно воспользоваться функцией freopen, которая «переоткрывает» файл с новыми правами доступа.
Функции fprintf и fscanf отличаются от printf и scanf только тем, что принимают в качестве первого аргумента указатель на FILE, в который они будут выводить или из которого они будут читать данные. Здесь стоит сразу же добавить, что функции printf и scanf могут быть без проблем заменены функциями fprintf и fscanf. В ОС (мы рассматриваем самые распространённые и адекватные операционные системы) существует три стандартных потока: стандартный поток вывода stdout, стандартный поток ввода stdin и стандартный поток вывода ошибок stderr. Они автоматически открываются во время запуска приложения и связаны с консолью. Пример
Ошибка открытия файла
Если вызов функции fopen прошёл неудачно, то она возвратит NULL. Ошибки во время работы с файлами встречаются достаточно часто, поэтому каждый раз, когда мы окрываем файл, необходимо проверять результат работы
Проблему вызывает случай, когда открывается сразу несколько файлов: если один из них нельзя открыть, то остальные также должны быть закрыты
В простых случаях можно действовать влоб, как в предыдущем куске кода. В более сложных случаях используются методы, подменяющиее RAII из С++: обёртки, или особенности компилятора (cleanup в GCC) и т.п.
Буферизация данных
- 1) Если он заполнен
- 2) Если поток закрывается
- 3) Если мы явно указываем, что необходимо очистить буфер (здесь тоже есть исключения:)).
- 4) Также очищается, если программа завершилась удачно. Вместе с этим закрываются и все файлы. В случае ошибки выполнения этого может не произойти.
Форсировать выгрузку буфера можно с помощью вызова функции fflush(File *). Рассмотрим два примера – с очисткой и без.
Раскомментируйте вызов fflush. Во время выполнения откройте текстовый файл и посмотрите на поведение.
Буфер файла можно назначить самостоятельно, задав свой размер. Делается это при помощи функции
которая принимает уже открытый FILE и указатель на новый буфер. Размер нового буфера должен быть не меньше чем BUFSIZ (к примеру, на текущей рабочей станции BUFSIZ равен 512 байт). Если передать в качестве буфера NULL, то поток станет небуферизированным. Можно также воспользоваться функцией
- _IOFBF — полная буферизация. Данные записываются в файл, когда он заполняется. На считывание, буфер считается заполненным, когда запрашивается операция ввода и буфер пуст.
- _IOLBF — линейная буферизация. Данные записываются в файл когда он заполняется, либо когда встречается символ новой строки. На считывание, буфер заполняется до символа новой строки, когда запрашивается операция ввода и буфер пуст.
- _IONBF – без буферизации. В этом случае параметры size и buffer игнорируются.
Пример: зададим свой буфер и посмотрим, как осуществляется чтение из файла. Пусть файл короткий (что-нибудь, типа Hello, World!), и считываем мы его посимвольно
Видно, что данные уже находятся в буфере. Считывание посимвольно производится уже из буфера.
Функция int feof (FILE * stream); возвращает истину, если конец файла достигнут. Функцию удобно использовать, когда необходимо пройти весь файл от начала до конца. Пусть есть файл с текстовым содержимым text.txt. Считаем посимвольно файл и выведем на экран.
Всё бы ничего, только функция feof работает неправильно. Это связано с тем, что понятие «конец файла» не определено. При использовании feof часто возникает ошибка, когда последние считанные данные выводятся два раза. Это связано с тем, что данные записывается в буфер ввода, последнее считывание происходит с ошибкой и функция возвращает старое считанное значение.
Этот пример сработает с ошибкой (скорее всего) и выведет последний символ файла два раза.
Решение – не использовать feof. Например, хранить общее количество записей или использовать тот факт, что функции fscanf и пр. обычно возвращают число верно считанных и сопоставленных значений.
Примеры
1. В одном файле записаны два числа — размерности массива. Заполним второй файл массивом случайных чисел.
2. Пользователь копирует файл, при этом сначала выбирает режим работы: файл может выводиться как на консоль, так и копироваться в новый файл.
3. Пользователь вводит данные с консоли и они записываются в файл до тех пор, пока не будет нажата клавиша esc. Проверьте программу и посмотрите. как она себя ведёт в случае, если вы вводите backspace: что выводится в файл и что выводится на консоль.
4. В файле записаны целые числа. Найти максимальное из них. Воспользуемся тем, что функция fscanf возвращает число верно прочитанных и сопоставленных объектов. Каждый раз должно возвращаться число 1.
Другое решение считывать числа, пока не дойдём до конца файла.
5. В файле записаны слова: русское слово, табуляция, английское слово, в несколько рядов. Пользователь вводит английское слово, необходимо вывести русское.
Файл с переводом выглядит примерно так
солнце sun
карандаш pen
шариковая ручка pencil
дверь door
окно windows
стул chair
кресло armchair
и сохранён в кодировке cp866 (OEM 866). При этом важно: последняя пара cлов также заканчивается переводом строки.
Алгоритм следующий — считываем строку из файла, находим в строке знак табуляции, подменяем знак табуляции нулём, копируем русское слово из буфера, копируем английское слово из буфера, проверяем на равенство.
6. Подсчитать количество строк в файле. Будем считывать файл посимвольно, считая количество символов ‘\n’ до тех пор, пока не встретим символ EOF. EOF – это спецсимвол, который указывает на то, что ввод закончен и больше нет данных для чтения. Функция возвращает отрицательное значение в случае ошибки.
ЗАМЕЧАНИЕ: EOF имеет тип int, поэтому нужно использовать int для считывания символов. Кроме того, значение EOF не определено стандартом.

Всё ещё не понятно? – пиши вопросы на ящик