На чем написан Linux?
Linux. Linux также написан в основном на C, с некоторыми частями сборки. Около 97 процентов из 500 самых мощных суперкомпьютеров в мире работают под управлением ядра Linux. Он также используется во многих персональных компьютерах.
Linux написан на Python?
Linux (ядро) по сути написан на C с небольшим ассемблером. … Оставшаяся часть пользовательского пространства дистрибутивов Gnu / Linux написана на любом языке, который разработчики решат использовать (все еще много C и оболочки, но также C ++, python, perl, javascript, java, C #, golang, что угодно…)
Linux написан на C ++?
Поэтому C ++ по определению не самый подходящий язык для этого модуля ядра Linux. … Настоящий программист может писать на любом языке код на любом языке. Хорошими примерами являются реализация процедурного программирования на языке ассемблера и ООП на C (оба из которых широко представлены в ядре Linux).
Ubuntu написан на Python?
Ubuntu упрощает запуск, поскольку поставляется с предустановленной версией командной строки. Фактически, сообщество Ubuntu разрабатывает многие из своих скриптов и инструментов под Python.
На каком языке написана ОС?
C — это язык программирования, наиболее часто используемый и рекомендуемый для написания операционных систем. По этой причине мы рекомендуем изучить и использовать C для разработки ОС. Однако можно использовать и другие языки, такие как C ++ и Python.
На каком языке работает Linux?
Linux. Linux также написан в основном на C, с некоторыми частями сборки. Около 97 процентов из 500 самых мощных суперкомпьютеров в мире работают под управлением ядра Linux. Он также используется во многих персональных компьютерах.
Linux — это кодировка?
Linux, как и его предшественник Unix, является ядром операционной системы с открытым исходным кодом. Поскольку Linux защищен общественной лицензией GNU, многие пользователи имитировали и изменяли исходный код Linux. Программирование для Linux совместимо с C ++, Perl, Java и другими языками программирования.
C все еще используется в 2020 году?
Наконец, статистика GitHub показывает, что и C, и C ++ являются лучшими языками программирования для использования в 2020 году, поскольку они по-прежнему входят в первую десятку списка. Так что ответ — НЕТ. C ++ по-прежнему остается одним из самых популярных языков программирования.
Почему C более популярен, чем C ++?
Самая большая практическая причина для предпочтения C заключается в том, что поддержка более распространена, чем C ++. Есть много платформ, особенно встроенных, на которых даже нет компиляторов C ++. Также существует вопрос совместимости для поставщиков.
Windows написана на C или C ++?
Для тех, кто заботится о таких вещах: многие спрашивают, написана ли Windows на C или C ++. Ответ заключается в том, что, несмотря на объектно-ориентированный дизайн NT, как и большинство операционных систем, Windows почти полностью написана на языке C. Почему? C ++ требует затрат с точки зрения занимаемой памяти и накладных расходов на выполнение кода.
Какой язык программирования использует Ubuntu?
Ядро Linux, сердце операционной системы Ubuntu, написано на C. C ++ в основном является расширением C. C ++ имеет главное преимущество — он является объектно-ориентированным языком.
Как запустить Python в терминале Linux?
Откройте терминал, выполнив поиск на панели инструментов или нажав Ctrl + Alt + T. Переместите терминал в каталог, где находится сценарий, с помощью команды cd. Введите python SCRIPTNAME.py в терминале, чтобы выполнить сценарий.
Как мне запустить Python?
Выполните следующие шаги, чтобы запустить Python на вашем компьютере.
- Загрузите Thonny IDE.
- Запустите установщик, чтобы установить Thonny на свой компьютер.
- Перейдите в: Файл> Создать. Затем сохраните файл с расширением. …
- Напишите код Python в файл и сохраните его. Запуск Python с использованием Thonny IDE.
- Затем выберите «Выполнить»> «Выполнить текущий сценарий» или просто нажмите F5, чтобы запустить его.
Python написан на C?
Python написан на C (на самом деле реализация по умолчанию называется CPython). Python написан на английском языке. Но есть несколько реализаций:… CPython (написано на C)
Написана ли Java на C?
Самый первый компилятор Java был разработан Sun Microsystems и был написан на C с использованием некоторых библиотек из C ++. Сегодня компилятор Java написан на Java, а JRE — на C.
Почему Linux написан на C?
В основном причина философская. C был изобретен как простой язык для разработки систем (не столько для разработки приложений). … Большинство приложений написано на C, потому что большая часть информации о ядре написана на C. И поскольку тогда большинство вещей было написано на C, люди склонны использовать исходные языки.
Анатомия GNU/Linux
Какое-то время назад на Хабре была небольшая волна постов на тему «Почему я [не] выбрал Linux». Как порядочный фанатик я стриггерился, однако решил, что продуктивнее что-нибудь рассказать о своей любимой системе, чем ломать копии в комментариях.
У меня сложилось впечатление, что многие пользователи GNU/Linux слабо представляют, из чего сделана эта операционная система, поэтому утверждают, что она сляпана из попавшихся под руку кусков. В то же время, архитектура большинства дистрибутивов является устоявшейся и регламентируется рядом стандартов, включая стандарт графического окружения freedesktop.org и Linux Standard Base, расширяющий стандарты Unix. Мне при знакомстве с GNU/Linux несколько лет назад для погружения не хватало простой анатомической карты типичного дистрибутива, поэтому я попробую рассказать об этом сам.
Загрузчик
Сеанс операционной системы начинается с загрузчика, как театр с вешалки. Дефолтным загрузчиком сегодня является GNU GRUB, известный так же как GRUB 2. По-прежнему доступна первая ветка, называемая теперь «GRUB Legacy». Другой загрузчик с давней историей — Syslinux.
Задача загрузчика — инициализировать ядро Linux. Для этого, в общем случае, нужно знать, где ядро лежит, и уметь прочитать это место (раздел Ext4, скажем). Ядру в помощь загрузчик обычно так же подтягивает начальный образ загрузки, о котором скажем позже. GRUB умеет много прочего, типа построения весьма сложных меню и чейнлоадинга других загрузчиков (Windows Boot Manager например). GRUB имеет конфигурационный синтаксис, отдалённо напоминающий шелл, и расширяется модулями.
GRUB велик и могуч, порой даже слишком, и встраиваемые системы часто используют компактный Das U-Boot.
Могучий Linux («не оставляй нас, монолит!»). Ядро операционной системы, созданное, чтобы работать с POSIX-совместимыми окружениями. Обычно лежит в /boot/ и содержит в названии слово vmlinuz , где «vm» напоминает нам о поддержке виртуальной памяти, а «z» указывает, что файл сжат.
В рамках одного дистрибутива может поддерживаться несколько вариантов ядра, например:
mainline («основное»);
LTS (с расширенной поддержкой);
rt (патченное для поддержки исполнения в режиме реального времени);
с различными патчами для повышения производительности или защищённости (zen, hardened etc);
libre (почищенное от проприетарных блобов ядро, ожидаемо поддерживающее мало оборудования).
совсем экзотичные варианты с не-Linux ядром типа Debian GNU/Hurd (с ядром GNU Hurd) и Debian GNU/kFreeBSD (с ядром FreeBSD соответственно). Это уже, конечно, не GNU/Linux.
Начальный образ загрузки
Начальный образ загрузки известен так же как initrd и initramfs. Представляет собой архив с образом файловой системы, развёртываемой в оперативную память в начале процесса загрузки. Несёт в себе различные драйверы и скрипты, позволяющие инициализировать оборудование и смонтировать файловые системы.
Содержимое начального образа загрузки зависит от версии ядра и потребностей пользователя (кто-то использует ZFS, а у кого-то корень зашифрован LUKS). Поэтому образ не поставляется в дистрибутивах. В дистрибутивах поставляются фреймворки для создания начальных образов по мере необходимости. Так, обычно создание свежего образа инициируется при обновлении ядра. Вот несколько популярных фреймворков:
initramfs-tools — детище Debian.
Dracut (произносится созвучно с сушёной кошкой) — в RHEL и производных (CentOS, Scientific Linux etc.). Наиболее гибкий и современный инструмент из перечисленных, если спросите меня.
mkinitcpio поставляется в Archlinux, хотя мейнтейнеры подумывают о Dracut, который уже включён в репозиторий и установочные образы.
make-initrd — свой путь у замечательного отечественного дистрибутива Alt Linux.
Тут же упомянем Plymouth, размещаемый в начальном образе. Это заставка (сплэш-скрин), позволяющая заменить вывод ядра при загрузке на произвольную анимированную картинку, например логотип дистрибутива, что принято в «дружелюбных к пользователю»™ дистрибутивах типа Ubuntu и Fedora.
Система инициализации — это пастырь процессов. Она стартует раньше всех и имеет PID 1. Она определяет уровень запуска системы и жизненный цикл большинства служб. Независмо от того, что за система инициализации представлена, она предлагает исполняемые файлы /sbin/init (или /usr/bin/init , или в том же духе, ну вы поняли).
Холиварный элемент. Много лет с нами была Sysvinit, пришедшая из варианта ОС Unix System V. Sysvinit полагалась в огромной степени на скрипты инициализации. Служил этот инит, в общем, исправно, но постепенно некоторым инженерам стало мозолить глаза последовательное исполнение скриптов и собственно скрипты, известные в жарких спорах за свою распростёртость как «баш-портянки». В конце 00-ых-начале 10-ых как грибы после дождя расплодились альтернативные системы инициализации: OpenRC от Gentoo, Upstart от Canonical, Systemd от Red Hat за авторством Леннарта Поттеринга. В конце концов по причинам техническим и политическим всех сожрала Systemd. Её восхваляют и ненавидят. Восхваляют в основном за простой и лаконичный синтаксис служб. Так, скрипт запуска веб-сервера Apache для классического инита занимает 153 строки включая комментарии, а файл службы из пакета apache в Arch Linux — 15 строк. Недолюбливают в основном за то, что эта система инициализации подрабатывает ещё и резолвером, планировщиком, менеджером сети, менеджером монтирования и Бог весть ещё чем, попирая дзен Unix.
Командная оболочка
Командная оболочка, она же командный интерпретатор или просто шелл. Неискушённый пользователь скажет — «в гробу я этот шелл видал, можно в графическом режиме жить», и будет неправ, поскольку шелл прописан в стандарте POSIX и необходим для работоспособности системы. Есть понятие «оболочка входа» (login shell) — это первый процесс, запускамый при входе пользователя. Он подтягивает опции и переменные окружения из конфигурационных файлов, все последующие процессы запускаются в контексте этого шелла. Что будет запущено в качестве оболочки входа, определяется в /etc/passwd .
Наиболее распространены сегодня следующие оболочки:
Bourne shell (sh) — «тот самый шелл», сложно найти дистрибутив без него.
Bourne again shell (bash) — принят по умолчанию в качестве пользователькой оболочки в большинстве GNU/Linux дистрибутивов и предлагает ряд удобств по сравнению с sh.
Debian Almquist shell (dash) — компактная облочка, совместимая с sh. Традиционно используется в Debian, где /usr/bin/sh на неё ссылается.
Z shell (zsh) — похож на bash, но предлагает оригинальные фишечки для интерактивного ввода. Редко идёт из коробки, но обычно поставляется в репозитории.
BusyBox — утилита для встраиваемых систем, которая предоставляет целое пользовательское окружение, в том числе — POSIX-совместимый шелл (вызывается так: $ busybox sh ).
Графический сервер
Демон, отвечающий за отрисовку окошек. Золотой стандарт графического сервера — X Window System с нами аж с 1984 года. Это именно стандарт, архитектура и набор протоколов. Реализаций за прошедшие годы была уйма, в каждой собственнической Unix-системе была своя. В GNU/Linux (и BSD) долгое время применялся Xfree86. Теперь с нами X.Org Server, или просто Xorg, он отпочковался от XFree86.
X Window System — мощная и богатая система, так, одна из возможностей — сетевая прозрачность. Вы можете запустить на своём хосте графическое приложение с другой машины, даже когда на той машине графический сервер не запущен. При помощи SSH это можно сделать, например, так (может потребоваться небольшая донастройка sshd):
Надо сказать, терминология X Window System контринтуитивна: клиентом называется графическое приложение, а сервером — отрисовывающее. На этот счёт прошлись в классической монографии «The UNIX-HATERS Handbook».
Другая возможность X, отрисовка графических примитивов и текстовых глифов, использовалась в старые времена, когда мужчины были мужчинами и рисовали окошки сами, без тулкитов.
В окружениях рабочих столов активно используется X keyboard extension, расширение, отображающее нажатие клавиш на различные раскладки.
«Иксам» пророчат скорую кончину. Именно обширность и сложность стандарта побудила разработчиков СПО начать работу над новым стандартом — протоколом Wayland. Wayland достиг определённой стадии зрелости и с переменным успехом внедряется дистрибутивами как графический сервер по умолчанию. Тем не менее, проект Wayland начат в 2008 году, а стандарт X ещё не спешит уходить с голубых экранов.

Оконный менеджер Weston
На скриншоте Weston — эталонная реализация композитного менеджера Wayland. Умеет крутить окошки. А ещё его можно запустить внутри другого рабочего стола, просто выполнив в терминале weston .
После старта графический сервер обслуживает иерархию окон. Существует понятие «корневое окно» (root window), оно, в свою очередь, «владеет» окнами панелей, приложений. Окна приложений «владеют» своими модальными окнами. Обычно обои рабочего стола отрисовываются в корневом окне.
Дисплейный менеджер
Не вполне интуитивно названные, дисплейные менеджеры (DM) рисуют для нас приветливое окошко входа в систему. Обычно, помимо ввода логина и пароля, они позволяют выбрать сессию (при наличии выбора в вашей системе) и задать язык сеанса. Дисплейные менеджеры делают плюс-минус одну и ту же нехитрую работу, их многообразие оправдано консистентностью с различными средами рабочего стола (что зависит, по большей части, от графического тулкита и утилит настройки). Можно жить без дисплейного сервера, как в старые добрые времена. Для этого потребуется настроить ваш
/.xinitrc на запуск необходимого сеанса рабочего стола. Это позволит входить через ядерную консоль и запускать рабочий стол командой startx .
 Жизнь без DM
 Жизнь c SDDM
Типичные представители дисплейных менеджеров:
GDM из набора GNOME;
SDDM из комплекта KDE;
LightDM — универсальный вариант;
FlyDM — из поставки Astra Linux.
Окружение рабочего стола
Окружения рабочего стола (DE) состоит из ряда стандартных компонентов, таких, как:
панель с треем и меню запуска приложений;
хранитель экрана, он же блокировщик экрана;
браузер, которым никто не пользуется;
почтовый клиент (у зажиточных окружений);
Два могучих окружения, GNOME и KDE, сражаются за сердца простых пользователей, а остальные массовые десктопы им завидуют нередко пользуются их наработками. Некоторые хардкорные пользователи предпочитают собирать окружение рабочего стола самостоятельно на базе оконных менеджеров типа Awesome и i3.

Оконный менеджер Window Maker
На скриншоте оконный менеджер Window Maker из состава GNUstep. GNUstep воспроизводит окружение NeXTSTEP. Поставляется в репозиториях большинства дистрибутивов.
Графические тулкиты
Графический тулкит — библиотека или фреймворк, упрощающая рисование формочек и кнопочек, причём в едином стиле. То, чем занимается Windows Forms на ОС другого производителя, а так же занимался некогда полулярный Motif на старых юниксах (Open Motif доступен поныне).
Флагманами в этой категории долгое время были и остаются GTK и Qt. GTK родился как тулкит для свободного графического редактора GIMP и позже переполз под крыло GNOME. Написан на чистом C с классами, имеет официальные байндинги к Python и C++, а ещё породил целый язык общего назначения Vala. Qt — изначально коммерческий проприетарный тулкит, сейчас является свободным ПО (но по-прежнему коммерческим). Написан на C++ с размахом, заменяя стандартную библиотеку и кучу других библиотек и предлагая метаобъектный компилятор (кодогенератор). Имеет байндинги к куче языков. KDE гордо зиждется на этом великолепии.
Графическое API
Mesa — это каркас для видеовывода. Меза предоставляет API OpenGL и, с не столь давних пор, Vulkan (и несколько других API типа VDPAU и VAAPI). Можно сказать, что Mesa берёт на себя вопросы графики, которыми обычно занимается DirectX в ОС другого производителя.
Безопасность
Обширная часть системы, и я недостаточно компетентен, чтобы в неё углубляться, тем не менее, обзорно рассмотрим.
PAM — Pluggable Authentication Modules — модульная система авторизации. Отвечает, как понятно из названия, за авторизацию пользователей в системе, причём разными способами. Через PAM авторизуются в том числе доменные пользователи, в таком случае PAM действует в связке с имплементацией Kerberos (обычно MIT’овский krb5), поскольку сам по себе PAM не работает с удалёнными клиентами. Модули представляют собой разделяемые библиотеки (исполняемые файлы с суффиксом so ) и позволяют делать интересные штуки при входе пользователя. Например, можно создавать домашнюю директорию при первом входе ( pam_mkhomedir.so ) или монтировать файловые системы ( pam_mount.so ).
Классическая утилита su и более молодая sudo предназначены для исполнения комманд от имени другого пользователя (по умолчанию root ). Наиболее значимая разница — su требует пароль пользователя, из-под которого вы хотите работать, а sudo — ваш пароль. sudo гибко настраивается, позволяя запускать только определённые команды определённым пользователям из-под других определённых пользователей, как-то так.
Менеджер авторизации Polkit позволяет непривилегированным процессам взаимодействовать с привилегированными. По сути он похож на sudo, но обладает превосходящей гибкостью и предназначен в первую очередь для приложений, в то время как sudo — утилита для пользователя. Правила пишутся, внезапно, на JavaScript’е.
Linux Security Modules (LSM) — фреймворк внутри ядра Linux, позволяющий накладывать на систему дополнительные моде́ли безопасности. Это достигается при помощи мо́дулей безопасности, не путать с модулями ядра. Наиболее популярные модули безопасности — SELinux и AppArmor. Первый явлен миру АНБ и развивается Red Hat, второй рождён в рамках ОС Immunix и сегодня развивается Canonical Ltd. Соответственно, SELinux поставляется в RHEL и производных, а AppArmor — в Ubuntu. Оба модуля имеют сходное назначение и привносят в систему мандатное управление доступом. Оба модуля повышают безопасность системы, не позволяя приложениям делать то, что от них не ожидается. Так, сконфигурированные модули безопасности не дадут веб-серверу шариться по диску вне нескольких ожидаемых директорий. Обратной стороной является необходимость конфигурировать систему безопасности для каждого мало-мальски нестандартно настроенного приложения. Не у многих на это хватает энтузиазма, так что обычно модуль безопасности просто переключается в разрешающий режим.
Антивирусные программы для GNU/Linux существуют, но мне не встречались дистрибутивы, где бы они шли из коробки, кроме специализированных решений для сканирования системы.
Подсистема печати
CUPS — «общая система печати UNIX», рождённая компанией Apple. Система модульная, поддерживает огромное количество устройств и, насколько мне известно, на сегодня не имеет альтернатив. А ещё CUPS имеет веб-интерфейс (по умолчанию на localhost:631).

Морда CUPS
CUPS работает только с печатающими устройствами, сканеры поддерживаются фреймворком SANE. К сожалению, спектр поддерживаемых устройств у SANE не очень широк. Некоторые вендорские драйверы для МФУ обеспечивают одновременно работоспособность сканера и работоспособность принтера через CUPS. Так, например, делает HPLIP от HP Inc. Благдаря HPLIP GNU/Linux может похвастаться отличной поддержкой печатающих устройств от HP. В то же время, HPLIP прикручен к CUPS немного сбоку, и часто проблематично настроить устройства HP только утилитами CUPS, как многие другие принтеры. Приходится использовать hp-setup .
Звуковая подсистема
Продолжительное время основной звуковой подсистемой ядра является ALSA. Некоторые пользователи ошибочно считают, что PulseAudio заменил ALSA. Это не так, PulseAudio — это звуковой сервер, являющийся лишь слоем абстракции, упрощающим управление аудиопотоками. Другим аудиосервером является JACK, который предназначен для профессиональной работы с аудио. Он не столь удобен для пользователя, но обеспечивает низкие задержки и предоставляет гибкую маршрутизацию MIDI-потоков.
Red Hat готовит нам PipeWire на замену PulseAudio и JACK. Следим за событиями.
Межпроцессное взаимодействие
Здесь речь не про низкоуровневые POSIX-штуки типа разделяемой памяти и сокеты. За свой век GNU/Linux повидал несколько подсистем, призванных упростить межпроцессное взаимодействие (IPC) десктоп-приложений. Сейчас правит бал шина сообщений D-Bus, а об остальных позабыли. Для чего это нужно? Например, некая служба посылает в шину сообщение об изменении своего состояния, а апплет панели слушает его и изменяет свой индикатор. Так обычно работают апплеты громкости и клавиатурной раскладки.
Традиционно в различных дистрибутивах GNU/Linux сеть настраивалась скриптами (причём различными). NetworkManager — детище Red Hat, созданное, чтобы править всеми интерфейсами. В годы юности NM вызывал приступы фрустрации у пользователей, но потом всё стало неплохо. NetworkManager позволяет управлять проводными и беспроводными интерфейсами, всевозможными тунелями, виртуальными мостами, VLAN’ами и аггрегированными каналами, причём как при помощи графических фронтендов, так и псевдографического nmtui и текстового nmcli . Вещь удобная и универсальная, в дистрибутивах Red Hat, ожидаемо идёт по умолчанию, в Debian и производных идёт только с рабочим столом, а в «безголовом исполнении» NM опционален. Есть альтернативы попроще, например — Wicd.
Работоспособность WiFi-устройств, как правило, обеспечивает демон WPA supplicant, у которого есть конкурент iwd, написанный ни много ни мало, компанией Intel.
Тут же хочется упомянуть демон Bluez, обеспечивающий работу с Bluetooth-устройствами.
Межсетевой экран
Слава iptables гремит далеко за узким кругом бородатых админов. Это не фильтр сам по себе, а лишь набор утилит в пространстве пользователя, работающий с подсистемой Linux Netfilter. Недавно (в историческом масштабе) добавилась подсистема ядра nftables и соответствующая пользовательская утилита nft. Это было сделано, в первую очередь, для унификации интерфейсов таблиц маршрутизации IPv4, IPv6, ARP и софтовых L2-коммутаторов. В современных дистрибутивах команды iptables являются лишь обёрткой для nftables и не рекомендуются к использованию. В целом, конфиг nft выглядит опрятнее дампа iptables.
Существует пачка высокоуровневых фаерволлов-обёрток над nftables (в том числе графических), так в RHEL и производых из коробки идёт firewalld, а в Ubuntu — UFW.
Пакетный менеджер
Пакетный менеджер — это сердце дистрибутива. Наиболее именитые и с длинной историей — это RPM из мира Red Hat и dpkg из семества Debian. Пример более современного — pacman из Arch Linux. Старожилы RPM и dpkg работают только с локальными пакетами: они их распаковывают, устанавливают и проверяют, что все зависимости удовлетворены. Работой с репозиториями занимаются другие утилиты, являющиеся как бы фронтендом к самому пакетному менеджеру. В RHEL ранее поставлялась утилита yum, на замену которой пришла dnf, в Debian раньше были apt-get и apt-cache, затем их увязали в одну команду apt. Более молодой pacman не имеет видимого пользователю разделения на несколько утилит и предлагает очень простой формат пакетов, которые можно собирать буквально на коленке. Есть и множество других, со своими особенностями. Например nix, который позволяет иметь в системе несколько версий одного пакета.
Новое в исторических масштабах явление — кросс-дистрибутивные системы поставки приложений. Появились в попытке преодолеть ад зависимостей, облегчить труд разработчиков и мейнтейнеров (избавив их от необходимости создавать десятки пакетов под разные версии и ветки GNU/Linux). Наиболее популярные проекты: Flatpack от Gnome, Snap от Canonical и AppImage сам по себе. Они несколько отличаются подходами, но в общем случае обеспечивают установку приложений со всем рантаймом и некоторой степенью изоляции от системы. Штуки удобные, однако подход несколько напоминает традиции тащить все зависимости с устанавливаемой программой в популярной ОС другого производителя. Простоты и порядка в систему не добавляют.
Для перечисленного добра есть красивые обёртки в виде магазинов приложений, два самых ходовых — GNOME Software и KDE Discover.
 KDE Discover
 GNOME Software с фирменной кнопочкой в заголовке окна
Заключение
Краткая результирующая диаграмма:

Современный GNU/Linux в представлении художника
Если присмотреться к перечисленным составляющим GNU/Linux, можно заметить, что львиная доля технологий привносится несколькими крупными организациями. К ним относятся:
проект GNU под эгидой Free Software Foundation;
Red Hat, производитель коммерческого дистрибутива, недавно вошедший в состав IBM;
сообщество kernel.org при поддержке Linux Foundation.
В интернете ради флейма часто вкидывают, мол, поглядите — эти ваши линуксы делают клятые корпорации, где ваше хвалёное сообщество? Я думаю, не стоит противопоставлять отдельных энтузиастов и организации: все они вращают колесо open source. В конце концов, в больших организациях трудятся обычные люди. В итоге мы имеем очень динамичную систему, в которой не без причины компоненты сменяются один за другим, всё это куда-то движется, и, в общем-то, год от года хорошеет. Я надеюсь, в этом очерке удалось дать представление об анатомии GNU/Linux, а может быть и заинтересовать кого-нибудь закопаться поглубже.
Большое спасибо @ajijiadduh, который отловил огромное количество опечаток сразу после публикации, и всем прочим пользователям, указавшим на ошибки.
Ядро Linux
Как вы наверняка знаете, всё началось с того, что в 1991 году программист Линус Торвальдс решил создать свою собственную операционную систему, начав с самого главного компонента — её ядра — связующего «мостика» между программами и непосредственно аппаратной частью компьютера. В этой статье мы поговорим о том, что представляет собой ядро Linux с точки зрения обычного пользователя и какие существуют версии ядра дистрибутивов Linux.
Что такое ядро ОС? Типы ядер
Ядро — это своего рода главная программа, являющаяся основной частью операционной системы. Оно выступает в роли посредника между устройствами компьютера (процессором, видеокартой, оперативной памятью и т.д.) и его программным обеспечением, абстрагируя от обычных программ и пользователей сложную, низкоуровневую работу с «железом» компьютера, предоставляя взамен простой, понятный и удобный в использовании интерфейс. Для этого в код ядра включены драйверы устройств, которые могут как загружаться в память вместе с ядром ОС, так и подключаться по мере возникновения потребности в ресурсах необходимого устройства.
Как правило, большинство ядер ОС делятся на три типа:
Микроядро
Микроядро — это ядро, состоящее из нескольких подгружаемых в память по мере надобности независимых модулей, выполняющихся в отдельных адресных пространствах. По сути, в таком варианте исполнения оно не сильно отличается от обычных прикладных программ. К достоинствам данного ядра можно отнести теоретически большую надежность в сравнении с другими архитектурами (в действительности же не всё так радужно и гладко) и его модульность (легкость в подключении дополнительных частей ядра). К минусам микроядерной архитектуры относится то, что ядро, построенное по такой схеме, получается очень медленным (ведь ему нужно постоянно переключаться между отдельными частями).
небольшие требования к используемой памяти;
аппаратное обеспечение сильнее абстрагировано от системы;
аппаратное обеспечение может медленнее реагировать, поскольку драйверы находятся в пользовательском пространстве;
процессы не могут получить доступ к другим процессам без ожидания.
Монолитное ядро
Монолитное ядро — это полная противоположность микроядра, т.к. в памяти компьютера всегда находится весь (или почти весь) код ядра, вследствие чего скорость его работы выше в сравнении с микроядром. Монолитные ядра, как правило, лучше справляются с операциями доступа к оборудованию и многозадачностью, потому что, если программе нужно получить информацию из памяти или другого запущенного процесса, у нее есть прямая линия для доступа к ней, и программе не нужно ждать в очереди, чтобы сделать что-то. Однако такой подход может вызвать серьезные проблемы, потому что, чем больше процессов выполняется на уровне ядра, тем больше вероятность, что в случае непредвиденного поведения они создадут общий сбой вашей системы.
практически прямой доступ программ к оборудованию;
процессам проще взаимодействовать друг с другом;
если ваше устройство поддерживается ядром, никаких дополнительных установок ПО не потребуется;
процессы реагируют быстрее, потому что не требуется ожидания в очереди за процессорным временем.
большой размер ядра;
больший размер занимаемой памяти;
проблемы с безопасностью, т.к. все части работают в пространстве ядра.
Гибридное ядро
Гибридное ядро — это ядро, сочетающее в себе элементы как монолитной, так и микроядерной архитектур. У таких ядер есть возможность выбирать, какие части будут работать в пользовательском пространстве (например, драйверы устройств и система ввода-вывода файловой системы), а какие — в пространстве ядра (вызовы межпроцессного (IPC) и серверного взаимодействий). Но этот подход имеет и некоторые проблемы, унаследованные от микроядерной архитектуры (особенно, по части быстродействия).
разработчик может выбрать, какие программы будут работать в пользовательском пространстве, а какие — в пространстве ядра;
меньший размер в сравнении с монолитным ядром;
гибче в отличие от других ядер.
может страдать от пониженной производительности (как и микроядро);
работа драйверов устройств, как правило, сильнее зависит от производителей оборудования.
Ядро Linux хоть и относится к монолитным ядрам, но оно также заимствует и некоторые идеи из микроядерной архитектуры, что означает, что вся операционная система работает в пространстве ядра, а драйверы устройств (в виде модулей) могут быть легко загружены (или выгружены) прямо во время работы операционной системы.
Где находится ядро Linux?
Каждый раз во время запуска (или перезапуска) системы первым компонентом, который загружается в память компьютера, является ядро Linux.
В системах Debian/Ubuntu файлы присутствующих в системе ядер расположены в каталоге /boot и именуются в виде vmlinuz-[версия_ядра] (выполнив в терминале команду uname-r , мы получим информацию о текущей версии установленного ядра):

В папке /boot вы также найдете и другие очень важные файлы:
img-[версия_ядра] — используется в качестве RAM-диска, в который распаковывается и с которого загружается ядро;
map-[версия_ядра] — используется для управления памятью до полной загрузки ядра;
config-[версия_ядра] — сообщает ядру, какие параметры и модули следует загрузить в образ ядра при его компиляции.
Когда Линус Торвальдс только начинал разрабатывать свое ядро, оно носило простое название — linux. С появлением технологии виртуальной памяти к ядру добавилась приставка vm (сокр. от «virtual memory»). Со временем ядро настолько разрослось, что к нему стали применять сжатие, об этом нам говорит буква z (от «zlib compression») в слове vmlinuz.
Примечание: Также для сжатия ядра часто применяются алгоритмы LZMA или bzip2, а сами ядра именуются zImage.
Модули ядра Linux
Что, если б в Windows уже содержались все доступные драйверы устройств, и вам просто нужно было задействовать некоторые из них? В этом, по сути, и заключен принцип загружаемых модулей ядра Linux (сокр. «LKM» от англ. «Loadable Kernel Module»). Они должны обеспечивать взаимодействие ядра со всем вашим оборудованием, и при этом не занимать всю доступную память.
Модули обычно расширяют базовые возможности ядра, связанные с различной работой устройств, файловых систем и системных вызовов. Они, как правило, имеют расширение .ko и обычно хранятся в каталоге /lib/modules:

Благодаря модульной структуре, вы можете легко настроить ядро под себя, установив необходимые модули с помощью menuconfig или отредактировав файл /boot/config, или вы можете загружать и выгружать модули «на лету» с помощью команды modprobe .
В некоторых дистрибутивах, таких как Ubuntu, доступны модули сторонних производителей или с закрытым исходным кодом. Разработчики программного обеспечения (например, NVIDIA, AMD и др.) не предоставляют исходный код, а скорее создают свои собственные модули в виде предварительно скомпилированных .ko-файлов. Некоторые разработчики Linux считают, что такие закрытые модули «портят» своим присутствием ядро, предоставляя несвободное программное обеспечение, и не включают их в свои дистрибутивы.
Версии ядра дистрибутивов Linux
Stable
Stable — это последняя доступная стабильная версия ядра Linux, предназначенная для широкого круга использования. По умолчанию, в большинстве дистрибутивов Linux применяется именно stable-версия ядра. Она регулярно обновляется, и к ней довольно часто выпускаются новые патчи.
LTS (сокр. от «Long-Term Support») — это версия ядра с длительным сроком поддержки, которая считается более стабильной в сравнении с обычной версией ядра, т.к. при её разработке программисты стараются не экспериментировать с различными нововведениями. Однако из-за этого, LTS-версии ядра могут не иметь некоторых функций ядер более свежих релизов, а также содержать старые версии драйверов, несовместимых с более новым оборудованием. Жизненный цикл LTS-ядра, обычно, составляет 5 лет для настольных компьютеров и серверов (раньше для настольных компьютеров поддержка осуществлялась на протяжении 3 лет). Для сравнения, обычные релизы ядра имеют поддержку всего 9 месяцев с момента выпуска.
Несмотря на то, что исправления безопасности внедряются в LTS-версию так же часто, как и в обычную, она, тем не менее, не дает 100% гарантии отсутствия каких-либо ошибок. Правда, шанс того, что с LTS-версией ядра Linux возникнут какие-то проблемы, немного меньше по сравнению с обычной версией ядра Linux, и поэтому многие предприятия отдают предпочтение именно LTS-релизам.
Примечание: По данным компании Canonical, примерно 95% всех установок Ubuntu являются LTS-релизами.
Hardened
Hardened — это усиленная различными обновлениями безопасности stable-версия ядра Linux. Она умеет блокировать потенциально опасные операции, обеспечивая тем самым эффективную защиту от эксплойтов, нацеленных на использование уязвимостей ядра. Данная версия ядра не так популярна, как другие, из-за того, что несколько медленнее их. Hardened-ядро убивает любой процесс, который покажется ему потенциально опасным. Кроме этого, он не отображает PID процессов, и, следовательно, вы не сможете напрямую обратиться к запущенному исполняемому файлу. Также некоторые программы и функции могут не работать с hardened-ядром.
Zen — версия ядра Linux, ориентированная на повышение производительности и отзывчивости системы. Также говорят, что это лучшее ядро Linux для игр. Zen имеет низкую задержку и высокочастотный планировщик.
Установка/Обновление ядра Linux
В Linux есть исходное ядро, которое разработал Линус Торвальдс, а затем уже дополняли и дополняют другие разработчики и организации вместе с Линусом Торвальдсом. Расположено исходное ядро на сайте kernel.org.
Все дистрибутивы Linux (Debian, Ubuntu, Manjaro, CentOS и др.), которые начали появляться после публикации исходного ядра, стали вносить свои изменения и дополнения, формируя, таким образом, свой вариант исходного ядра Linux. Все Linux-дистрибутивы имеют в своей основе исходное ядро из kernel.org, но уже с внесенными в него соответствующими правками.
Примечание: Ядра разных дистрибутивов не являются взаимозаменяемыми. Теоретически, можно «подкинуть», например, ядро из Debian в Ubuntu. И система даже заработает (ведь Ubuntu произошла от Debian), но в 99% случаев начнут появляться разные глюки и баги.
Соответственно, из этого можно сделать следующие выводы:
Если вы хотите установить «чистое», оригинальное ядро Linux, то вам нужно скачать его с kernel.org, затем сконфигурировать на свое усмотрение и наслаждаться.
Если вам нужно ядро Linux с правками под какой-то конкретный дистрибутив (например, Debian или Manjaro), то вам нужно скачать ядро из репозитория конкретного дистрибутива с помощью менеджера пакетов.
Зачем тогда нужен kernel.org? Дело в том, что сначала свежая версия исходного ядра появляется на kernel.org, а затем уже «расходится» по репозиториям остальных дистрибутивов.
Есть 2 способа установки/обновления ядра Linux:
Обновление ядра Linux через менеджер пакетов.
На этом уроке мы рассмотрим обновление ядра Linux через менеджер пакетов, а на следующем — самостоятельную установку и конфигурирование ядра Linux.
Обновление ядра Linux через менеджер пакетов
Обычно, вместе с обновлением системы происходит и обновление ядра. Но если вы по каким-либо причинам хотите произвести установку/обновление непосредственно только ядра Linux, то ниже мы рассмотрим данный процесс для нескольких дистрибутивов Linux.
Linux Mint (Debian/Ubuntu)
Для начала сверим текущую установленную версию ядра:

Далее выполним поиск доступных для установки ядер (сгенерированный список может быть очень длинным, поэтому, чтобы хоть как-то ограничить вывод и сделать его постраничным, применим фильтр | more ):
$ sudo apt-cache search linux-image | more

Мой выбор пал на ядро linux-image-4.15.0-1004-oem. Чтобы его установить, нужно выполнить команду:
$ sudo apt-get install linux-image-4.15.0-1004-oem

Останется только перезагрузить систему и убедиться, что новое ядро успешно установилось:

Manjaro (Arch Linux)
В Manjaro используется свой менеджер пакетов — pacman, поэтому его команды будут немного отличаться от команд в других дистрибутивах. Чтобы вывести список доступных для установки ядер, необходимо выполнить:
$ sudo pacman –S linux

В рамке обведен список ядер, которые мы можем установить. Я выбрал пункт №5 (linux510), нажав соответствующую кнопку на цифровой клавиатуре. После этого запустился процесс скачивания необходимых пакетов. Когда всё будет готово, перезагружаем систему и радуемся новому ядру:

Установка ядра Zen (Liquorix)
Liquorix — это отдельный проект ядра, собранный из исходников zen-ядра, но с использованием лучшей конфигурации для повышения производительности системы.
Debian
Скачиваем скрипт, который добавит в систему нужные репозитории:
$ curl ‘https://liquorix.net/add-liquorix-repo.sh’ | sudo bash

После чего выполняем всего одну команду, устанавливающую пакеты с новым ядром:
$ sudo apt-get install linux-image-liquorix-amd64 linux-headers-liquorix-amd64

Ubuntu
Установка в Ubuntu происходит практически аналогичным образом. Сначала добавляем репозитории zen-ядра (liquorix):
sudo add-apt-repository ppa:damentz/liquorix && sudo apt-get update
После чего выполняем уже знакомую по прошлому разу команду:
sudo apt-get install linux-image-liquorix-amd64 linux-headers-liquorix-amd64
И теперь перезагружаем систему. Готово!
Manjaro
Сначала установим помощник установки пакетов — yay:
$ git clone https://aur.archlinux.org/yay.git

Далее установим необходимые утилиты:
$ sudo pacman –S base-devel

Заходим в каталог yay и производим сборку пакета:
$ cd yay
$ makepkg -si

После этого переходим непосредственно к установке zen-ядра:
$ yay -S linux-zen-git

Стоит отметить, что этот процесс может занять довольно большой отрезок времени. По его окончанию, перезагружаем систему и радуемся новому ядру.
Introduction
Kernel and user are two terms that are often used in operating systems. Their definition is pretty straight forward: The kernel is the part of the operating system that runs with higher privileges while user (space) usually means by applications running with low privileges.
However these terms are heavily overloaded and might have very specific meanings in some contexts.
User mode and kernel mode are terms that may refer specifically to the processor execution mode. Code that runs in kernel mode can fully [1] control the CPU while code that runs in user mode has certain limitations. For example, local CPU interrupts can only be disabled or enable while running in kernel mode. If such an operation is attempted while running in user mode an exception will be generated and the kernel will take over to handle it.
| [1] | some processors may have even higher privileges than kernel mode, e.g. a hypervisor mode, that is only accessible to code running in a hypervisor (virtual machine monitor) |
User space and kernel space may refer specifically to memory protection or to virtual address spaces associated with either the kernel or user applications.
Grossly simplifying, the kernel space is the memory area that is reserved to the kernel while user space is the memory area reserved to a particular user process. The kernel space is accessed protected so that user applications can not access it directly, while user space can be directly accessed from code running in kernel mode.
Typical operating system architecture
In the typical operating system architecture (see the figure below) the operating system kernel is responsible for access and sharing the hardware in a secure and fair manner with multiple applications.
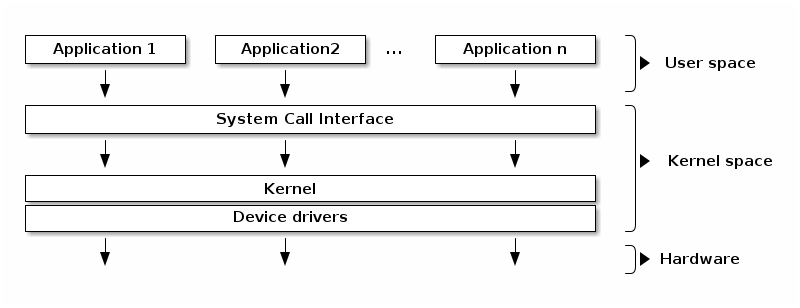
The kernel offers a set of APIs that applications issue which are generally referred to as "System Calls". These APIs are different from regular library APIs because they are the boundary at which the execution mode switch from user mode to kernel mode.
In order to provide application compatibility, system calls are rarely changed. Linux particularly enforces this (as opposed to in kernel APIs that can change as needed).
The kernel code itself can be logically separated in core kernel code and device drivers code. Device drivers code is responsible of accessing particular devices while the core kernel code is generic. The core kernel can be further divided into multiple logical subsystems (e.g. file access, networking, process management, etc.)
Monolithic kernel
A monolithic kernel is one where there is no access protection between the various kernel subsystems and where public functions can be directly called between various subsystems.
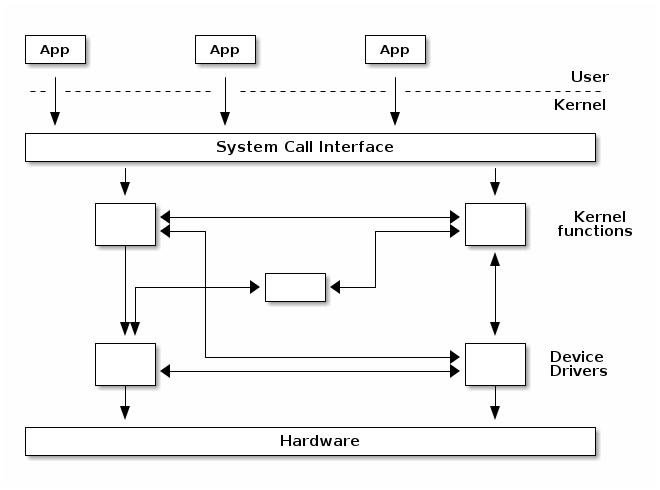
However, most monolithic kernels do enforce a logical separation between subsystems especially between the core kernel and device drivers with relatively strict APIs (but not necessarily fixed in stone) that must be used to access services offered by one subsystem or device drivers. This, of course, depends on the particular kernel implementation and the kernel’s architecture.
Micro kernel
A micro-kernel is one where large parts of the kernel are protected from each-other, usually running as services in user space. Because significant parts of the kernel are now running in user mode, the remaining code that runs in kernel mode is significantly smaller, hence micro-kernel term.
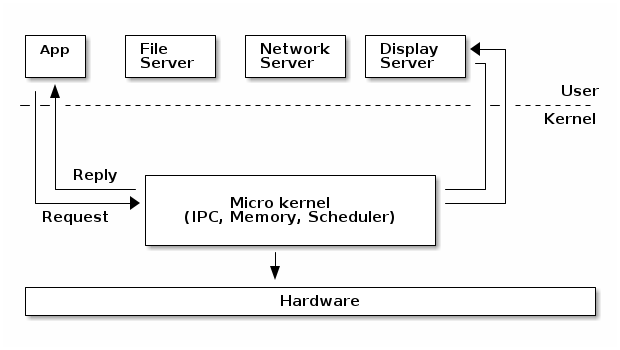
In a micro-kernel architecture the kernel contains just enough code that allows for message passing between different running processes. Practically that means implement the scheduler and an IPC mechanism in the kernel, as well as basic memory management to setup the protection between applications and services.
One of the advantages of this architecture is that the services are isolated and hence bugs in one service won’t impact other services.
As such, if a service crashes we can just restart it without affecting the whole system. However, in practice this is difficult to achieve since restarting a service may affect all applications that depend on that service (e.g. if the file server crashes all applications with opened file descriptors would encounter errors when accessing them).
This architecture imposes a modular approach to the kernel and offers memory protection between services but at a cost of performance. What is a simple function call between two services on monolithic kernels now requires going through IPC and scheduling which will incur a performance penalty [2].
Micro-kernels vs monolithic kernels
Advocates of micro-kernels often suggest that micro-kernel are superior because of the modular design a micro-kernel enforces. However, monolithic kernels can also be modular and there are several approaches that modern monolithic kernels use toward this goal:
- Components can enabled or disabled at compile time
- Support of loadable kernel modules (at runtime)
- Organize the kernel in logical, independent subsystems
- Strict interfaces but with low performance overhead: macros, inline functions, function pointers
There is a class of operating systems that (used to) claim to be hybrid kernels, in between monolithic and micro-kernels (e.g. Windows, Mac OS X). However, since all of the typical monolithic services run in kernel-mode in these operating systems, there is little merit to qualify them other then monolithic kernels.
Many operating systems and kernel experts have dismissed the label as meaningless, and just marketing. Linus Torvalds said of this issue:
"As to the whole ‘hybrid kernel’ thing — it’s just marketing. It’s ‘oh, those microkernels had good PR, how can we try to get good PR for our working kernel? Oh, I know, let’s use a cool name and try to imply that it has all the PR advantages that that other system has’."
Address space
The address space term is an overload term that can have different meanings in different contexts.
The physical address space refers to the way the RAM and device memories are visible on the memory bus. For example, on 32bit Intel architecture, it is common to have the RAM mapped into the lower physical address space while the graphics card memory is mapped high in the physical address space.
The virtual address space (or sometimes just address space) refers to the way the CPU sees the memory when the virtual memory module is activated (sometime called protected mode or paging enabled). The kernel is responsible of setting up a mapping that creates a virtual address space in which areas of this space are mapped to certain physical memory areas.
Related to the virtual address space there are two other terms that are often used: process (address) space and kernel (address) space.
The process space is (part of) the virtual address space associated with a process. It is the "memory view" of processes. It is a continuous area that starts at zero. Where the process’s address space ends depends on the implementation and architecture.
The kernel space is the "memory view" of the code that runs in kernel mode.
User and kernel sharing the virtual address space
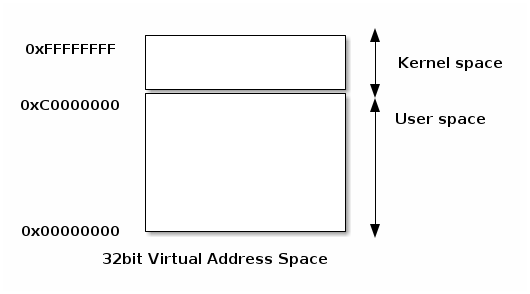
A typical implementation for user and kernel spaces is one where the virtual address space is shared between user processes and the kernel.
In this case kernel space is located at the top of the address space, while user space at the bottom. In order to prevent the user processes from accessing kernel space, the kernel creates mappings that prevent access to the kernel space from user mode.
Execution contexts
One of the most important jobs of the kernel is to service interrupts and to service them efficiently. This is so important that a special execution context is associated with it.
The kernel executes in interrupt context when it runs as a result of an interrupt. This includes the interrupt handler, but it is not limited to it, there are other special (software) constructs that run in interrupt mode.
Code running in interrupt context always runs in kernel mode and there are certain limitations that the kernel programmer has to be aware of (e.g. not calling blocking functions or accessing user space).
Opposed to interrupt context there is process context. Code that runs in process context can do so in user mode (executing application code) or in kernel mode (executing a system call).
Multi-tasking
Multitasking is the ability of the operating system to "simultaneously" execute multiple programs. It does so by quickly switching between running processes.
Cooperative multitasking requires the programs to cooperate to achieve multitasking. A program will run and relinquish CPU control back to the OS, which will then schedule another program.
With preemptive multitasking the kernel will enforce strict limits for each process, so that all processes have a fair chance of running. Each process is allowed to run a time slice (e.g. 100ms) after which, if it is still running, it is forcefully preempted and another task is scheduled.
Preemptive kernel
Preemptive multitasking and preemptive kernels are different terms.
A kernel is preemptive if a process can be preempted while running in kernel mode.
However, note that non-preemptive kernels may support preemptive multitasking.
Pageable kernel memory
A kernel supports pageable kernel memory if parts of kernel memory (code, data, stack or dynamically allocated memory) can be swapped to disk.
Kernel stack
Each process has a kernel stack that is used to maintain the function call chain and local variables state while it is executing in kernel mode, as a result of a system call.
The kernel stack is small (4KB — 12 KB) so the kernel developer has to avoid allocating large structures on stack or recursive calls that are not properly bounded.
Portability
In order to increase portability across various architectures and hardware configurations, modern kernels are organized as follows at the top level:
- Architecture and machine specific code (C & ASM)
- Independent architecture code (C):
- kernel core (further split in multiple subsystems)
- device drivers
This makes it easier to reuse code as much as possible between different architectures and machine configurations.
Asymmetric MultiProcessing (ASMP)
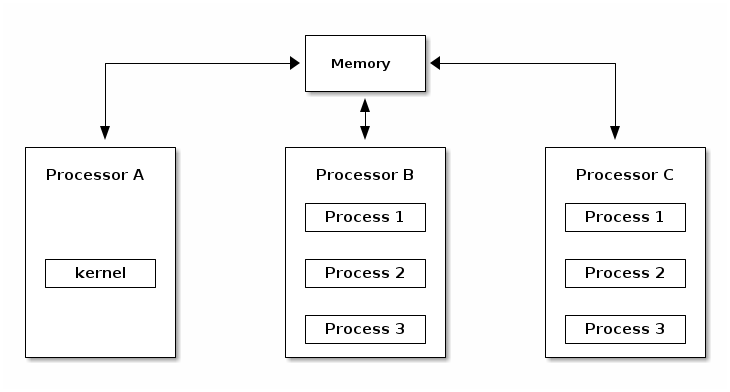
Asymmetric MultiProcessing (ASMP) is a way of supporting multiple processors (cores) by a kernel, where a processor is dedicated to the kernel and all other processors run user space programs.
The disadvantage of this approach is that the kernel throughput (e.g. system calls, interrupt handling, etc.) does not scale with the number of processors and hence typical processes frequently use system calls. The scalability of the approach is limited to very specific systems (e.g. scientific applications).
Symmetric MultiProcessing (SMP)
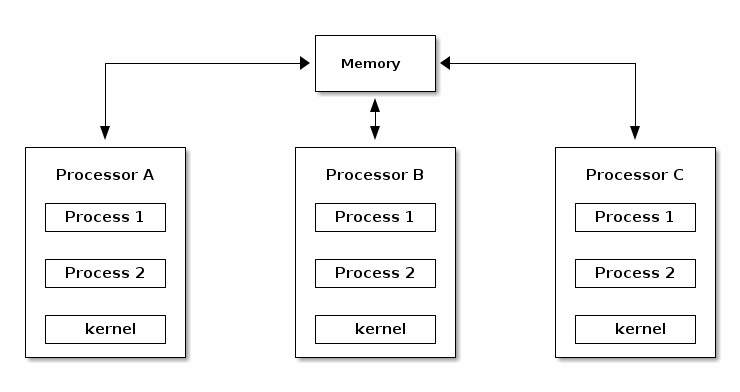
As opposed to ASMP, in SMP mode the kernel can run on any of the existing processors, just as user processes. This approach is more difficult to implement, because it creates race conditions in the kernel if two processes run kernel functions that access the same memory locations.
In order to support SMP the kernel must implement synchronization primitives (e.g. spin locks) to guarantee that only one processor is executing a critical section.
CPU Scalability
CPU scalability refers to how well the performance scales with the number of cores. There are a few things that the kernel developer should keep in mind with regard to CPU scalability:
- Use lock free algorithms when possible
- Use fine grained locking for high contention areas
- Pay attention to algorithm complexity
Overview of the Linux kernel
Linux development model
The Linux kernel is one the largest open source projects in the world with thousands of developers contributing code and millions of lines of code changed for each release.
It is distributed under the GPLv2 license, which simply put, requires that any modification of the kernel done on software that is shipped to customer should be made available to them (the customers), although in practice most companies make the source code publicly available.
There are many companies (often competing) that contribute code to the Linux kernel as well as people from academia and independent developers.
The current development model is based on doing releases at fixed intervals of time (usually 3 — 4 months). New features are merged into the kernel during a one or two week merge window. After the merge window, a release candidate is done on a weekly basis (rc1, rc2, etc.)
Maintainer hierarchy
In order to scale the development process, Linux uses a hierarchical maintainership model:
- Linus Torvalds is the maintainer of the Linux kernel and merges pull requests from subsystem maintainers
- Each subsystem has one or more maintainers that accept patches or pull requests from developers or device driver maintainers
- Each maintainer has its own git tree, e.g.:
- Linux Torvalds: git://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux-2.6.git
- David Miller (networking): git://git.kernel.org/pub/scm/linux/kernel/git/davem/net.git/
Since the merge window is only a maximum of two weeks, most of the maintainers have a -next tree where they accept new features from developers or maintainers downstream while even when the merge window is closed.
Note that bug fixes are accepted even outside merge window in the maintainer’s tree from where they are periodically pulled by the upstream maintainer regularly, for every release candidate.
Linux source code layout
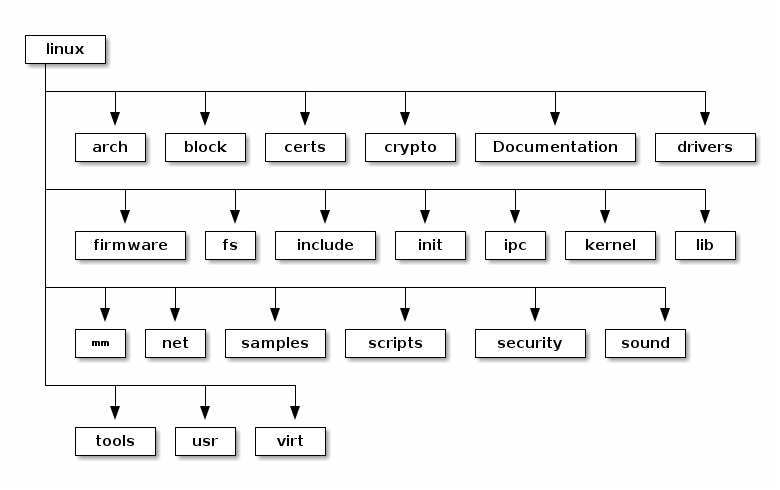
These are the top level of the Linux source code folders:
- arch — contains architecture specific code; each architecture is implemented in a specific sub-folder (e.g. arm, arm64, x86)
- block — contains the block subsystem code that deals with reading and writing data from block devices: creating block I/O requests, scheduling them (there are several I/O schedulers available), merging requests, and passing them down through the I/O stack to the block device drivers
- certs — implements support for signature checking using certificates
- crypto — software implementation of various cryptography algorithms as well as a framework that allows offloading such algorithms in hardware
- Documentation — documentation for various subsystems, Linux kernel command line options, description for sysfs files and format, device tree bindings (supported device tree nodes and format)
- drivers — driver for various devices as well as the Linux driver model implementation (an abstraction that describes drivers, devices buses and the way they are connected)
- firmware — binary or hex firmware files that are used by various device drivers
- fs — home of the Virtual Filesystem Switch (generic filesystem code) and of various filesystem drivers
- include — header files
- init — the generic (as opposed to architecture specific) initialization code that runs during boot
- ipc — implementation for various Inter Process Communication system calls such as message queue, semaphores, shared memory
- kernel — process management code (including support for kernel thread, workqueues), scheduler, tracing, time management, generic irq code, locking
- lib — various generic functions such as sorting, checksums, compression and decompression, bitmap manipulation, etc.
- mm — memory management code, for both physical and virtual memory, including the page, SL*B and CMA allocators, swapping, virtual memory mapping, process address space manipulation, etc.
- net — implementation for various network stacks including IPv4 and IPv6; BSD socket implementation, routing, filtering, packet scheduling, bridging, etc.
- samples — various driver samples
- scripts — parts the build system, scripts used for building modules, kconfig the Linux kernel configurator, as well as various other scripts (e.g. checkpatch.pl that checks if a patch is conform with the Linux kernel coding style)
- security — home of the Linux Security Module framework that allows extending the default (Unix) security model as well as implementation for multiple such extensions such as SELinux, smack, apparmor, tomoyo, etc.
- sound — home of ALSA (Advanced Linux Sound System) as well as the old Linux sound framework (OSS)
- tools — various user space tools for testing or interacting with Linux kernel subsystems
- usr — support for embedding an initrd file in the kernel image
- virt — home of the KVM (Kernel Virtual Machine) hypervisor
Linux kernel architecture
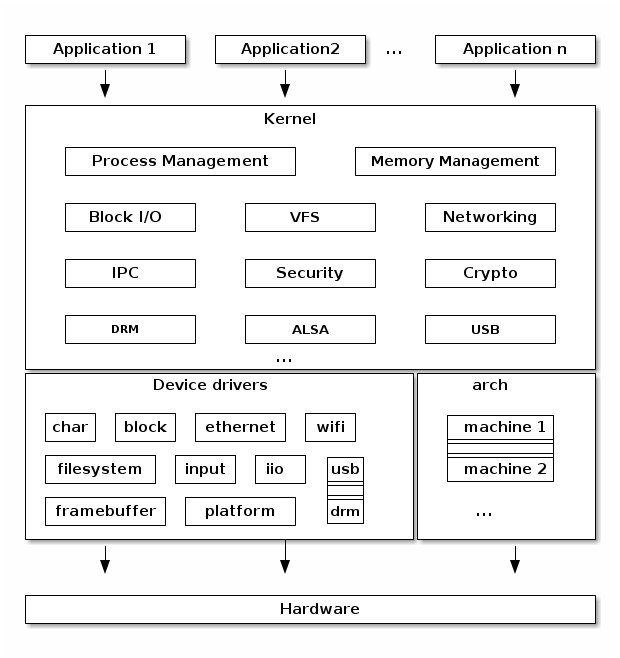
- Architecture specific code
- May be further sub-divided in machine specific code
- Interfacing with the boot loader and architecture specific initialization
- Access to various hardware bits that are architecture or machine specific such as interrupt controller, SMP controllers, BUS controllers, exceptions and interrupt setup, virtual memory handling
- Architecture optimized functions (e.g. memcpy, string operations, etc.)
This part of the Linux kernel contains architecture specific code and may be further sub-divided in machine specific code for certain architectures (e.g. arm).
"Linux was first developed for 32-bit x86-based PCs (386 or higher). These days it also runs on (at least) the Compaq Alpha AXP, Sun SPARC and UltraSPARC, Motorola 68000, PowerPC, PowerPC64, ARM, Hitachi SuperH, IBM S/390, MIPS, HP PA-RISC, Intel IA-64, DEC VAX, AMD x86-64 and CRIS architectures.”
It implements access to various hardware bits that are architecture or machine specific such as interrupt controller, SMP controllers, BUS controllers, exceptions and interrupt setup, virtual memory handling.
It also implements architecture optimized functions (e.g. memcpy, string operations, etc.)
Device drivers
The Linux kernel uses a unified device model whose purpose is to maintain internal data structures that reflect the state and structure of the system. Such information includes what devices are present, what is their status, what bus they are attached to, to what driver they are attached, etc. This information is essential for implementing system wide power management, as well as device discovery and dynamic device removal.
Each subsystem has its own specific driver interface that is tailored to the devices it represents in order to make it easier to write correct drivers and to reduce code duplication.
Linux supports one of the most diverse set of device drivers type, some examples are: TTY, serial, SCSI, fileystem, ethernet, USB, framebuffer, input, sound, etc.
Process management
Linux implements the standard Unix process management APIs such as fork(), exec(), wait(), as well as standard POSIX threads.
However, Linux processes and threads are implemented particularly different than other kernels. There are no internal structures implementing processes or threads, instead there is a struct task_struct that describe an abstract scheduling unit called task.
A task has pointers to resources, such as address space, file descriptors, IPC ids, etc. The resource pointers for tasks that are part of the same process point to the same resources, while resources of tasks of different processes will point to different resources.
This peculiarity, together with the clone() and unshare() system call allows for implementing new features such as namespaces.
Namespaces are used together with control groups (cgroup) to implement operating system virtualization in Linux.
cgroup is a mechanism to organize processes hierarchically and distribute system resources along the hierarchy in a controlled and configurable manner.
Memory management
Linux memory management is a complex subsystem that deals with:
- Management of the physical memory: allocating and freeing memory
- Management of the virtual memory: paging, swapping, demand paging, copy on write
- User services: user address space management (e.g. mmap(), brk(), shared memory)
- Kernel services: SL*B allocators, vmalloc
Block I/O management
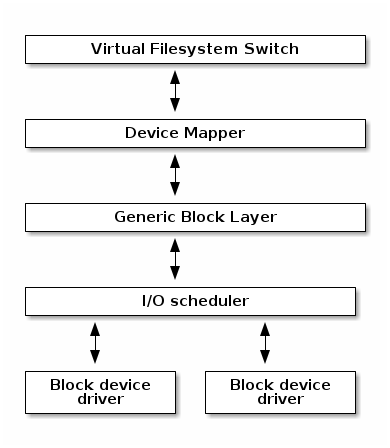
The Linux Block I/O subsystem deals with reading and writing data from or to block devices: creating block I/O requests, transforming block I/O requests (e.g. for software RAID or LVM), merging and sorting the requests and scheduling them via various I/O schedulers to the block device drivers.
Virtual Filesystem Switch
The Linux Virtual Filesystem Switch implements common / generic filesystem code to reduce duplication in filesystem drivers. It introduces certain filesystem abstractions such as:
- inode — describes the file on disk (attributes, location of data blocks on disk)
- dentry — links an inode to a name
- file — describes the properties of an opened file (e.g. file pointer)
- superblock — describes the properties of a formatted filesystem (e.g. number of blocks, block size, location of root directory on disk, encryption, etc.)
The Linux VFS also implements a complex caching mechanism which includes the following: