Русские Блоги
В этой статье мы изучим файлы, записанные в каталог данных различными частями Elasticsearch. Мы рассмотрим файлы уровня узла, индекса и сегмента и кратко объясним их содержимое, чтобы понять данные, которые Elasticsearch записывает на диск.

1. Говоря с пути Elasticsearch
Elasticsearch настроен с несколькими путями:
path.home: Домашний каталог пользователя, выполняющего процесс Elasticsearch. По умолчанию используется системное свойство Java user.dir, которое является домашним каталогом по умолчанию владельца процесса.
path.conf: Каталог, содержащий файлы конфигурации. Обычно это задается установкой системного свойства Java es.config, поскольку его необходимо проанализировать до того, как будет найден файл конфигурации.
path.plugins: Подпапка является каталогом плагина Elasticsearch. Сим-ссылки поддерживаются здесь.При запуске нескольких экземпляров Elasticsearch из одного исполняемого файла, вы можете использовать его для выборочного включения / отключения набора плагинов для экземпляра Elasticsearch.
path.logs: Место, где хранятся созданные журналы. Если на одном из томов недостаточно дискового пространства, возможно, имеет смысл поместить его на том, отличный от каталога данных. path.data: путь к папке, содержащей данные, хранящиеся в Elasticsearch.
В этой статье мы тщательно изучим фактическое содержимое каталога данных (path.data) и попытаемся понять назначение всех файлов.
2. Откуда этот файл?
Поскольку Elasticsearch использует Lucene для обработки индексов и запросов уровня сегментов, файлы в каталоге данных пишутся Elasticsearch и Lucene. Обязанности обоих очень ясны:
Lucene отвечает за написание и ведение индексных файлов Lucene,
Elasticsearch записывает метаданные, связанные с такими функциями, как сопоставление полей, настройки индекса и другие кластерные метаданные поверх Lucene. Конечные пользователи и функции поддержки
Он не существует в низкоуровневом Lucene, предоставленном Elasticsearch.
Прежде чем углубляться в и, наконец, найти файл индекса Lucene, давайте посмотрим на данные внешнего уровня, написанные Elasticsearch.
3. Узел данных
Просто запустите Elasticsearch из пустой директории данных, чтобы сгенерировать следующее дерево каталогов:

Файл node.lock используется, чтобы гарантировать, что только одна информация об установке, относящаяся к Elasticsearch, может считываться / записываться из одного каталога данных одновременно.
Что интересно, так это файл global-0.st. Глобальный префикс указывает, что это файл глобального состояния,
Расширение .st указывает, что это файл состояния, содержащий метаданные. Как вы уже догадались, этот двоичный файл содержит глобальные метаданные о вашем кластере, число после префикса указывает версию метаданных кластера, следуя схеме контроля версий, которая следует строгому увеличению вашего кластера.
Примечание. Хотя технически возможно редактировать эти файлы с помощью шестнадцатеричного редактора в чрезвычайной ситуации, настоятельно рекомендуется этого не делать, поскольку это быстро приведет к потере данных.
4. Индекс данных
Давайте создадим оголенный индекс и посмотрим файлы, измененные Elasticsearch.

Мы видим, что создан новый каталог, соответствующий имени индекса. В этом каталоге есть две подпапки: _state и 0.
Бывшийсостояние содержит так называемые файлы состояния индекса (индексы / <имя-индекса>/state / state-
Последний 0 содержит данные, относящиеся к первому (и единственному) сегменту индекса (shard 0).
Далее мы рассмотрим подробнее.
5. Фрагментированные данные
Каталог данных сегмента содержит файлы состояния сегмента, включая управление версиями и информацию о том, является ли этот фрагмент основным или его копией.

В более ранних версиях Elasticsearch отдельные каталоги
Каталог
Прежде чем мы войдем в мир Lucene, мы рассмотрим журнал транзакций Elasticsearch, который существует в префиксе translog- в каталоге translog каждого сегмента. Журнал Translog очень важен для функционирования и производительности Elasticsearch, поэтому мы объясним его использование более подробно в следующем разделе.
6. Журнал транзакций (Transaction Log) для каждого шарда
Журналы транзакций Elasticsearch обеспечивают безопасную индексацию данных в Elasticsearch без необходимости выполнения низкоуровневых коммитов Lucene для каждого документа. Отправка индекса Lucene создаст новый сегмент на уровне Lucene, то есть выполнит fsync (), что приведет к снижению производительности дискового ввода-вывода.
Чтобы принять проиндексированный документ и сделать его доступным для поиска без полной отправки Lucene, Elasticsearch добавляет его в Lucene IndexWriter и добавляет его в журнал транзакций. После каждого refresh_interval он будет вызывать reopen () для индекса Lucene, что позволит искать данные без отправки. Это часть API Lucene Near Real Time. Когда IndexWriter наконец завершит фиксацию из-за автоматического обновления журнала транзакций или из-за явной операции обновления, предыдущий журнал транзакций будет отброшен, а новый журнал транзакций заменит его.
Если требуется восстановление, сначала будут восстановлены сегменты, записанные на диск в Lucene, а затем будет воспроизведен журнал транзакций, чтобы предотвратить потерю операций, которые не были полностью зафиксированы на диске.
7. Индексный файл Lucene
Lucene проделал хорошую работу по записи файлов в каталог индекса Lucene. Для удобства эти файлы воспроизводятся здесь (в документе ссылки в Lucene также подробно описаны изменения, которые произошли в этих файлах после возвращения из Lucene 2.1, поэтому ознакомьтесь с ним. выход):

Lucene Index Files
| Name | Extension | Brief Description |
|---|---|---|
| Segments File | segments_N | Stores information about a commit point |
| Lock File | write.lock | The Write lock prevents multiple IndexWriters from writing to the same file. |
| Segment Info | .si | Stores metadata about a segment |
| Compound File | .cfs, .cfe | An optional “virtual” file consisting of all the other index files for systems that frequently run out of file handles. |
| Fields | .fnm | Stores information about the fields |
| Field Index | .fdx | Contains pointers to field data |
| Field Data | .fdt | The stored fields for documents |
| Term Dictionary | .tim | The term dictionary, stores term info |
| Term Index | .tip | The index into the Term Dictionary |
| Frequencies | .doc | Contains the list of docs which contain each term along with frequency |
| Positions | .pos | Stores position information about where a term occurs in the index |
| Payloads | .pay | Stores additional per-position metadata information such as character offsets and user payloads |
| Norms | .nvd, .nvm | Encodes length and boost factors for docs and fields |
| Per-Document Values | .dvd, .dvm | Encodes additional scoring factors or other per-document information. |
| Term Vector Index | .tvx | Stores offset into the document data file |
| Term Vector Documents | .tvd | Contains information about each document that has term vectors |
| Term Vector Fields | .tvf | The field level info about term vectors |
| Live Documents | .liv | Info about what files are live |
Как правило, вы также видите файл сегментов.gen в каталоге индекса Lucene, который является файлом справки, который содержит информацию о текущем / последнем файле сегментов_N и используется для файловых систем, которые могут не возвращать достаточно информации через список каталогов, Определить сегменты файлов последнего поколения. В старых версиях Lucene вы также можете найти файлы с суффиксом .del. Они имеют ту же цель, что и файлы Live Documents (.liv) — другими словами, это списки удаления.
8. Исправить проблемные фрагменты
Поскольку фрагменты Elasticsearch содержат индексы Lucene, мы можем использовать мощный инструмент Lucene CheckIndex (http://t.cn/Rs0gKjCl), который позволяет нам сканировать и восстанавливать проблемные сегменты, обычно требующие очень небольшой потери данных. Мы обычно рекомендуем пользователям Elasticsearch просто переиндексировать данные (переиндексировать), но если по какой-то причине это невозможно и данные очень важны, то это путь, по которому можно идти, даже если для этого требуется довольно много ручной работы. А время зависит от количества фрагментов и их размера.
Инструмент Lucene CheckIndex включен в дистрибутив Elasticsearch по умолчанию, дополнительная загрузка не требуется.
Если CheckIndex обнаруживает проблему и ее предложение исправить это выглядит разумно, вы можете указать CheckIndex применить исправление, добавив параметр командной строки -fix.
9. Хранение снимка
Вы можете быть удивлены, как все эти файлы преобразуются в хранилище, используемое хранилищем моментальных снимков. Не думайте больше об этом: возьмите этот кластер, используйте его в качестве снимка моего снимка для шлюза на основе файловой системы и проверьте файлы в хранилище, мы найдем эти файлы (некоторые файлы для краткости опущены):

В корневом каталоге у нас есть индексный файл, который содержит информацию обо всех снимках в этом хранилище, и у каждого снимка есть связанный снимок и файл метаданных.
Файл снимка в корневом каталоге содержит информацию о состоянии снимка, индексе, содержащемся в снимке, и так далее. Файл метаданных в корневом каталоге содержит метаданные кластера на момент моментального снимка.
Когда установлено сжатие: true, LZF используется для сжатия метаданных и файлов моментальных снимков, а LZF фокусируется на скорости сжатия и распаковки, что делает его очень подходящим для Elasticsearch.
Данные хранятся с заголовком: ZV + 1 байт, указывающим, сжаты ли данные. После заголовка в формате будет один или несколько сжатых блоков по 64 КБ: длина блока 2 байта + несжатый размер 2 байта + сжатые данные. Используя эту информацию, вы можете использовать любую программу распаковки, совместимую с LibLZF.
На уровне индекса есть еще один файл index / / index_name> / snapshot-
На уровне сегмента вы найдете два файла: переименованный индексный файл Lucene и файл снимка сегмента: indices /
Вам может быть интересно, почему эти файлы были переименованы, а не просто сохранили свои исходные имена файлов, что может быть проще использовать непосредственно на диске.
Причина проста: вы можете сделать снимок индекса, прежде чем делать еще один снимок, удалить его и воссоздать. В этом случае несколько файлов будут иметь одинаковое имя, но разное содержимое.
10. Резюме
В этой статье мы рассмотрели файлы, которые Elasticsearch записывает в каталог данных на разных уровнях: на уровне узла, индекса и уровня сегмента. Мы увидели, где хранится индекс Lucene на диске, и кратко описали, как использовать инструмент Lucene CheckIndex для проверки и исправления проблемных фрагментов.
Надеюсь, вам не нужно ничего делать с содержимым каталога Elasticsearch, но всегда полезно знать, какие данные ваша любимая база данных на основе поиска записывает в файловую систему!
Вам не нужно полностью помнить точное значение каждого файла, важно знать, куда идти и быстрее находить вещи, когда это важно.
11. Дополнительное познание
Один фрагмент данных, записанный в es, сгенерирует несколько фрагментов данных для разных методов запросов, которые будут занимать больше дискового пространства, чем исходные данные. «Кодек»: «best_compression» в настройке индекса сжимается для _source, а алгоритм сжатия — степень сжатия 6 с дефляцией.
Выполните следующую корреляцию с приведенной выше таблицей люценов.
Файл, в котором хранится исходный _source.fdt.fdm.fdx;
Хранение файлов с инвертированным index.tim .tip .doc;
Файлы хранения столбцов, используемые для сортировки агрегации. Dvd .dvm;
Полнотекстовый поиск файлов .pos .pay .nvd .nvm и т. Д.
Файлы, загруженные в память: .fdx .tip .dvm,
Среди них .tip занимает больше всего памяти, а файлы .fdt .tim .dvd занимают больше всего диска, например
11.5M _ap9_1w3.liv 25.0G _ap9.fdt 31.9M _ap9.fdx 444K _ap9.fnm 53.1G _ap9_Lucene50_0.doc 64.2G _ap9_Lucene50_0.tim 781M _ap9_Lucene50_0.tip 87.7G _ap9_Lucene54_0.dvd 920K _ap9_Lucene54_0.dvm104.0K _ap9.si
Кроме того, если сегмент небольшой, содержимое файла сохраняется в файле .cfs. Файл .cfe хранит информацию о расположении файлов Lucene в файле .cfs. Это позволяет сократить количество дескрипторов файлов, открытых Lucene.
Слишком много осколков на узле es приведет к нехватке памяти, вы можете выполнить статический индекс
Определения
Основные понятия в Lucene включают: указатель, документ, поле и термин. Индекс содержит последовательность документов
- Документ представляет собой последовательность полей
- Поле представляет собой последовательность именованных терминов
- Термин — это последовательность байтов
Одна и та же последовательность байтов в двух разных полях считается другим термином. Поэтому термин выражается в виде пары: строка с именем field и байты в поле.
Говоря о перевернутом индексе, как выглядит первый ряд в первую очередь? Предполагая, что документ 1 содержит [китайский, английский, японский], документ 2 содержит [английский, японский, корейский], а документ 3 содержит [корейский, китайский], а затем в соответствии с документом, чтобы найти содержание
- Документ 1-> 【китайский, английский, японский】
- Документ 2-> 【Английский, Японский, Корейский】
- Документ 3-> 【корейский, китайский】
В свою очередь, найти документы на основе содержания
- Китайский-> 【Документ 1, Документ 3】
- Русский-> 【Документ 1, Документ 2】
- Японский-> 【Документ 1, Документ 2】
- Корейский-> 【документ 2, документ 3】
Это перевернутый индекс, и Lucene хорош в этом.
- TextField: индексирование и сегментация слов, не содержит векторов слов, в основном используется для текста
- StringField: индексировать без сегментации слова, вся строка индексируется как один тег, например, ее можно использовать для «названия страны» или «идентификатора», или для любого другого поля, которое вы хотите использовать для сортировки
- IntPoint: индекс типа int для точного / диапазона запроса
- LongPoint: длинный тип индекса для точных / диапазонных запросов
- FloatPoint: индекс типа Float для точных / диапазонных запросов
- DoublePoint: индекс двойного типа для точных / диапазонных запросов
- SortedDocValuesField: поле, в котором хранится значение BytesRef каждого документа, индекс используется для сортировки, если вам нужно сохранить значение, вам нужно использовать экземпляр StoredField
- SortedSetDocValuesField: поле, в котором хранится набор значений BytesRef для каждого документа, индекс используется для огранки / группировки / объединения, если вам нужно сохранить значения, вам нужно использовать экземпляр StoredField
- NumericDocValuesField: поле, в котором хранится длинное значение каждого документа, используемое для оценки / сортировки / извлечения значения
- SortedNumericDocValuesField: поле, в котором хранится набор длинных значений для каждого документа, используемый для оценки / сортировки / извлечения значения
- StoredField: используется для извлечения только сохраненного значения в сводном результате
Индекс Lucene может состоять из нескольких субиндексов или сегментов. Каждый сегмент является полностью независимым индексом, который можно использовать для поиска отдельно. Индекс включает в себя
- Создать новые сегменты для вновь добавленных документов
- Объединить существующие сегменты
Поиск может включать несколько сегментов и / или несколько индексов, и каждый индекс может состоять из набора сегментов.
Lucene указывает на каждый документ целочисленным номером документа, первый номер документа, который должен быть добавлен к индексу, равен 0, а номера документов, добавленные впоследствии, последовательно увеличиваются. Обратите внимание, что номер документа может измениться, поэтому вам следует быть очень осторожным при хранении этих значений вне Lucene.
Обзор структуры индекса
Каждый сегментный индекс включает в себя информацию
- Информация о сегменте: содержит метаданные о сегменте, такие как номер документа, используемые файлы
- Имена полей: содержит коллекцию имен полей, используемых в индексе
- Сохраненные значения полей: для каждого документа он содержит список пар атрибут-значение, где атрибут является именем поля. Они используются для хранения вспомогательной информации о документе, такой как его заголовок, URL или идентификатор для доступа к базе данных.
- Словарь терминов: словарь, содержащий все термины, используемые во всех индексных полях всех документов. Словарь также включает номер документа, содержащий термин, и указатель на частоту и близость термина
- Данные частоты терминов: для каждого термина в словаре — количество всех документов, содержащих термин и частоту термина в документе, если частота не опущена (IndexOptions.DOCS)
- Данные о близости терминов: для каждого термина в словаре позиция, в которой термин появляется в каждом документе. Обратите внимание, что если во всех полях всех документов отсутствуют данные о местоположении, они не будут существовать
- Коэффициенты нормализации: для каждого поля в каждом документе сохраните значение, которое будет умножено на соответствующий показатель в этом поле.
- Векторы терминов: для каждого поля в каждом документе вы можете сохранить вектор термина, который состоит из текста термина и частоты термина
- Значения для документа: аналогично сохраненным значениям, они также используют номер документа в качестве ключа, но обычно предназначены для загрузки в основную память для быстрого доступа. Сохраненные значения обычно используются для суммирования результатов поиска, и каждое значение документа полезно для таких вещей, как факторы оценки.
- Актуальные документы: необязательный файл, указывающий, какие документы являются активными
- Значения точек: необязательные пары файлов, запись размера поля индекса для быстрой фильтрации числового диапазона и больших значений (например, BigInteger, BigDecimal (1D), пересечение географической формы (2D, 3D))
Наименование файла
Все файлы, принадлежащие сегменту, имеют одинаковые имена и разные расширения. При использовании составных индексных файлов эти файлы (за исключением файлов с сегментной информацией, файлов блокировки и удаленных файлов документов) будут сжаты в один .cfs Файл. Когда любой индексный файл сохраняется в каталоге, ему присваивается имя файла, которое никогда не использовалось.
Без SQL: учимся работать с данными на Elasticsearch
Elasticsearch — это поисковый и аналитический движок, с помощью которого ваша команда может быстро искать информацию в любых типах данных и анализировать их.
Он позволяет управлять релевантностью результатов и проводить масштабирование.
Объемы данных растут все быстрее и быстрее. Их становится сложнее структурировать и выделять полезную информацию. Так реляционные базы данных отходят на задний план, а хранилища и поисковые системы без использования SQL становятся все популярнее.
Elasticsearch — это распределенный механизм на основе архитектуры RESTful. Наряду с Kibana, Beats и Logstash, Elasticsearch — это компонент комплекта приложений Elastic Stack, который дает возможность надежно и безопасно получать данные из любого источника и в любом формате, искать, анализировать и визуализировать данные в режиме реального времени.
С помощью Elasticsearch можно решать многие задачи:
- добавить поле поиска на сайт или в приложение;
- хранить и анализировать журналы, метрики;
- автоматически моделировать поведение данных в режиме реального времени с помощью машинного обучения;
- автоматизировать рабочие процессы;
Кроме прочего, нужно сказать, что Elasticsearch — это программное обеспечение с открытым исходным кодом, которое распространяется бесплатно.
Хранение и поиск данных
Документы
Elasticsearch предназначен для работы с большими объемами данных, которые могут быть как структурированными, так и неструктурированными.
Он не хранит данные в реляционной БД. Для этого понадобилось бы много разных таблиц и связей между ними. Не говоря уже о том, что при появлении каждого нового типа данных пришлось бы выполнять уйму работы, чтобы внести изменения.
Вместо этого информация хранится в виде сериализованных документов JSON. Этот формат позволяет хранить произвольные структуры данных.
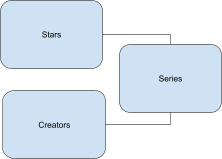
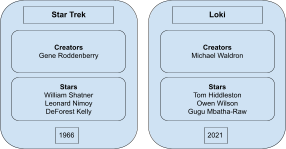
Например, коллекцию сериалов можно представить так:
| В СУБД | В виде объектов |
 |
 |
В формате JSON эти объекты записываются просто:
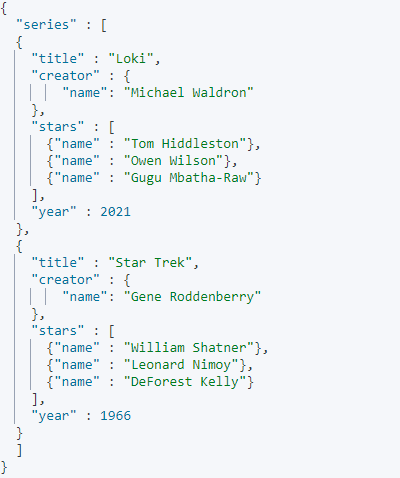
Удобно, что пользователи сами могут определять структуру данных в документах. Из них проще извлекать информацию, и их можно легко менять.
Поиск
В руководстве по Elasticsearch утверждается, что полнотекстовый поиск осуществляется в течение одной секунды. Если Elasticsearch работает с большим объемом данных, как ему удается проводить поиск по всему их тексту в режиме, близкому к реальному времени?
Это возможно благодаря использованию обратного индекса. При индексировании составляется список уникальных слов, встречающихся во всех документах, со ссылками на документы, в которых содержится каждое слово. Поэтому Elasticsearch создан на базе библиотеки для полнотекстового поиска Apache Lucene, в которой используется обратный индекс.
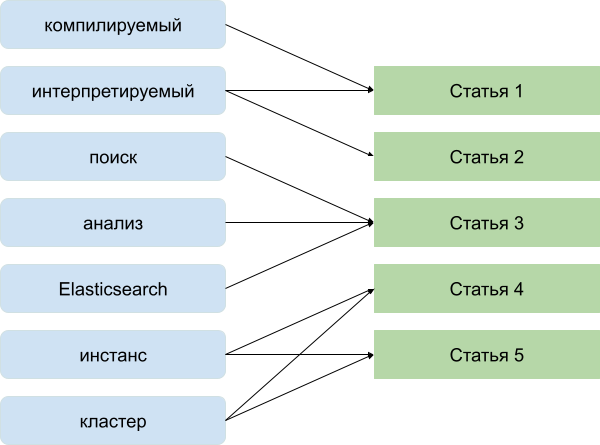
Поиск с помощью Elasticsearch
Elasticsearch не зависит от схем данных. Когда включено динамическое связывание типов, Elasticsearch автоматически выявляет и добавляет в индекс новые поля, распознавая целые и дробные числа, строки, булевские значения и даты.
При необходимости можно определить правила для динамического связывания. Это позволит анализировать текст в зависимости от языка, на котором он написан, использовать пользовательские форматы дат, отличать полнотекстовые строки от строк с точными значениями и распознавать форматы, которые не могут быть распознаны автоматически.
Кроме того, одно и то же поле можно проиндексировать по-разному для разных целей, например, для полнотекстового поиска и в качестве тега.
Индекс
Elasticsearch использует индекс Lucene, который напоминает базу данных: данные находятся в пространстве имен и для их упорядочения используется схема. По своей сути индекс представляет собой логическую группу, состоящую из одного или нескольких физических сегментов (shards), которые являются экземплярами Lucene.
В результате распределения документов между сегментами и распределения сегментов между узлами обеспечивается отказоустойчивость, благодаря которой вы защищены от сбоев аппаратного обеспечения.
Давайте сравним Elasticsearch, MongoDB и PostgreSQL с точки зрения возможностей, обеспечиваемых индексом.
| Elasticsearch | MongoDB | PostgreSQL |
| Поисковик | Хранилище документов | База данных |
| Документы JSON со связями (mappings) в индексе | Документы BSON в коллекциях | Данные в таблицах |
| Одна запись, много чтений. Высокая скорость поиска | Высокая эффективность операций, связанных с записью | Высокая эффективность операций, связанных с записью |
| Гибкая схема | Гибкая схема | Схема обязательна, что дает возможность проводить операции, которые иначе было бы невозможно провести |
Если имеется большой объем данных, использование распределенного индекса снижает нагрузку на систему. Она работает не с большим объемом данных, а со сравнительно небольшими индексами.
Поэтому в Elasticsearch предусмотрена возможность регулировать количество сегментов в параметре index.number_of_shards . По умолчанию его значение равно 5, но вы можете изменить его в зависимости от того, сколько сегментов будет участвовать в поиске.
Кроме того, следует учесть, что по мере заполнения данными Elasticsearch объединяет малые сегменты в большие, поэтому нужно следить за тем, чтобы они не становились слишком крупными и не снижали эффективность работы.
Сегменты бывают первичными и реплицированными. Реплицированный сегмент — это копия первичного сегмента. Реплики обеспечивают избыточность и защищают оборудование от сбоев, а также повышают скорость обработки запросов. Вы можете в любой момент изменить количество реплик, но количество первичных сегментов фиксируется на момент создания индекса.
Масштабирование
Elasticsearch — распределенная система. В ней разделены не только индексы. Сегменты хранятся на отдельных машинах, которые называют узлами. В свою очередь, узлы объединяются в кластеры.
Когда нагрузка возрастает, Elasticsearch добавляет узлы в кластер и автоматически распределяет нагрузку между всеми доступными узлами. По мере добавления узлов в кластер растет и скорость выполнения запросов. В результате ваше приложение не перегружается и в то же время обеспечивается его доступность и масштабируемость. Когда же нагрузка спадает, количество узлов уменьшается и нагрузка перераспределяется. Такой вид масштабирования называется горизонтальным.
Кластеры и управление ими
Чтобы получать информацию из распределенной системы, масштаб которой со временем изменяется, нужно определять, когда и к каким сегментам следует обращаться. Поэтому узлы данных объединяются в кластеры, где существуют также координирующие узлы, которые выполняют именно эту функцию.
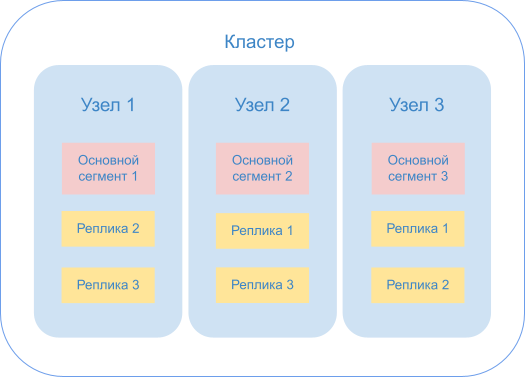
Кластер — это группа узлов с одним и тем же значением атрибута cluster.name . Если запущен один экземпляр Elasticsearch, то кластер состоит из единственного узла. Все первичные узлы находятся на нем, и он готов к использованию. Но создать на нем реплицированные сегменты невозможно, поэтому в случае сбоя могут быть потеряны данные.
Добавление узлов в кластер повышает его емкость и надежность. Когда в кластер добавляется узел, реплицированные сегменты выделяются автоматически, и его отказоустойчивость повышается.
По умолчанию добавляемый узел может быть как узлом данных, так и master-узлом, который управляет кластером. Рекомендуем помещать в кластер небольшое фиксированное количество узлов, которые могут быть выбраны основными ( master-eligible nodes ). Такие узлы отвечают, например, за создание или удаление индекса, отслеживание узлов, которые входят в кластер, и принятие решений о распределении сегментов между узлами. Добавлять же в кластер лучше те узлы данных, которые не могут быть выбраны основными.
Основные узлы обеспечивают управление кластером и позволяют избежать конфликтов между координирующими узлами, например, в случае перемещения сегментов с узла на узел. Поскольку у них есть вся информация о состоянии кластера, таким узлам требуется повышенный объем ресурсов и стабильное оборудование.
Репликация данных
Если данные только в одном экземпляре, то существует возможность их потерять, если откажет узел, на котором они хранятся. Чтобы избежать этого, создаются реплики на других узлах. В отличие от резервных копий — это полные копии всех данных.
Когда используются реплики, запись данных производится сначала в первичный сегмент, а уже после слияния и фиксации в Lucene изменяются все реплики.
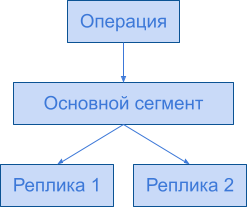
Чтобы не потерять данные, лучше создать реплики
Для обеспечения отказоустойчивости нужно создать реплику каждого сегмента. Общее количество реплик должно быть не меньше количества узлов данных. Тогда при отказе одного узла можно будет пользоваться репликой данных на другом узле во время восстановления поврежденного. Чтобы использовать реплики эффективно, можно указать их количество в параметре number_of_replicas .
Отказоустойчивость
Мы рассмотрели, как обеспечить отказоустойчивость в случае отказа узла данных. Но как обезопасить систему на случай сбоя основного узла? Ведь его потеря приведет к тому, что весь кластер перестанет быть работоспособным.
На этот случай можно создать несколько основных узлов. На роль основного узла могут претендовать узлы, которые могут быть выбраны основными.
Когда отказывает один такой узел, новым основным узлом будет выбран тот, который обладает самой актуальной информацией о кластере. Выбор делается при достижении кворума во время голосования узлов, которые имеют право голоса. Он должен быть нечетным и составлять 50% + 1 голос.
В голосовании участвуют узлы, для которых в конфигурации указано значение параметра node.voting_only: true . Это узлы, которые предназначены только для голосования. Конфигурация голосования изменяется автоматически, и нужно следить за тем, чтобы включенных узлов было не меньше тех, которые составили бы кворум (контрольное количество голосующих).
Взаимодействие
Для взаимодействия с кластером извне и для взаимодействия узлов между собой используются различные протоколы, которые мы сравнили в таблице ниже.
API можно вызывать синхронно и асинхронно.
Частый запуск и остановка клиентов узлов приводит к лишнему «шуму» в кластере.
Также существуют отдельные библиотеки для:
- JavaScript (только поиск для приложений);
- Node.js (поисковый клиент для приложений и рабочего места);
- PHP (только поиск для приложений);
- Python (клиент для корпоративного поиска);
- Ruby (клиент для корпоративного поиска).
Заключение
Эффективность Elasticsearch как поискового движка обеспечивается благодаря обратному индексу и распределению данных. По мере увеличения или уменьшения их объема он удобно масштабируется, вы можете не переживать о потере данных — они надежно защищены с помощью реплик и избыточных узлов.
С чего начинается Elasticsearch
 Elasticsearch, вероятно, самая популярная поисковая система на данный момент с развитым сообществом, поддержкой и горой информации в сети. Однако эта информация поступает непоследовательно и дробно.
Самое первое и главное заблуждение — «нужен поиск, так бери эластик!». Но в действительности, если вам нужен шустрый поиск для небольшого или даже вполне себе крупного проекта, вам стоит разобраться в теме поподробней и вы откажетесь от использования именно этой системы.
Вторая проблема заключается в том, что пытаясь разобраться с начала, получить общую картину окажется непросто. Да инфы навалом, но последовательность в ее изучении выстраивается постфактум. Придется из книг бежать в документацию, а из документации обратно в книги, параллельно разгугливая тонкости, только чтобы понять, что такое Elasticsearch, почему он работает именно так и для чего же его вообще использовать, а где стоит выбрать что-то попроще.
В этой статье я попытался последовательно объяснить то что мне кажется главным в Elasticsearch, то для чего он был придуман и как он устроен.
Для наглядности выдумаем себе задачу. Реализация поиска в коллективном блоге по всем материалам и пользователям. Система позволяет создавать теги, сообщества, геометки и все остальные штуки, которые нам помогают категоризировать огромное количество информации.
Схема хранения данных
То, какие действия с данными мы будем производить определит схему их хранения:
- скорее всего поисковая система должна будет быстро производить поиск
- запись и удаление могут не отличаться высокой скоростью, в системах поиска, полагаю, этим можно пренебречь
- структура данных будет интенсивно изменяться и хранилище может заполняться из нескольких независимых источников( различных баз, в том числе внешних для нашей системы )
Представьте еще раз сколько атрибутов может иметь публикация и сколько связанных с ней объектов. Автор, категория, сообщество, геометки, медиафайлы, теги, связанные публикации. Этот список можно продолжать до исчерпания фантазии. Если мы храним это в привычной реляционной базе то имеем миллион связей и миллиард атрибутов. Это прекрасно подходит для структурированного хранения долгие годы, но не очень вяжется с требованиями быстрого поиска.
А что если мы захотим добавить пару интеграций с внешними системами? Придется реализовать дополнительные таблицы или даже базы. Нам всегда будет нужно что-то добавить или изменить в объектах доступных для поиска. Вы понимаете к чему я клоню.
Намного быстрее читать из объектов, содержащих все необходимое здесь и сейчас. И намного проще вносить изменения в неструктурированную схему данных.
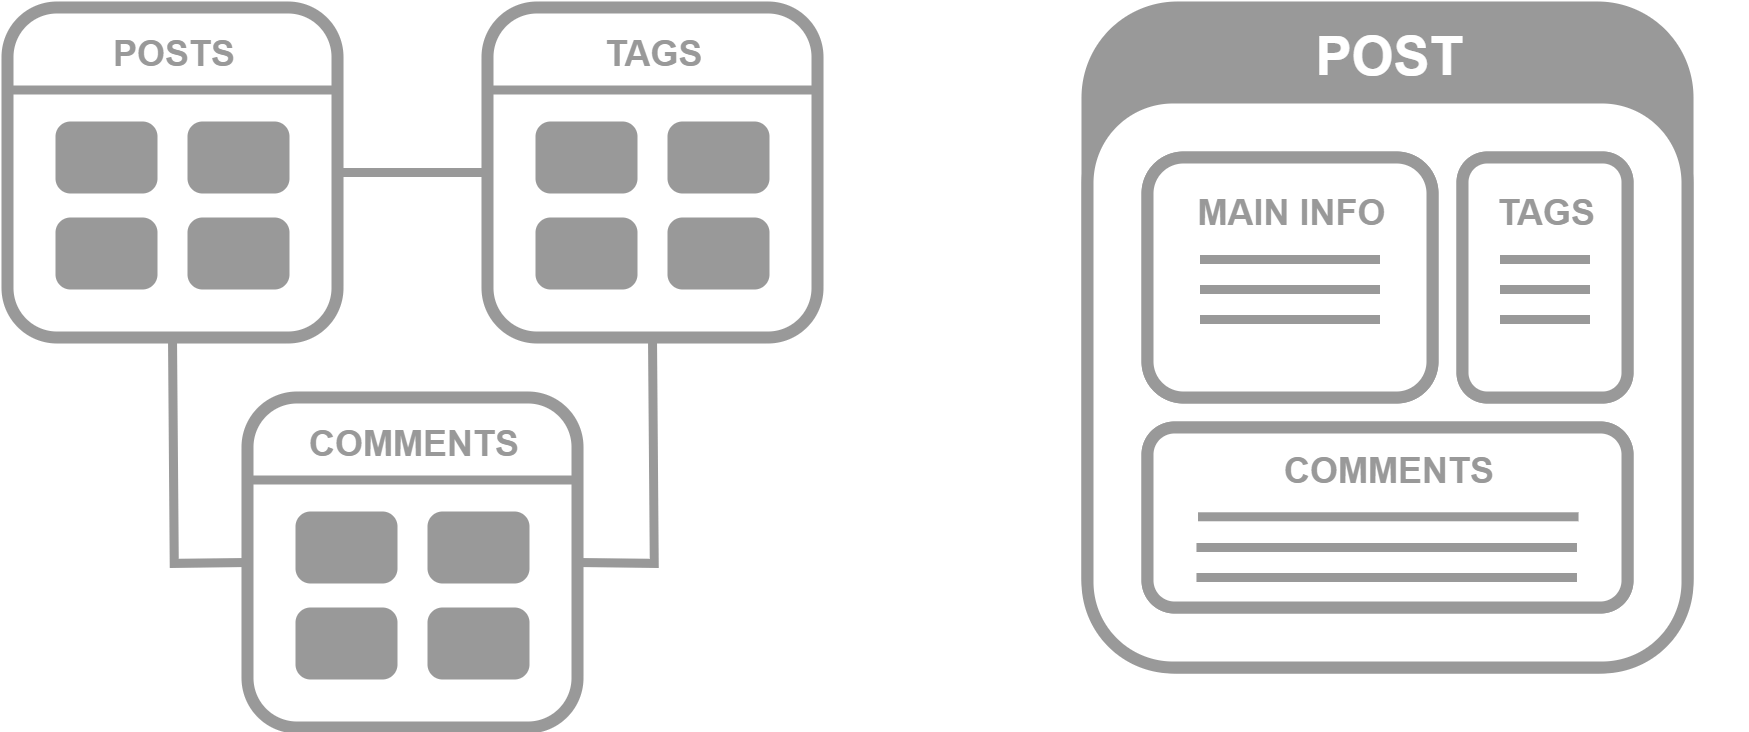
К тому же такие структуры данных проще делить, разносить по разным физическим хранилищам, распределять, ведь объекты уже содержат все необходимое.
Эти объекты мы можем воспринимать как отдельные страницы, файлы, карточки, все это можно назвать некими документами. Поэтому такая модель хранения данных называется документоориентированной.
Поиск
Теперь необходимо определиться с механизмами поиска. Данные организованы в виде документов. Как мы привыкли осуществлять поиск по документу?
Типичным примером документа будет веб-страница. Если мы попытаемся поискать по всей странице в браузере, поиск будет осуществляться по всему содержащемуся тексту. И это удобно для большинства кейсов.
Примерно так же работают многие поисковые системы, поиск происходит по всему тексту проиндексированных страниц, а не по отдельным полям, тегам или заголовкам. Это называется полнотекстовым поиском.
Искать предстоит по огромному количеству документов и было бы разумно запомнить что в каком документе лежит. В реляционных СУБД мы привыкли оптимизировать подобный поиск индексами.
Что такое индекс на самом деле? Если не вдаваться в детали, индекс это сбалансированное дерево, то есть дерево, в котором длина путей(количество шагов межу узлами) не будет отличаться больше чем на один шаг.

Например если бы мы проиндексировали наш пост, то у нас бы получилось дерево, листьями которого, являлись бы используемые в нем слова. Простыми словами, мы будем знать заранее, какие слова находятся в документе и как их быстро в нем найти. Не смотря на такую удобную структуризацию данных, обход дерева звучит как не самое лучшее решение для максимально быстрого поиска.
А что если сделать все наоборот — собрать список всех используемых слов и узнать, в каких документах они встречаются. Да, индексация займет больше времени, но нас в первую очередь интересует именно скорость поиска, а не индексации.
Такой индекс называется обратным индексом и используется для полнотекстового поиска.
Хороший пример — популярная open-source библиотека полнотекстового поиска, конечно же, с обратным индексом, Apache Lucene.
Масштабирование
Как бы мы не пытались оптимизировать структуры данных и алгоритмы поиска, когда речь заходит о действительно больших массивах данных и действительно большом количестве запросов, необходимо задуматься о возможности повлиять на производительность системы путем увеличения аппаратного ресурса. Проще говоря, мы хотим иметь возможность накинуть немного памяти, ЦП и дискового пространства, чтобы все ехало быстрее. Мы можем назвать это масштабируемостью.
Самый простой вариант — накинуть железа на сервер. Если представить каждую условную единицу вычислительной мощности как деревянный кубик, то сейчас мы сложим кубики в одно место или один на другой, строя башню вертикально. Такое масштабирование и называется вертикальным.
Второй вариант — разделить наши задачи на группу машин. В этом случае мы тоже увеличиваем аппаратный ресурс, но сейчас кубики мы можем расположить на воображаемом столе как угодно на его плоскости, то есть горизонтально. Угадайте, как называется такое масштабирование?
Первый способ гарантирует нам быстрый результат без боли, но конечно не все так гладко. Как долго мы сможем увеличивать ресурс отдельной машины? Во-первых дешевым способом это будет только в самом начале, дальше оплата одного сервера будет стоить как несколько машин попроще. Во-вторых вы рано или поздно упретесь в потолок — железо, драйверы, пропускная способность и еще куча логических и физических ограничений. А самое главное, критический сбой в одной машине повлечет сбой всей системы, закономерно.
В отличии от первого способа второй не накладывает таких явных ограничений, мы можем добавлять машины сколько угодно, связывая их сетью. Конечно, это повлечет сетевые издержки — низкая скорость передачи в сети(в сравнении с обработкой на одной машине), сетевой оверхед. Но вместе с тем сеть имеет одно очень важное свойство — большую отказоустойчивость.
Распределенный индекс
Ок, для хранения данных и поиска мы будем использовать инстанс Lucene. Но ранее мы решили, что для обеспечения горизонтального масштабирования нам необходимо иметь возможность размещать данные на разных машинах. В действительности, какая разница как данные хранятся физически? Важно чтобы мы имели единое логическое хранилище. Каждый инстанс Lucene должен стать частью одного большого индекса, или осколком(shard) разбитого индекса. Шард будет выполнять непосредственно операции по поиску и записи данных.
Shard в Elasticsearch — это логическая единица хранения данных на уровне базы, которая является отдельным экземпляром Lucene.
Index — это одновременно и распределенная база и механизм управления и организации данных, это именно логическое пространство. Индекс содержит один или более шардов, их совокупность и является хранилищем.
Классическое сравнение индекса с другими базами выглядит примерно так.
| Elasticsearch | SQL | MongoDB |
|---|---|---|
| Index | Database | Database |
| Mapping/Type | Table | Collection |
| Field | Column | Field |
| Object(JSON) | Tuple | Object(BSON) |
Но существуют отличия в использовании этих абстракций. Рассмотрим еще один классический пример. У пользователя системы может храниться очень много информации, и мы решаем создавать новую базу для каждого пользователя. Это звучит дико! Но на самом деле в Elasticsearch это распространенная и даже хорошая практика. Индекс это довольно легкий механизм и лучше разделять большие данные, тем более, когда это логически оправдано. Системе проще работать с небольшими индексами чем с разросшейся базой для всего. Например, так вы можете создавать отдельный индекс для логов на каждый день и это широко используется.
По умолчанию количество шардов для индекса будет равным 5, но его всегда возможно изменить в настройках index.number_of_shards: 1 или с помощью запроса шаблонов индекса.
Важно управлять этим значением. Всегда принимайте решения с точки зрения параллельной обработки.
Каждый шард способен хранить примерно 2 32 или 4294967296 записей, это значит, что скорее всего вы упретесь в лимит вашего диска. Однако стоит понимать, все шарды будут участвовать в поиске и если мы будем искать по сотне пустых, потратим время впустую. Если шарды будут слишком большими мы так же будем тратить лишнее время на поиск, а так же операций перемещения и индексации станут очень тяжелыми.
Забегая вперед. Со временем Elasticsearch двигает и изменяет шарды, объединяя дробные и мелкие в большие. Следите за размером ваших шардов, при достижении 10ГБ производительность значительно падает.
Кластер
Мы определились с базовой концепцией распределенного индекса. Сейчас необходимо решить, как в действительности будет осуществляться управление отдельными базами.
Ранее мы решили, что за операции поиска и индексации отвечает отдельный инстанс Lucene(шард). Для того, чтобы обращаться к распределенной системе шардов, нам необходимо иметь некий координирующий узел, именно он будет принимать запросы и давать задания на запись или получение данных. То есть помимо хранения данных мы выделяем еще один вариант поведения программы — координирование.
Таким образом мы изначально ориентируемся на два вида узлов — CRUD-узлы и координирующие узлы. Назовем их data node и coordinating node. У нас есть куча машин объединенных в сеть и все это очень напоминает кластер.
Каждый запущенный экземпляр Elasticsearch является отдельным узлом(node). Cluster — это совокупность определенных нод. Когда вы запускаете один экземпляр ваш кластер будет состоять из одной ноды.
- Ноды должны иметь одинаковую версию
- Имя кластера cluster.name в конфигурации должно быть одинаковым
Конфигурация читается из файла elasticsearch.yml и переменных среды. Здесь мы можете настроить почти все, что касается неизменных в рантайме свойств ноды.
Вы можете поднимать несколько узлов на одной машине, для этого необходимо запускать инстансы из разных директорий файловой системы и в конфигурации указать разные порты http.port , по умолчанию порт 9200 для внешнего доступа и 9300 для внутрикластерного соединения. Это может понадобиться для тестирования и проектирования кластера, однако в проде подразумевается использование отдельных машин.
Каждый тип ответственности узлов налагает определенные системные требования. Очевидно, что data-ноды будут часто обращаться к диску и использовать значительные объемы памяти в процессе работы.
Мы так же можем утверждать, что не все данные будут запрашиваться одинаково часто. Данные постепенно «остывают» по мере снижения запросов. Мы можем назвать это жизненным циклом хранения данных. Хорошей идеей было бы держать хайповые публикации там, откуда их можно быстро достать, а забытые мемы 2007 можно положить подальше.
Начиная с версии 6.7 Elasticsearch предлагает механизм управления жизненным циклом. Для этого доступны три типа нод — hot, warm и cold.
- hot — 1:30
- warm — 1:100
- cold — 1:500
Для того чтобы определить тип ноды как data node необходимо установить значение в конфигурации node.data: true , при этом рекомендуется выделять ноду под один конкретный тип, для повышения стабильности и производительности кластера.
Важнейшим аспектом в использовании распределенных систем является параллельное выполнение задач. Существует популярная модель распределенных вычислений, которая имеет лаконичное название MapReduce. И заключается она разделении выполнения задачи на два больших шага:
- Map — предварительная обработка данных, формулировка задачи и последующая ее передача выполняющим узлам
- Reduce — свертка множества результатов worker-нод в один финальный ответ

Именно такой механизм поможет нам выполнять операции с шардами. Координирующий узел получит запрос, предварительно переформулирует его для внутрикластерного взаимодействия и выполнит запросы к нашим worker-нодам(в данном случае к data-нодам).
Следовательно, coordinating-ноды должны иметь достаточный ресурс памяти, ЦП и быструю сеть, но при этом могут иметь скромный диск, ведь не осуществляют хранения данных.
Однако при большой частоте запросов, такие ноды могут стать узким местом системы. Мы можем пойти привычным путем и превратить точку внешнего доступа в плоскость. Пусть координирующих нод будет множество.
Такой подход позволит нам применять балансировку запросов, это можно сделать прямо в клиентском коде либо использовать любые существующие балансировщики.
Управление кластером
На данном этапе мы имеем возможность доступа к данным из множества точек — coordinating-нод. В этом нет проблем, если мы говорим о простых операциях чтения/записи в существующий индекс. Но если говорить о выделении новых шардов или их перемещении, может начаться путаница.
Предположим, возможность coordinating-нодам управления состоянием кластера. Один узел примет решение о перемещении шарда на одну data-ноду, а второй о перемещении того же на другую. Список возможных общекластерных действий может быть довольно широким, а список возможных конфликтов еще шире.
Очевидно такие важные решения должен принимать один центральный узел. Мы определили, что для каждого типа действий необходимо выделять отдельную роль, чтобы избежать потерь производительности на ноде. И «главный в кластере» звучит как отдельная ответственность.
Назовем такие ноды master-node. Активный мастер всегда должен быть один, он будет управлять топологией кластера: создавать новый индекс, выделять и распределять шарды, перемещать их и объединять в случае необходимости. Мастер всегда знает все о состоянии кластера.
В кластере Elasticsearch обязательно должен быть как минимум один узел отвечающий требованиям master node. Для этого в конфигурации ноды необходимо установить значение node.master: true .
Master-ноды отвечают за важные, но довольно легкие общекластерные действия. Это означает, что они требуют большого ресурса и высокой стабильности от физической ноды. В кластерах от 10 нод необходимо всегда выделять отдельные only-master узлы.
Репликация данных
Сейчас каждая запись в нашем индексе существует только в одном месте, и потеря хранящего ее узла приведет к потере данных на неопределенный срок. Для того, чтобы этого избежать существует механизм репликации. Важно не путать понятия реплики и бэкапа, если бэкап позволяет восстановить данные в случае утери, то реплика является полной копией базы.
Если мы потеряем одну из data-нод, то всегда сможем продолжить работу с репликами шардов в другом узле и тем временем вернуть потерянный.
То есть для каждого шарда должна быть как минимум одна копия на другой ноде. Можно конечно выделять по отдельной машине для каждой реплики, но это очень расточительно. Нужно разместить копии данных на разных узлах, но это не значит, что эти узлы должны хранить только шарды реплик.

Чтобы жестко установить количество реплик индекса используется параметр number_of_replicas . Так же мы можем изменить это значение в рантайме выполнив запрос:
Таким образом мы всегда имеем реплики всех шардов и не поднимаем неэффективно простаивающие ноды.
Основной шард назовем первичным или primary shard, а любую из его копий реплицирующим шардом или replica shard, первичный шард и его реплики это группа репликации.
С учетом реплик запись данных будет происходить в два этапа, в первом запись затронет только первичный шард и только после того, как произойдет операция flush слияния изменений и операция commit фиксации в индексе Lucene, будет отправлен внутренний запрос на изменение всех реплик.
- green — все ок
- yellow — есть утраченные шарды, кластер полностью работоспособен, но едет на репликах
- red — есть утраченные шарды, кластер неработоспособен или часть данных недоступна
Для максимальной стабильности кластера необходимо, чтобы количество дата-нод было больше или равно количества реплик.
Отказоустойчивость
Сейчас данные будут доступны даже в случае сбоя одного из хранящих узлов. Но что если кластер потеряет мастера? Потеря единственного мастера равноценна потере кластера.
Тут все по привычной схеме — поднимаем несколько мастеров.
Но если у нас есть, например, два управляющих узла, как понять, какой из них в данный момент должен управлять кластером? Как они смогут договориться о своих решениях? Очевидно, что в каждый момент времени должен быть только один управляющий кластером узел.
То есть при потере мастера его место должен занять один из кандидатов.
- node.master: true
- node.data: true
Представим. Главный управляющий узел стал недоступен для кластера, кластер берет первого кандидата и устанавливает его на вакантное место. Спустя определенное время первый мастер возвращается в кластер и ничего не знает о том, что его место уже занято. Мастер-ноды являются своего рода его мозгом, и теперь мозг кластера становится разделен. Это классическая проблема распределенных систем и она так и называется split-brain problem.
В обществе подобные проблемы зачастую решаются путем голосования. Подобный механизм используется и в распределенных системах. Как только кластер теряет управляющий узел, должен быть запущен процесс голосования.
Важно определить какой из кандидатов больше всего подходит на роль главного узла. Такой кандидат должен обладать самой актуально информацией о кластере. Для краткого описания актуальности информации о кластере может использоваться версионирование. При каждом изменении кластера главный узел будет обновлять некую служебную информацию и повышать номер версии, далее то же самое будет параллельно происходить в нодах-кандидатах.
Сравнив номера версий мы можем определить наиболее подходящих кандидатов на роль мастера. Теперь если отпавшая мастер-нода вернется в кластер, то процесс голосования запустится снова и будет выбран единственный управляющий узел.

Теперь важно понять когда можно считать, что голосование прошло успешно? Если проголосовали все участники? Или половина? Или другое любое другое магическое количество?
Решение этой проблемы заключается в определении кворума. Это умное название для контрольного количества голосующих.
Очевидно, что такое важное решение как выбор мастера должно приниматься на основе большинства, то есть 50%+один голос. Справедливо, надежно. Это значение и станет кворумом.
Таким образом, количество кандидатов на мастера должно быть нечетным и не меньше трех. Рекомендуется использовать простую формулу для расчета оптимально количества таких нод:
КОЛИЧЕСТВО_КАНДИДАТОВ = ОБЩЕЕ_КОЛИЧЕСТВО_НОД/2 + 1
Решения для любых общекластерных действий принимаются путем голосования, и вся необходимая для голосования информация содержится в конфигурации голосования. Право голоса определяет еще одну роль, ведь право голоса не означает, что узел может быть кандидатом.
В Elasticsearch узлы, которые могут участвовать в голосовании можно определить в конфигурации: node.voting_only: true .
Elasticsearch автоматически изменяет конфигурацию голосования при изменении кластера. Поэтому нельзя одновременно отключать половину или более голосующих нод. Например, если в вашей конфигурации в данный момент 7 голосующих нод и вы отключили сразу 4, кластер станет недоступным, потому что останется 3 ноды, а в конфигурации голосования кворумом является значение 4.
Теперь, если кластер разделится на две части, узлы меньшей, пропинговав доступные в ней узлы и сравнив их количество со значением кворума, будут знать, что именно они отпали от кластера и не могут участвовать в принятии решений.
Транспорт
Пришло время поговорить о том, как общаться с кластером из внешних систем, и как будут общаться узлы внутри кластера. Есть ряд плюсов и минусов использования и традиционных, и специальных протоколов. Для краткого сравнения существует таблица.
| Протокол | Достоинства | Недостатки |
|---|---|---|
| HTTP | Низкий порог вхождения, в сравнении с нативным протоколом. Для использования нужен только HTTP клиент и погнали. HTTP API никогда не ломает совместимость, при обновлении версии ES, ваше приложение продолжит работать так же. Возможно проксировать и использовать балансировщики нагрузки. JSON. | Клиент не знает топологию кластера, поэтому может потребовать большее количество запросов для получения данных. Оверхед. |
| ES Native | Лучший выбор для ОЧЕНЬ больших данных. Если необходимо выполнить большое количество операций с индексом, нативный протокол значительно ускорит. | Используется под JVM. Использование влечет жесткую связность с ES. Обновления требуют перекомпиляции и повторного развертывания пользовательских клиентов. Возможны обновления ломающие совместимость. |
Заключение
Хочется верить, что прочитав эту статью вы поняли основы распределенных поисковых систем. Возможности масштабирования и отказоустойчивости — это то для чего был создан Elasticsearch и то, почему он приобрел популярность.
Я постарался кратко и последовательно рассказать о том, как и почему именно так это устроено. В этой статье я намеренно не стал упоминать об экосистеме Elastic, плагинах, запросах, токенизации, маппинге и остальном. Так же я не сказал об Ingest и machine learning нодах, на мой взгляд, они дают дополнительные возможности и не являются базовыми.
Name already in use
Elasticsearch (эластичный поиск) — распределённый (distributed), RESTful поисковой движок по всему тексту (full-text search).
Elasticsearch использует JSON-документы без схемы. Эти документы передаются при помощи REST API для сохранения их в хранилище и поиска.
Elasticsearch построен поверх поискового движка Apache Lucene, написанном на Java.
Индекс, тип, документ
Индекс (Index) — эквивалент базы данных в SQL или NoSQL.
Тип (Type) — эквивалент таблицы в SQL или коллекции в NoSQL.
Имеется тип по умолчанию, который создаётся автоматически ( _doc ) при создании индекса.
Документ (Document) — эквивалент строки в SQL или документа в NoSQL.
Документы хранятся в JSON-формате
Полнотекстовый поиск и индексирование
Полнотекстовый поиск (Full text searching) — поиск документов не по их идентификаторам, а по их содержимому.
Индексирование (Indexing) в поисковых системах — процесс добавления сведений (о сайте) роботом поисковой машины в базу данных, которая используется для полнотекстового поиска информации на проиндексированных сайтах.
В рамках Elasticsearch индексированием называют запись данных в индекс.
Реплики и шарды
Индексы обычно разредяются на несколько подиндексов (sub-indices), называемые осколками, шардами (shards). Каждый шард хранит какую-то часть документов индекса.
Шардинг (Sharding) — процесс разбиения на шарды и одна из стратегий масштабирования баз данных.
Шарды распределяются между несколькими узлами, экземплярами приложения (Elasticsearch nodes).
Каждый шард является экземпляром дижка Lucene. Таким образом все данные хранятся в Lucene, а Elasticsearch распределённо управляет этими данными.
Количество шардов указано в настройках индекса в свойстве number_of_shards .
Резервная копия всех шардов называется репликой (replica). Если один экземпляр приложения падает вместе с данными, которые на нём хранились, реплика позволяет не терять эти данные.
Репликация (Sharding) — процесс, при котором данные постоянно реплицируются (копируются) на один или несколько других серверов. Репликация тоже является стратегией масштабирования баз данных.
Количество реплик указано в настройках индекса в свойстве number_of_replicas .
Elasticsearch хранит данные как перевёрнутые индексы (inverted indexes) на диске, что позволяет очень быстро искать данные.
Поисковой движок Apache Lucene реализует перевёрнутый индекс, используя структуру данных список с пропусками (Skip List). Эта структура данных основана на связных списках, но по трудоёмкости сравнима с двоичным деревом поиска (B-tree).
Разработчики Lucene выбрали список с пропусками вместо двоичного дерева, поскольку он требует меньшее число обращений к диску.

Индекс в Lucene очень похож на индекс в конце книги: указываются определённый список ключевых слов (важных определений) и рядом страницы, на которых они упоминаются.
Аналогично работает и Google. Рядом с проиндексированными словами сохраняются ссылки на страницы. Таким образом их можно найти при поиске. Это же касается и Elasticsearch, только вместо ссылок на страницы используются ссылки на документы.
Пример с разбиением на слова
Посмотрим, как обратные индексы работают на примере.
Пусть у нас есть два текста.
- I don’t like to work alone .
- I often work on weekends .
Разобьём их на слова и выберем только уникальные слова из обоих текстов.
Множество уникальных слов будет следующим: I , don’t , like , to , work , alone , often , on , weekends .
Сохраним каждое уникальное слово в память, а рядом с ним — ссылки на те документы, которые используют это слово.
| Слово | Документ #1 | Документ #2 |
|---|---|---|
| I | + | + |
| don’t | + | |
| like | + | |
| to | + | |
| work | + | + |
| alone | + | |
| often | + | |
| on | + | |
| weekends | + |
Теперь произведём поиск по словам. Документ либо содержит слово, либо не содержит.
Например, поиск по слову work выдаст оба документа, по слову like — только первый, по слову often — только второй.
Если ввести искать по двум словам одновремено often и alone , то выдадутся оба документа.
| Слово | Документ #1 | Документ #2 |
|---|---|---|
| alone | + | |
| often | + |
Маппинги и типы данных
Маппинг (mapping) — процесс, определяющий, как документ и поля в нём хранятся и индексируются.
Маппинги задаются при создании индекса в поле mappings . Они содержат свойства документов и типы их значений.
Поскольку маппинги могут быть разными для разных типов type индекса, они привязываются не к самому индексу, а к самим типам (например, к типу по умолчанию _doc ). Поэтому при создании маппинга нужно всегда указывать тип.
Если mappings не задаётся при создании индекса, то Elasticsearch создаёт его автоматически в режиме реального времени на основании данных индексируемых документов.
Для создания индекса используется PUT-запрос с его названием.
Простые типы данных
- Строковые (string): text , keyword .
- Числовые (Numberic): long , integer , short , byte , double , float , half_float , scaled_float .
- Логический (Boolean): boolean .
- Дата (Date): date .
- Бинарный (Binary): binary .
- Диапазон (Range): integer_range , float_range , long_range , double_range , date_range .
Тип данных text
Строковый тип text используется для индексирования полнотекстовых значений (full-text values). Примерами полнотекстовых значений являются поля: название, сообщение, описание.
Полнотекстовые значения анализируются, то есть обрабатываются перед индексированием.
Каждое полнотекстовое поле проходит перед индексированием через анализатор (analyzer), который конвертирует строку в список отдельных термов (list of individual terms), затем этот список индексируется, а поле называют проанализированным (analyzed).
Анализирование (analysis) позволяет Elasticsearch искать отдельные слова в каждом полнотекстовом поле.
Поля текстового типа не используются для сортировки, обычно не используются для агрегаций.
Задание типа text .
Тип данных keyword
Строковый тип keyword (ключевое слово) используется для индексирования таких значений, как: ID , email , hostname , status code , tag и прочих. Эти значения используются для фильтрации, сортировки и агрегации.
Поля типа keyword не анализируются. Они ищутся только по точному значению, совпадению (exact value). Например, нельзя найти tom@gmail.com по слову tom или gmail .
Задание типа keyword .
Составные типы данных
- Объект (Object): object . Для JSON-объекта.
- Вложенный (Nested): nested . Для массива JSON-объектов.
Объект (Object) предназначен для хранения JSON-объектов.
JSON-объекты могут содержать в себе другие JSON-объекты, то есть они имеют иерархичную структуру.
Например, для индексируемого объекта ниже
может быть задан следующий маппинг.
Elasticsearch распознаёт, что поле settings является объектом, благодаря свойству properties . Вложенные свойства properties отображают иерархию JSON-объектов.
Массив (Array) в Elasticsearch не существует как отдельная сущность, поскольку любое поле может иметь одно или несколько значений по умолчанию. Тем не менее, все эти значения должны быть одного типа.
- Массив строк: [«1», «two»] .
- Массив чисел: [1, 7] .
- Массив объектов [< "name": "John", "experience": 5 >, < "name": "Sam", "experience": 3 >] .
В массиве объектов нельзя выделить конкретный объект. При такой необходимости нужно использовать тип nested .
Массивы смешанных типов не поддерживаются: [1, «two»] .
Пустой массив интерпретируется как отсутствующее значение (поле без значений).
Вставка объекта с массивом tags .
Особенность массива объектов
В массиве объектов Elasticsearch не рассматривает объекты как независимые сущности, поэтому Elasticsearch просто разбивает их на список полей и значений.
Например, вставка следующего массива объектов
будет преобразована в два поля с несколькими значениями.
Связь между полями firstName и lastName теряется и они уже больше не являются одним объектом.
Поэтому при поиске следующий запрос не выдаст совпадений.
Сравнение массива объектов и вложенного типа
Вложенный тип данных (Nested datatype) — специальный подтип объекта ( object ), который позволяет индексировать массив JSON-объектов таким образом, чтобы объекты можно было получать отдельно друг от друга.
Специализированные типы данных
- IP: ip . Для IPv4 и IPv6 адресов.
- Completion (Completion datatype): completion . Для автозаполнения предложений.
- Join: join . Для создания отношений между документами одного индекса.
- Search-as-you-type: search_as_you_type . Для поиска по мере ввода.
Elasticserach предоставляет возможность хранить одно и то же полt несколькими способами для разных целей. Такое поле называется мультиполем (multi-field).
Например, текстовое поле может быть одновременно представлено типом text для полтотекстового поиска и типом keyword для сортировки и агрегаций.
Для определения мультиролей используется свойство fields , значением которого выступает объект. Ключом этого объекта является название мультиполя, а в значении описывается тип.
Например, создадим текстовое поле position , которое может быть использовано как ключевое слово.
Теперь, при необходимости использования position как ключевого слова, необходимо писать position.keyword , иначе оно будет работать как текстовое значение.
Получение текущих маппингов
Текущие маппинги индекса можно получить по GET-запросу _mappings .
Работа с данными
Создание индекса с названием index_name .
В последних версиях Elasticsearch рекомендуется не создавать тип, а использовать тип по умолчанию _doc .
Создание документа в типе type_name индекса index_name .
Обновление документа по ID
Обновление документа типа _doc в индексе users по id.
Удаление документа по ID
Удаление документа типа _doc по id.
Группировка нескольких запросов в один (bulk)
Elasticasearch предоставляет возможность группировки нескольких изменяющих данные запросов в один при помощи специального POST-запроса /_bulk .
При помощи этого запроса можно манипулировать данными в нескольких индексах и их типах одновременно.
Запрос и его тело выглядят примерно следующим образом.
- create — создание документа. Выдаёт ошибку, если документ с указанным _id уже существует.
- index — создание документа (аналогично create , но без ошибки, а с замещением существующего).
- update — обновление части документа, указанной в переданном свойстве doc .
- delete — удаление документа.
Указание _index является обязательным, указание _id — нет (это поле может быть сгенерировано автоматически).
Можно также указать type , но поскольку он не указан, все документы индексируются в _doc .
В конце тела запроса обязателен переход на новую строку.
Пример вставки двух пользователей
Для получения документов индекса используется запрос /_search .
Вид запроса, параметры запроса и ответ
Получить информацию о всех документах можно отправив GET-запрос, ничего не указывая.
Ответ выглядит следующим образом.
Наиболее полезная информация лежит в свойстве hits : hits.total.value — количество всех докуметров, удовлетворяющих поиску, hits.hits — массив самих документов (хранятся в _source ) и дополнительной информации о них. По умолчанию возвращается только 10 документов (см. Пагинация).
По конкретному слову (все поля документа)
Поиск по конкретному слову (слову ops ) во всех полях (и name , и job ).
Elasticsearch предоставляет Query DSL (Domain Specific Language) — предметно-ориентированный язык, позволяющий описывать запрос query в формате JSON и отправлять его в теле запроса (request body). Тело можно отравлять даже с GET-запросами.
Создатели Elasticsearch предлагают рассматривать Query DSL как абстрактное синтаксическое дерево (AST, Abstract Syntax Tree) запросов, которое имеет два типа предложений (clauses):
- Листовые, конечные (leaf query clauses). Предназначены для поиска определённого значения в определённом поле. Пример: match , term , range .
- Составные (compound query clauses). Предназначены для логического объединения листовых и других составных предложений. Пример: bool .
Основные запросы Elasticsearch
Запрос с match_all
Является самым простым запросом, поскольку возвращает все документы и не принимает какие-либо параметры.
Сам по себе избыточен, но может использоваться в комбинации с более сложными запросами.
В запрос с match передаётся текстовое, числовое, логическое значение или дата. Результатом поиска становятся документы, которые соответствуют переданному значению.
Если значением является текст, то он анализируется перед поиском. Поэтому запрос с match является стандартным для полнотекстового поиска.
Пример поиска пользователя с именем Sam .
Краткая версия запроса.
В запрос с term так же передаётся текстовое, числовое, логическое значение или дата.
В отличии от запроса с match , результатом запроса с term являются документы, которые содержат точный терм (exact term) в указанном поле.
Текстовое значение, переданное в запрос с term не анализируется. Но данные документов уже проанализированы перед индексированием, поэтому поиск может выдать неверные результаты и лучше не использовать запрос с term для полей типа text , а использовать с типом keyword .
Запрос с terms аналогичен запросу с term, но позволяет передать несколько допустимых значений вместо одного.
Важно отметить, что при работе с массивом значений в документе свойства term и terms ищут не точное совпадение, а включение (contains). Оба примера выше с term и с terms включат в выборку документ со значением [«a», «b», «c»] .
Запрос с range позволяет задать промежуток значений для конкретного поля. Результатом станут документы, удовлетворяющее промежутку.
Предоставляемые свойства для задания промежутка:
- gt — больше (greater than).
- lt — меньше (less than).
- gte — больше или равно (greater than or equal to).
- lte — меньше или равно (less than or equal to).
Пример запроса для поиска пользователей от 18 до 25 лет.
Запрос с exists и missing
Запрос с exists (с missing ) позволяет находить документы, у которых значение конкретного поля присутствует (отсутствует).
Поиск по нескольким полям
Для поиска по нескольким полям используется запрос с multi_match .
Можно задавать приоритеты полей при помощи символа ^ . В примере ниже firstName в два раза важнее lastName .
Если свойство fields не указано, то по умолчанию Elasticsearch берёт из маппинга все поля индекса, которые удовлетворяют типу искомого значения, и ищет по этим полям.
За пагинацию отвечают параметры size и from запроса _search .
Параметр size определяет количество возвращаемых документов. Значение по умолчанию: 10.
Свойство from отвечает за смещение документов (количество документов, которые должны быть пропущены).
Создадим индекс films с объектами, имеющими поля name (keyword), date , rating .
Проиндексируем 3 фильма.
Сделаем поисковый запрос к индексу и добавим параметр size .
Добавим также параметр from .
Релевантность, контекст запроса и контекст фильтра
По умолчанию Elasticsearch ищет по релевантности, которая показывает, насколько запрос документ удовлетворяет поисковому запросу.
Релевантность определяется оценкой релевантности (relevance score). Эта оценка зависит от самого поискового запроса, а также от контекста.
В контексте запроса (query context) предложения (query clauses) отвечают на вопрос «Насколько хорошо документ удовлетворяет запросу?». Помимо выяснения, соответствует ли документ запросу или нет, вычисляется оценка релевантности и записывается в мета-свойство _score в ответе.
Контекст запроса относится к параметру query .
В контексте фильтра (filter context) предложения отвечает на запрос «Удовлетворяет ли документ запросу?». Ответом является либо да, либо нет, и документ либо включается в выборку, либо нет в соответствии с ответом.
Примером фильтра являются свойства filter и must_not для запроса с bool , о которых будет рассказано далее.
Фильтр (в программировании) — функция или программа, которая принимает структуру данных (обычно список) и возвращает новую структуру данных, содержащую только те элементы из исходной структуры, которые удовлетворяют заданному условию.
Elasticsearch предоставляет составное предложение bool , которое позволяет задавать условия запроса и комбинировать их.
Предложение bool принимает объект, свойства которого обозначают логические операции.
- must — аналог логического И (AND, объединение условий).
- should — аналог логического ИЛИ (OR, пересечение условий).
- must_not — аналог логического НЕ (NOT, исключение). Выполняется в контексте фильтра, поэтому не высчитывает оценку релевантности.
Также bool предоставляет свойство filter . Оно работает аналогично must , но в контексте фильтра, поэтому вычисление оценки релевантности игнорируется.
Каждое из указанных выше свойств может принимать объект, содержащий условие, или массив таких объектов.
Условия задаются при помощи свойств match , term , terms , range .
Пример поиска специалиста с фильтрами
В следующем примере производится поиск специалиста, который:
- Имеет позицию Software Enginer И знает технологии React , Vue (must).
- Имеет опыт работы более одного года ИЛИ его желаемый уровень заработной платы не привышает 1000$ (should).
- Его возраст НЕ меньше 25 лет. (must_not).
Важное замечание про should
Несмотря на то, что should работает как логическое ИЛИ, позволяя задавать несколько условий, не все из которых должны выполняться одновременно, по умолчанию при наличии must ни одно из условий should не должно обязательно выполняться.
В этом случае should просто увеличивает значимость тех документов (увеличивая значение _score , которое по умолчанию = 1), которые удовлетворяют заданным условиям, но не исключает из выборки те документы, которые не условиям удовлетворяют.
Чтобы это исправить, нужно использовать свойство minimum_should_match . Оно позволяет задать минимальное количество условий should , которые должны выполниться, чтобы документ попал в выборку.
По умолчанию свойство minimum_should_match = 1, если отсутствуют must или filter , 0 — иначе.
В примере ниже искомый специалист обязательно должен или иметь опыт больше года, или иметь желаемую зарплату меньше 1000$.
Если количество условий в should совпадает с minimum_should_match , то should вернёт те же документы, что и must при тех же условиях.
Если количество условий в should меньше, чем minimum_should_match , то вернётся пустая выборка.
Elasticsearch позволяет при поиске сортировать документы по одному или нескольким полям.
За сортировку (sort) отвечает параметр sort .
Сортировка может производиться по возрастанию ( asc , ascending) и по убыванию ( desc , descending).
При сортировке по нескольким полям более приоритетным является то поле, которое указано первым в массиве.
Elasticsearch также поддерживает сортировку полей, значениями которых являются массивы. В этом случае доступны следующие режимы ( mode )
- min — сортировка по минимальным значениям массивов.
- max — сортировка по максимальным значениям массивов.
- avg — сортировка по средним значениям массивов.
- sum — сортировка по сумме значений массива.
Пример сортировки фильмов по рейтингу и дате
Воспользуемся примером из раздела с пагинацией.
Сортировка индекса films по убыванию рейтинга и даты.
film 3 является самым старым, но имеет выше рейтинг, а рейтинг приоритетнее даты, поскольку указан раньше в параметре sort . film 2 имеет такой же рейтинг, как и film 1 , но по дате он новее.
Обработка больших объёмов данных (scroll)
Один поисковой запрос в Elasticsearch не может обработать более 10000 элементов.
Свойство size не может превышать 10000 элементов. Параметр from , отвечающий за пагинацию, не может захватить элементы с индексом, большим 10000. Свойство total также не может возвращать более 10000 элементов.
Можно повысить лимит, увеличив значение параметра index.max_result_window value в настройках индекса settings . Но делать это не желательно без крайней необходимости, поскольку поисковые запросы занимают память кучи (heap memory) и время пропорционально формуле max(max_result_window, from + size) . Если убрать лимит, то лимит памяти будет отсутствовать и кластер может упасть от перенагрузки. Лучше получать данные меньшими порциями.
Когда необходимо обработать более 10000 документов одного индекса, следует использовать Scroll API .
Scroll позволяет возвращать большое количество результатов (или все результаты) аналогично курсору (cursor) в традиционных базах данных.
Scroll не используется для пользовательских запросов в режиме реального времени, но используется для получения больших объёмов данных, чтобы как-то обработать их (например, проиндексировать все документы индекса заново с обновлённой конфигурацией индекса или скопировать их для записи куда-либо).
Контекст поиска (Search context) — состояние, которые поддерживается в течение всей операции поиска в шарде. Чем больше параллельных (concurrent) поисковых операций выполняется, тем больше объектов поискового контекста существуют одновременно. Когда поисковая операция завершается, контекст поиска удаляется.
Как работать со Scroll API
К обычному поисковому запросу следует добавить query-параметр scroll и в качестве значения передать туда время, которое будет жить поисковой контекст до следующего вызова.
Для оптимальной работы поисковой контекст должен жить как можно меньше, но этого времени должно хватать, чтобы обработать результат предыдущего результат запроса. Поставим 1 минуту в качестве времени жизни поискового контекста.
Основные единицы времени
- h — час.
- m — минута.
- s — секунда.
- ms — миллисекунда.
В ответ на такой GET-запрос приходит ответ, который помимо привычных свойств содержит
- Достоверный hits.total (количество всех документов в индексе, не ограниченное лимитом в 10000).
- _scroll_id — идентификатор контекста поиска, который используется для получения следующей части результатов.
Каждый запрос со scroll возвращает в свойстве _scroll_id ссылку на текущий контекст поиска, по которой можно сослаться на следующую порцию результатов. Эта ссылка может меняться, а может оставаться прежней (то есть при двух идентичных последовательных запросах можно получить разные данные) — важно использовать её последнюю версию.
Для запроса со scroll контекст поиска создаётся при первоначальом (initial) запросе и живёт для выполения последующих запросов.
Для получения следующей порции результатов используется запрос следующего вида (в запросе отсутствует название индекса). Каждый такой запрос устанавливает своё время жизни следующего запроса. Время начинает считаться с момента, когда предыдущий запрос вернул данные.
Когда время жизни контекста поиска истекает, получить дальнейшие документы при помощи scroll не получится. Выдаётся ошибка о том, что контекст поиска не существует.
Важно отметить, что использование from запрещено при использовании scroll .
После завершения работы со scroll можно удалить его вручную, не дожидаясь, пока истечёт время его жизни. Это освободит занимаемую память.
Псевдокод для работы со scroll
Получать данные при помощи scroll можно рекурсивно примерно следующим образом.
Анализаторы (Analyzers) определяют способ, которым данные будут анализироваться перед индексацией.
Анализ текста (Text analysis) — процесс преобразования обычного текста в структурированный формат, оптимизированный для поиска. Используется, когда установлен тип данных text .
После анализа текст поля разделяется на термы (terms). Таким образом, после анализа поле представлено в виде списка термов (list of terms), в котором оно и индексируется.
Elasticsearch предоставляет набор встроенных анализаторов (build-in analyzers).
Для их будем анализировать фразу «- How old are you? — I’m 17.» .
Чтобы проверить, как работает конкретный анализатор, можно отправить следующий запрос.
- Стандартный: standard . Используется по умолчанию. Разбивает текст на слова, переводит их в нижний регистр ( lowercase ), удаляет знаке препинания, при необходимости удаляет стоп-слова.
- Простой: simple . Разделяет слова каждый раз, когда встречает не букву. Все термы переводятся в нижний регистр.
- Стоп-анализатор: stop . Как simple , но с возможностью удалять стоп-слова. По умолчанию используются стоп-слова английского языка (вспомогательные глаголы, предлоги и так далее).
- Пробельный: whitespace . Разделяет текст, когда находит пробельные символы.
- Анализатор ключевых слов: keyword . Принимает текст и его возвращает как есть.
- Языковой: english , french . Анализирует текст соответственно специфике языка. Удаляет стоп-слова, характерные языку. Переводит в нижний регистр.
- Шаблонный: pattern . Для разделения текста на термы использует регулярные выражения. По умолчанию используется регулярное выражение \W+ (всё, что не может быть словом). Переводит в нижний регистр.
Чтобы расширить функциональность встроенного анализатора (например, заменить стоп-слова или заменить регулярное выражение), необходимо создать пользовательский анализатор (custom analyzer) в настройках индекса ( settings ), что обычно делается при создании индекса.
Пользовательские анализаторы существуют в пределах индекса.
Например, создадим пользовательский анализатор, который игнорирует слово old . Для этого добавим его в поле stopwords .
Проверим, как анализируется текст «- How old are you? — I’m 17.» .
Для более гибкой настройки пользовательских анализаторов необходимо ознакомиться с блоками, из которых состоит каждый анализатор.
Анализатор является пакетом, который состоит из нескольких строительных блоков: фильтры символов, токенизатор, фильтры токенов.
При преобразовании текста эти блоки вызываются в указанном выше порядке.
Фильтр символов (Character filter) принимает оригинальный текст в качестве потока символов и трансформирует этот поток, добавляя, удаляя и изменяя символы.
Например, римские цифры ( I , II , III ) могут переводиться в арабские (1, 2, 3).
У анализатора может быть несколько фильтров символов или не быть вообще. Они применяются в указанном порядке.
Токенизатор (Tokenizer) принимает поток символов (stream of characters), разбивает его на отдельные токены (individual tokens) и возвращает поток токенов. Чаще всего токенами являются отдельные слова.
Процесс разбиения потока символов на токены называется токенизацией (tokenization).
Именно благодаря токенизации доступен полтотекстовый поиск, ведь каждый токен индексируется отдельно.
Ранее было показано, как токенизаторы встроенных анализаторов разделяют текст на токены (термы).
Токенизатор также отвечает за порядок термов (порядок может меняться).
Один анализатор имеет ровно один токенизатор.
Фильтр токенов (Token filter) принимает поток токенов (stream of tokens) и транмформирует его, удаляя, добавляя и изменяя токены.
Например, фильтр токенов lowercase переводит все токены в нижний регистр, фильтр stop удаляет стоп-слова, фильтр synonym добавляет синонимы в поток токенов.
У анализатора может быть несколько фильтров токенов или не быть вообще. Они применяются в указанном порядке.
Когда токенизатор превращает поток символов в поток токенов, он запоминает позицию ( position ) каждого токена в потоке и число позиций ( positionLength ), которые охватывает токен.
Это позволяет построить ориентированный (имеющий направление движения) ациклический (без циклов) граф, который называется графом токенов (token graph).
Каждая позиция представляет вершину графа (node).
Каждый токен представляет дугу графа (edge), указывающую на следующую позицию.
Фильтры токенов могут добавлять новые токены (например, синонимы) в поток токенов, а значит и в граф токенов.
Синонимы записываются на ту же позицию, что и существующие токены.
По умолчанию токен занимает только одну позицию, то есть его positionLength равняется 1.
Но некоторые синонимы могут занимать несколько позиций. Например, расшифровки аббревиатур (CSS, Cascading Style Sheets).
Фильтры, которые могут добавлять многопозиционные токен, называются фильтрами токенов графа ( graph token filters). Такими являются фильтры synonym_graph и word_delimiter_graph .
В то время, как благодаря токенизации доступен полтотекстовый поиск, каждый отдельный токен при поиске сравнивается посимвольно.
- При поиске How , токен how не пройдёт проверку на совпадение.
- При поиске user , токен users не пройдёт проверку на совпадение.
- При поиске hello , токен hi не пройдёт проверку на совпадение.
Чтобы этого избежать, можно нормализовать (normalize) данные, то есть привести их к стандартному формату. Таким образом токены не будут точно совпадать (not exact match), но будут достаточно похожи, чтобы попасть в результат поиска.
К примеру, токен Hello может быть переведено в нижний регистру ( be lowercased ), users может быть приведён к его корневому слову user (stemmed), hello и hi являются синонимами и могут индексироваться как единственное слово hello .
Анализатор индекса и анализатор поиска
Анализ текста осуществляется дважды
- при индексации документа (Index time)
- во время поиска (Search time, query time).
Анализатор индекса (Index analyzer) анализирует текстовые данные перед индексацией.
Анализатор поиска (Search analyzer) анализирует текс поискового запроса ( query ).
В большитсве случаев эти анализаторы должны иметь одинаковый набор правил токенизации и нормализации.
Например, при текст «Hello our USERS!» может быть преобразован анализатором индекса в [hello, our, user] , а текст поискового запроса «Hi user» — анализатором поиска в [hello, user] .
| Слово | Поиск | Индекс |
|---|---|---|
| hello | + | + |
| our | + | |
| user | + | + |
Тогда документ со значением «Hello our USERS!» в текстовом поле попадёт в результат поиска по запросу «Hi user» .
Разные анализаторы поиска и инекса
Иногда может появиться необходимость использовать разные анализаторы индекса и поиска.
Например, когда мы хотим, чтобы убрать из поиска некоторые нежелательные результаты.
В этом случае можно указать отдельный анализатор для поиска.
Можно также задать разные анализаторы для конкретного поля при создании индекса в mappings .
В главе Составляющие анализатора было рассказано, что такое токенизатор.
Помимо перечисленных ранее функций, токенизаторы также задают тип токенов (token type).
Простые токенизаторы разбиват текст на слова и задают тип word . Другие токенизаторы могут задавать типы <ALPHANUM> , <HANGUL> , <NUM> .
- Ориентированные на слова.
- Токенизаторы частичных слов.
- Токенизаторы структурированного текста.
Ориентированные на слова
Ориентированные на слова токенизаторы (Word oriented tokenizer) разбивают текст на отдельные токены, которые явяются словами.
Задаваемый тип токенов: word .
Токенизаторы частичных слов
Токенизаторы частичных слов (Partial word tokenizer) разбивают текст или слова на маленькие фрагменты для проверки на частичное совпадение слов.
Токенизаторы структурированного текста
Токенизаторы структурированного текста (Structured text tokenizer) обычно используются не для полнотекстового поиска, а для идентификаторов ( id , email , phone и так далее).
Настройки индекса (settings)
У каждого индекса при создании задаётся набор настроек.
Получение текущих настроек индекса
Текущие настройки индекса можно получить по GET-запросу _settings .
Количество шардов указано в настройках индекса в свойстве number_of_shards .
Количество реплик указано в настройках индекса в свойстве number_of_replicas .