Манчестерский код для чайников
Манчестерский Код — это самосинхронизирующийся двоичный код без постоянной составляющей, в котором значение каждого передаваемого бита определяется направлением смены логического уровня в середине обусловленного заранее временного интервала. Поскольку логических уровней у самой маленькой единицы информации (бит) на данный момент известно всего два (1 и 0), вариантов тут немного: либо смена 1 => 0 либо 0 => 1. Согласно общепринятым стандартам для Манчестерского кода переход от нуля к единице считается 1, а если наоборот, то 0. На самом деле последнее утверждение — это просто формальность — вопрос в том, с какой стороны посмотреть 😉 Главное, чтобы и приёмник и передатчик смотрели на жизнь одинаково.

Введите число и нажмите «Encode Manchester!«:
Теперь давайте внимательно посмотрим на картинку и попробуем проанализировать и перечислить основные преимущества и недостатки преобразования данных в Манчестерский Код:
Pазмер данных увеличивается вдвое — это негативно сказывается на скорости передачи
Kоличество логических нулей всегда равно количеству логических единиц, соответственно у такого сигнала не будет постоянной составляющей — это крайне важно для электрических цепей и радиоволн
Комбинация логических уровней 11 однозначно говорит о последнем принятом 0, а комбинация 00, соответственно, говорит о 1. Таким образом после одной из них приёмник синхронизируется
Не может идти последовательно более двух одинаковых логических уровней, т.е. комбинация типа 111 или 000 невозможна
В начале данных и в конце не может быть двух одинаковых логических уровней — только 10 или 01
Сначала пишем тест
О пользе тестов можно почитать тут. В контексте решения текущей задачи будет использоваться техника Mock-объектов, поэтому для тестирования используется связка gtest (Google Test) + gmock (Google Mocking Framework). Всё это добро поставляются в исходниках, поэтому единственное требование к системе — совместимый C / C++ компилятор, например gcc g++ для Linux или Visual Studio C++ для Windows. Так выглядит простое консольное приложение, которое будет собираться вместе с тестами и запускать их:
Теперь сами тесты. Более простой задачей является преобразование данных в Манчестерский Код (encode), поэтому с неё, пожалуй, и начнём:
Все тесты помещены в макрос TEST_F() . В начале теста с помощью EXPECT_CALL() необходимо установить ожидаемое поведение. В процессе преобразования 0 => 1010101010101010 и при условии, что старший бит идёт первым (MSB), ожидается последовательный вызов методов On_Man_Encode_One() и On_Man_Encode_Zero() и так восемь раз. После того, как ожидаемое поведение описано, необходимо вызвать проверяемый метод Man_Encode() . Если реальное поведение отличается от ожидаемого, в процессе выполнения тестов будет сообщено об ошибке. В конце каждого теста также выполняется проверка условия, что количество нулей равно количеству единиц.
Преобразовать данные в Манчестерский Код очень легко:
Реализация обратной задачи — декодирования данных из Манчестерского Кода в оригинальный несколько сложнее. Перед началом передачи данных необходимо синхронизироваться с приёмником сиигнала. В реализации тестов нас особо не интересует как именно приёмник синхронизируется и в какой последовательности будут вызваны(если вообще будут) On_Man_Decode_Add_1() и On_Man_Decode_Add_0() — для этой цели обозначим предварительные ожидания как testing::AtMost(1) . После синхронизации процесс декодирования можно точно спрогнозировать и описать соответствующие ожидания с помощью EXPECT_CALL() . Также как и в предыдущем случае в конце каждого теста проверяется отсутствие постоянной составляющей (количество нулей и единиц должно совпадать).
Предположительная реализация процесса декодирования Манчестерского кода:
Сборка и запуск тестов
Если Вы работаете в связке Windows + Visual Studio, необходимо выполнить следующее:

При использовании Linux + gcc g++:

Тестов много не бывает. Например, было бы неплохо добавить проверку для последовательности из двух байт и более, или проверку условия отсутствия невозможных для Манчестерского Кода комбинаций — например 111 или 000. Чем больше терпения и выдержки на этом этапе разработки — тем крепче будет сон после её сдачи в эксплуатацию.
Практика
Тесты это хорошо, но пока что всё это больше похоже на теорию — а теория без практики, как известно, скучна. Поэтому, если Вы дочитали до этого момента, милости прошу посетить следующий пост, в котором в качестве приёмника и передатчика используются два микроконтроллера, а сам процесс эмулируется в виртуальной среде, которая умеет моделировать поведение электрических цепей.
Манчестерский код (Manchester)
Манчестерский код относится к самосинхронизирующимся импульсным кодам и имеет два уровня, что обеспечивает хорошую помехозащищенность. Каждый такт (битовый интервал) делится на две части. Информация кодируется перепадами потенциала, происходящими в середине каждого такта.
Единица кодируется перепадом от высокого уровня сигнала к низкому, а ноль — обратным перепадом. В начале такта может происходить служебный перепад сигнала (при передаче несколько единиц или нулей подряд).
Рассмотрим частные случаи кодирования, как в предыдущих случаях.


При манчестерском кодировании обязательное изменение сигнала в середине каждого битового интервала позволяет легко выделить тактовый синхросигнал. Поэтому манчестерский код обладает хорошими самосинхронизирующимися свойствами.
Сигнал не содержит постоянную составляющую, частота основной гармоники сигнала находится в интервале от fо=N/2 Гц до fо=N Гц, изменяясь в зависимости от вида битового потока.
Манчестерское кодирование использовалось в ранних версиях технологии Ethernet со скоростью передачи 10 Мбит/с.
Дифференциальный манчестерский код (Differential Manchester)
Логические значения «0» и «1» передаются соответственно наличием или отсутствием смены уровня сигнала в начале тактового (битового) интервала. В середине битового интервала имеет место обязательная смена значения сигнала.

Дифференциальное манчестерское кодирование
Этот код обладает теми же самыми преимуществами и недостатками, что и манчестерский.
Из всех рассмотренных нами кодов манчестерское кодирование обладает лучшей самосинхронизацией, поскольку перепад сигнала происходит минимум один раз за такт.
Манчестерский код используется в сетях Ethernet со скоростью передачи 10 Мбит/с (10Bаsе-Т). Дифференциальный манчестерский код – в сетях с технологией Token Ring.
В настоящее время разработчики пришли к выводу, что во многих случаях рациональнее применять потенциальное кодирование, ликвидируя его недостатки с помощью, так называемого логического кодирования (см. ниже в этом разделе).
Код с возвратом к нулю rz (Return to Zero)

Бит «1» — импульс одной полярности в первой половине битового интервала, во второй половине битового интервала сигнал имеет нулевой потенциал.
Бит «0» – импульс другой полярности в первой половине битового интервала, во второй половине битового интервала сигнал имеет нулевой потенциал. Код имеет хорошие синхронизирующие свойства.
Для этого кода битовый интервал  .
Код с инверсией кодовых значений cmi.
При этом методе передачи бит 1 представляется по правилам квазитроичного кодирования, а бит 0 — в виде двух импульсов противоположной полярности со сменой знака посередине. Код также обладает хорошими синхронизирующими свойствами.

Потенциальный код 2b1q
Это потенциальный код с четырьмя уровнями сигнала для кодирования данных. Название отражает суть кодирования – каждые два бита (2В) передаются за один такт сигналом определенного уровня (1Q). Линейный сигнал имеет четыре состояния. Другими словами, скорость передачи информации N при этом методе кодирования в два раза больше скорости модуляции В.

Сигнал в коде 2B1Q
На рисунке изображен сигнал, соответствующий последовательности бит: 01 01 10 00. Основная частота сигнала в коде 2B1Q не превышает значения fо=N/4 Гц.
Однако для реализации этого метода кодирования мощность передатчика должна быть выше, чтобы четыре значения потенциала четко различались приемником на фоне помех.
Код MLT3 (Multi Level Transmission — 3).
Используются три уровня передачи: «-1», «0», «+1».
Единице соответствует обязательный переход с одного уровня сигнала на другой на границе тактового интервала.
Нулю соответствует отсутствие изменения уровня линейного сигнала.
При передаче последовательности единиц период изменения уровня сигнала включает четыре бита. В этом случае fо=N/4 Гц. Это максимальная основная частота сигнала в коде MLT-3. В случае чередующейся последовательности нулей и единиц основная гармоника сигнала находится на частоте fо=N/8 Гц, что в два раза меньше чем у кода NRZI.


Сигнал в коде MLT-3
Логическое кодирование
Логическое кодирование выполняется передатчиком до физического кодирования, рассмотренного выше, средствами канального или физического уровня. На этапе логического кодирования борются с недостатками методов физического цифрового кодирования — отсутствие синхронизации, наличие постоянной составляющей. Таким образом, сначала с помощью средств логического кодирования формируются исправленные битовые последовательности, которые потом с помощью простых методов физического кодирования передаются по линиям связи.
Логическое кодирование подразумевает замену бит исходной информационной последовательности новой последовательностью бит, несущей ту же информацию, но обладающей, кроме этого, дополнительными свойствами, например возможностью для приемной стороны обнаруживать ошибки в принятых данных или надежно поддерживать синхронизацию с поступающим сигналом.
Различают два метода логического кодирования:
— кодирование избыточным кодом;
— скремблирование.
Избыточные коды (табличные коды) основаны на разбиении исходной последовательности бит на группы и последующей замене каждой исходной группы кодовым словом в соответствии с таблицей. Кодовое слово всегда содержит большее количество бит, чем исходная группа.
Логический код 4В/5В заменяет исходные группы длиной в 4 бита кодовыми словами длиной в 5 бит. В результате общее количество возможных битовых комбинаций для них (2 5 =32) больше, чем для исходных групп (2 4 =16). Поэтому в кодовую таблицу можно включить 16 таких комбинаций, которые не содержат более двух нулей подряд, и использовать их для передачи данных. Код гарантирует, что при любом сочетании кодовых слов на линии не могут встретиться более трех нулей подряд.
Остальные комбинации кода используются для передачи служебных сигналов (синхронизация передачи, начало блока данных, конец блока данных, управление передачей на канальном уровне). Неиспользуемые кодовые слова могут быть задействованы приемником для обнаружения ошибок в потоке данных. Цена за полученные достоинства при таком способе кодирования данных — снижение скорости передачи полезной информации на 25%.
Линейный код
Исходная группа
Логическое кодирование 4В/5В используется в сетях Ethernet со скоростью передачи 100МБит/с:
в сочетании с кодом NRZI (спецификация 100Base FX, среда передачи — оптоволокно);
в сочетании с кодом MLT-3 (спецификация 100Base TX, среда передачи UTP Cat 5e).
Имеются также коды и с тремя состояниями сигнала, например, в коде 8В/6Т для кодирования 8 бит исходной информации используются кодовые слова троичного кода из 6 элементов. Каждый элемент может принимать одно из трех значений (+1, 0, -1). Избыточность кода 8В/6Т выше, чем кода 4В/5В, так как на 2 8 =256 исходных символов приходится 3 6 =729 результирующих кодовых слов. Этот метод кодирования используется в спецификации 100Base T4 – при организации 100Мбит/с Ethernet по кабелю UTP Cat3 (устаревшая спецификация). Здесь для передачи битового потока одновременно используются 3 витые пары. Скорость передачи информации по каждой паре составляет N=100 Мбит/с / 3 = 33,3 Мбит/с, скорость модуляции линейного сигнала равна 25 М Бод (8:6=1,33; 33,3:1,33=25), что позволяет использовать неэкранированную витую пару UTP Cat3.
В коде 8B/10В каждые 8 бит исходной последовательности заменяются десятью битами кодового слова. При этом на 256 исходных комбинаций приходится 1024 результирующих комбинаций. При замене в соответствии с кодовой таблицей соблюдаются следующие правила:
ни одна результирующая комбинация (кодовое слово) не должна иметь более 4-х одинаковых бит подряд;
ни одна результирующая комбинация не должна содержать более 6 нулей или 6 единиц;
Код 8B/10В(+NRZI) используется в стандарте Gigabit Ethernet 1000Base-Х (когда в качестве среды передачи данных используется оптоволокно).
Осуществляют логическое кодирование сетевые адаптеры. Поскольку, использование таблицы перекодировки является очень простой операцией, метод логического кодирования избыточными кодами не усложняет функциональные требования к этому оборудованию.
Для обеспечения заданной пропускной способности N Бит/с передатчик, использующий избыточный код, должен работать с повышенной тактовой частотой. Так, для передачи сигнала в коде 4В/5В со скоростью передачи информации N=100 Мбит/с, передатчик должен работать с тактовой частотой 125 МГц (то есть B=125 МБод). При этом спектр линейного сигнала расширяется. Тем не менее, спектр сигнала избыточного потенциального кода оказывается уже спектра сигнала в манчестерском коде, что оправдывает дополнительный этап логического кодирования, а также работу приемника и передатчика на повышенной тактовой частоте.
Скремблирование представляет собой такое «перемешивание» исходной битовой последовательности, при котором вероятность появления единиц и нулей на входе модуля физического кодирования становится близкой 0,5. Устройства (или программные модули), выполняющие такую операцию, называются скремблерами (scramble — свалка, беспорядочная сборка).
Схема включения скремблера в канал связи

Скремблер в передатчике выполняет преобразование структуры исходного цифрового потока. Дескремблер в приемнике восстанавливает исходную последовательность бит. Практически единственной операцией, используемой в скремблерах и дескремблерах, является XOR — «побитное исключающее ИЛИ» (сложение по модулю 2).
Основная часть скремблера и дескремблера – это генератор псевдослучайной последовательности (ПСП) в виде К-разрядного регистра сдвига с обратными связями.
Различают 2 основных типа пар скремблеров – дескремблеров:
с начальной установкой (аддитивные).
Самосинхронизирующиеся схемы управляются скремблированной последовательностью. Эти схемы имеют недостаток – размножение ошибок. Влияние ошибочного символа проявляется столько раз, сколько обратных связей имеется в схеме.

Вариант реализации скремблирования в самосинхронизирующейся схеме.
Здесь Bi – двоичная цифра результирующего кода, полученная на i-м такте работы скремблера; Ai – двоичная цифра исходного кода, поступающая в передатчике на вход скремблера на i-м такте; Bi-5 и Bi-7 – двоичные цифры результирующего кода, полученные на предыдущих тактах работы скремблера, соответственно на «i-5» и «i-7» тактах.
Дескремблер в приемнике восстанавливает исходную последовательность, используя соотношение
В аддитивных схемах скремблированная последовательность не поступает на вход регистров сдвига, размножение ошибок отсутствует, но требуется синхронизация работы пары скремблер-дескремблер.
Манчестерский код. Часть 1. Кодирование данных.
Из названия статьи и обложки вы уже знаете, о чем сегодня пойдет речь, так что начинаем без предисловий сразу с главного. Итак, будем осуществлять генерацию манчестерского кода при помощи контроллера STM32. Разумеется, вначале разберемся, что из себя представляет данный тип кодирования в целом. Сразу могу анонсировать следующую статью, которая будет посвящена уже декодированию того сигнала, который мы сгенерируем сегодня, так что следите за обновлениями, добавляйте в закладки и подписывайтесь на всяческие наши группы )
Манчестерский код.
Манчестерское кодирование (код Манчестер-II) представляет из себя способ кодирования исходного двоичного кода двоичным же цифровым сигналом. Или в переводе — на входе единицы и нули, на выходе — единицы и нули, но порядок их следования, естественно, различается.
Существует два основных типа кодирования:
- кодирование по стандарту IEEE 802.3. В данном случае логический «0» на входе кодируется перепадом напряжения с высокого уровня ни низкий, а логическая «1» — с низкого на высокий. Это мы наглядно рассмотрим чуть ниже, так что все станет окончательно понятно.
- кодирование по Г. Е. Томасу. Здесь все наоборот: бит «0» — перепад с низкого уровня на высокий, бит «1» — с высокого на низкий.
Мы будем использовать первый из этих вариантов, но это не так важно, поскольку переход на другой тип кодирования осуществить очень просто банальным инвертированием.
К особенностям манчестерского кода я бы отнес, в первую очередь:
- какой бы длинной не была исходная последовательность битов, в закодированной последовательности будет одинаковое количество единиц и нулей, что следует из способа кодирования. И это тоже станет более прозрачно при рассмотрении примеров чуть ниже. Из этого факта следует важнейшее свойство, а именно, отсутствие постоянной составляющей сигнала. Что, в свою очередь, делает возможным использование гальванически развязанных элементов для передачи 👍
- вторым важным свойством является возможность самостоятельной синхронизации приемника. То есть приемнику не требуется ни дополнительная линия с тактовым сигналом, ни даже информация о периоде следования битов в исходной последовательности. Это мы как раз подробно рассмотрим в следующей статье, когда реализуем декодирование.
Наступило время для дважды обещанного наглядного примера. Возьмем два произвольных байта, пусть будут и закодируем их. Напоминаю, используем манчестерский код по IEEE 802.3. И еще один момент — данные в пределах байта будут следовать от младшего бита к старшему. В общем, смотрим:
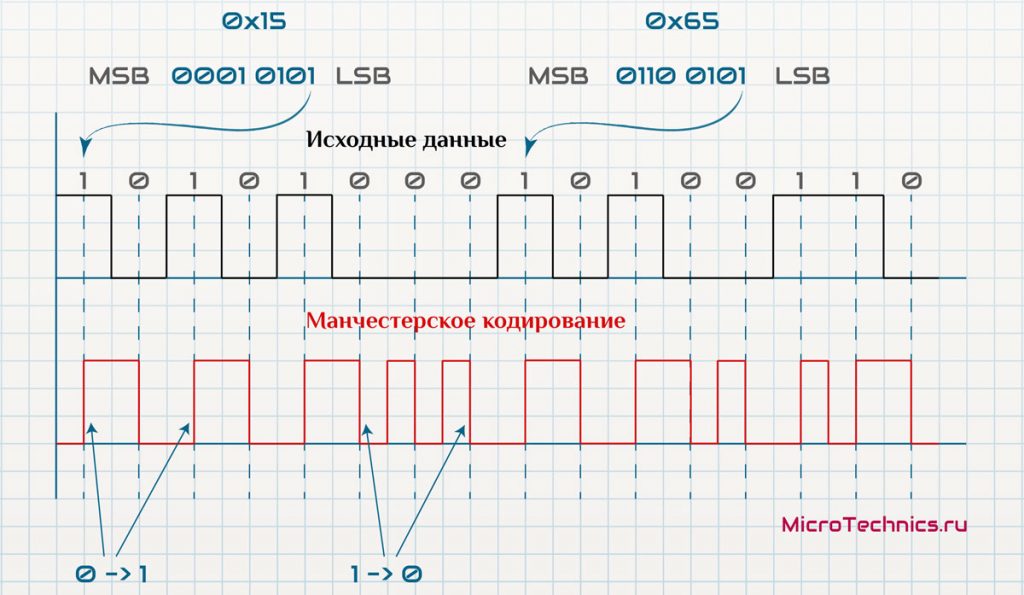
Каждому «0» на входе соответствует переход от высокого уровня к низкому на выходе (от «1» к «0»), для «1» — аналогично, но наоборот, от низкого к высокому.
На практике создать манчестерский код довольно просто. Для этого используем дополнительный виртуальный тактовый генератор. Виртуальным я его назвал по той причине, что программно этот генератор будет представлять из себя обычную переменную, значение которой будет меняться от «0» к «1» и обратно. При этом период генератора (период изменения значения переменной) должен быть в два раза меньше длительности передачи одного бита в исходной последовательности. Длительность передачи одного бита также называют периодом кодирования. Переходим к наглядности:
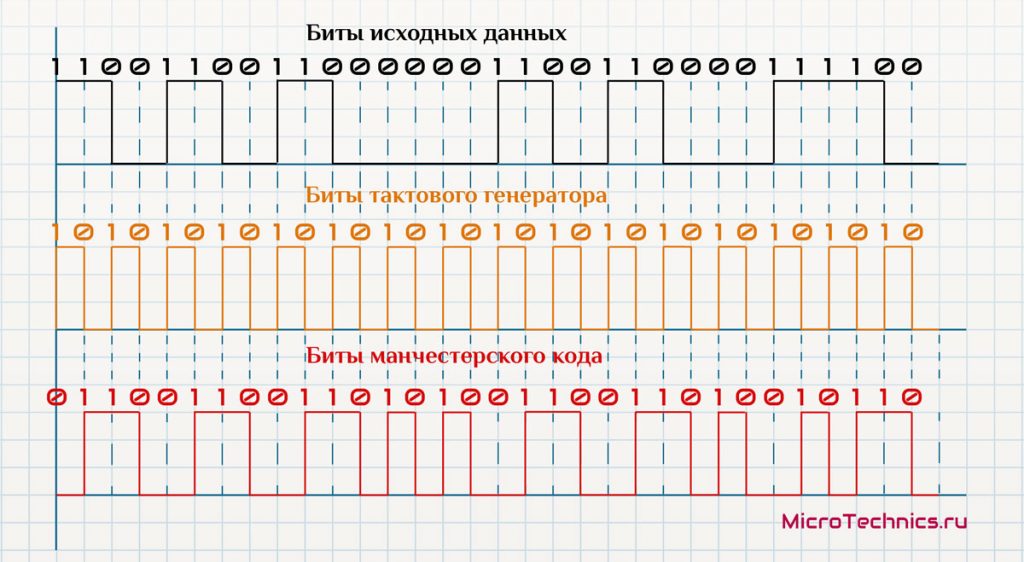
Для примера, первый бит: на входе — «1», на тактовом генераторе — «1», код Манчестер-II — «1» ^ «1» = «0».
Аналогично, для второго бита: на входе — «1», на тактовом генераторе — «0», код Манчестер-II — «1» ^ «0» = «1». Именно такой механизм будем использовать в программной реализации, к которой и переходим.
Генератор манчестерского кода на STM32.
По новой традиции в конце статьи я помещу не только ссылку на полный проект, но и полный код файлов под спойлерами. А пока настраиваем в STM32CubeMx все, что понадобится. В данном случае, это один из таймеров, который будет основой для всего, а также порт в режиме выхода, на который будем выводить манчестерский код. У меня выбор пал на TIM2 и PA3, само собой, можно использовать любые другие в точности также:
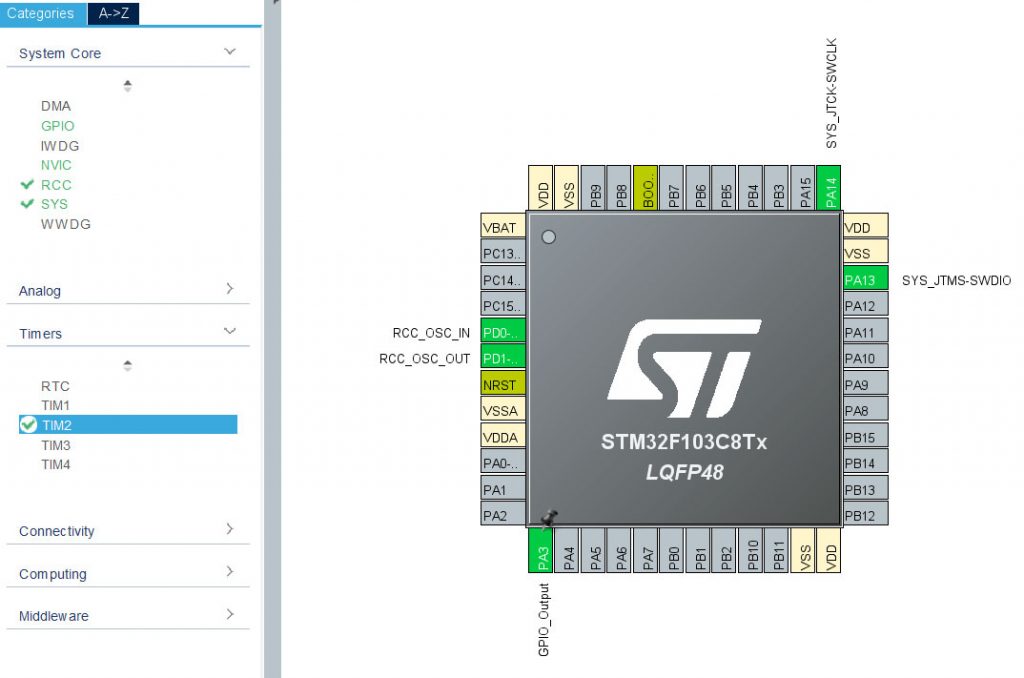
Не забываем включить интерфейс SWD для отладки и внешнее тактирование. Да, кстати, у меня будет STM32F103C8 с внешним резонатором на 8 МГц. Но, как и всегда, код будет универсальным, чтобы использовать его на любом другом контроллере без малейших проблем. Настройки тактирования традиционные:
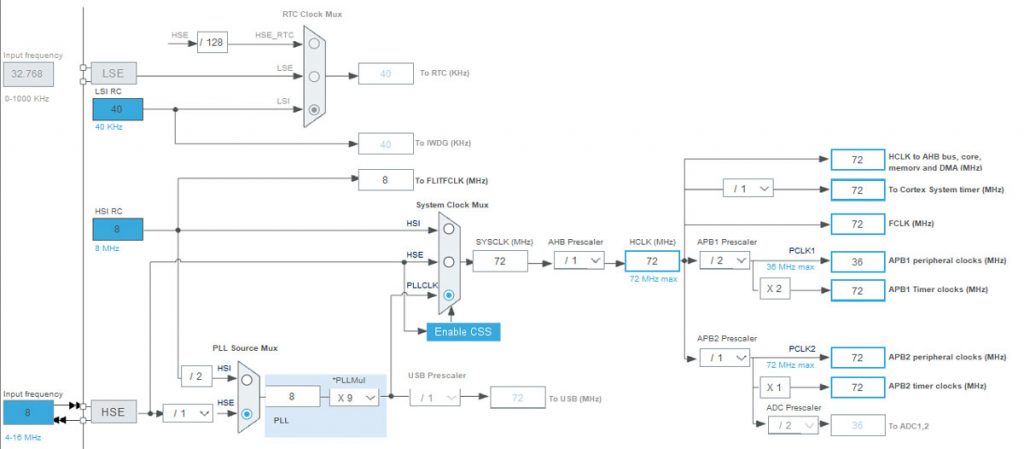
То есть тактовая частота таймеров составляет 72 МГц. Настроим TIM2 на переполнение каждые 10 мкс. Для этого берем предделитель 72 (в CubeMx ставим 71), и период, равный 10:
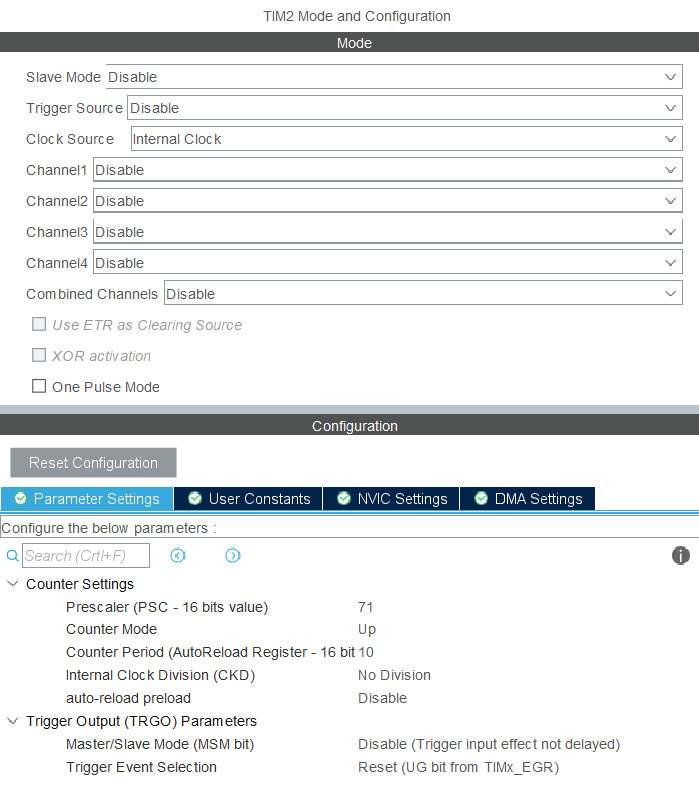
При таком делителе получим частоту таймера равной:
То есть один «тик» таймера — 1 мкс. С периодом 10 получим желаемые 10 мкс. Использование именно такого периода для таймера не критично, эта величина устанавливается в коде и может быть любой другой. Об этом чуть ниже.
Кроме того, включаем прерывание для таймера и генерируем код. Далее CubeMx нам не понадобится. Добавляем в проект файлы для работы с кодом Манчестер-II:
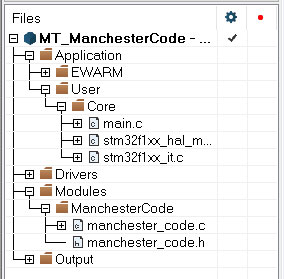
Начнем с определения констант в manchester_code.h — задаем выходной порт и как раз-таки период таймера в мкс:
Также тут присутствует третье значение — MANCH_BIT_TIME_US — это длительность передачи одного бита (период кодирования), также в микросекундах. Прерывание по таймеру будет срабатывать каждые 10 мкс, длительность бита — 100 мкс, поэтому рассчитываем сразу, сколько раз таймер должен переполниться до достижения этого значения:
Далее о формате данных. Как мы уже выяснили, приемник может сам синхронизироваться с принимаемыми битами, с этим все гладко. Но приемник никак не может знать, где именно «начало» данных:
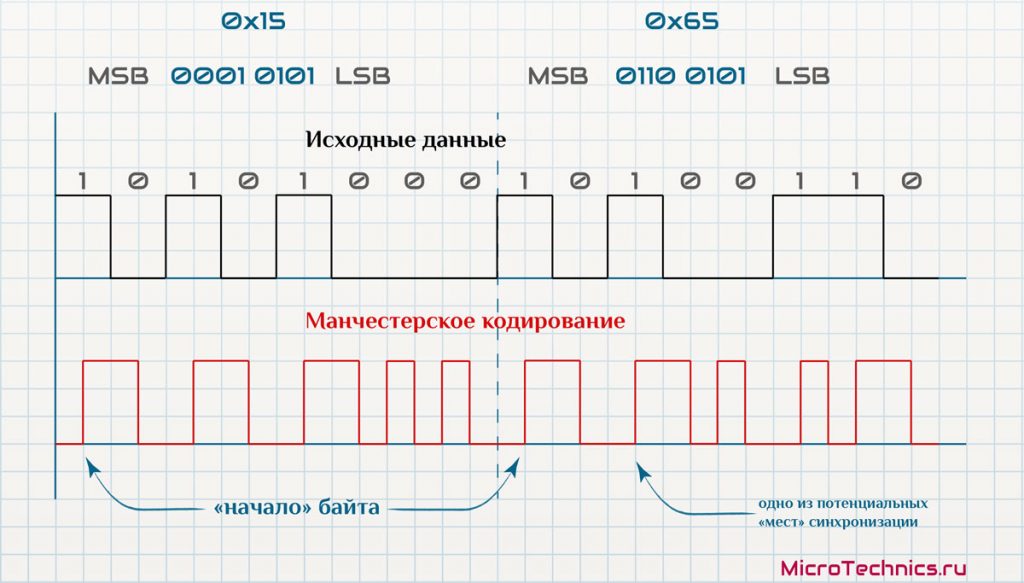
То есть, приемник самостоятельно настроился на анализ нужных фронтов (в следующей статье про декодер это и будет сделано 👍), но в этот момент он может оказаться в произвольном месте байта. А мы хотим принимать данные ровно в том порядке, в котором отправляем. Поэтому к исходным данным мы будет добавлять 16 бит со специальным кодом синхронизации. В качестве этого кода возьмем, например, значение 0xAA55:
На данный момент ограничимся тем фактом, что эти 2 байта нам нужно добавить в начало передаваемых данных, соответственно также закодировав их.
Для структуризации данных добавляем:
Пробегаем по полям:
- data[MANCH_BYTES_NUM] — массив для хранения передаваемых данных. После перечня полей структуры разберемся с размером этого массива
- bitStream — это поле нужно для декодера, пока о нем умалчиваю
- byteIdx — индекс текущего кодируемого байта из массива data[]
- bytesNum — суммарное количество байт, которые нужно закодировать и выдать на выход
- bitIdx — индекс текущего бита в текущем байте data[byteIdx]
- active — флаг активности, «1» — процесс генерации активен, «0» — процесс остановлен.
По поводу размера массива — он задается все здесь же в manchester_code.h, пока мы вообще за пределы этого файла даже не выходили:
- MANCH_BYTES_NUM — максимальное количество передаваемых байт
- MANCH_SYNC_BYTES_NUM — размер синхрополя
- MANCH_DATA_BYTES_NUM — рассчитанное максимальное количество информационных байт, равное 8 в данном случае. 8 я выбрал исключительно для примера и из симпатии к цифре, можно увеличивать до больших значений.
Пойдем поэтапно, manchester_code.c — объявление переменных:
- virtTact — та самая переменная, которая будет играть роль виртуального тактового генератора при генерации манчестерского кода
- encodeData — экземпляр нашей структуры — сердце и центр всего процесса
- encodeTimerCnt — счетчик, его значение будем инкрементировать в прерывании по переполнению таймера
- htim2 — просто перетягиваем из main.c для использования в этом файле
Сейчас пойдет ряд функций для организации кодирования. Для управления выходом добавляем:
Далее по списку и по важности — функция, которая запускает процесс манчестерского кодирования:
В качестве аргументов — указатель на информационные данные и их размер (кол-во байт). Соответственно, передавать в функцию мы будем набор uint8_t значений, которые затем побитно будут кодироваться и выдаваться на PA3. На всякий случай напоминаю, что кодировать данные будем от младшего бита к старшему. То есть если на входе байт 0x22, что в двоичном виде представляет из себя 0b00100010, то на выходе будут последовательно закодированные «0», «1», «0», «0», «0», «1», «0», «0».
Итак, в функции обнуляем счетчики текущего байта и бита, а также проверяем размер данных на превышение максимально возможного количества информационных байт. В случае превышения сохраняем в bytesNum максимально допустимое значение. Далее копируем информационные данные в структуру, но начиная со 2-го байта (индекс = MANCH_SYNC_BYTES_NUM ):
Делаем так по той причине, что первые два передаваемых байта будут синхрополем, которое и помещаем в массив encodeData.data[] .
Следующая функция возвращает текущее значение бита на основе данных структуры MANCH_Data :
В manchData->data[] у нас данные, в manchData->byteIdx — номер байта, в manchData->bitIdx — номер бита. В результате функция возвращает значение этого бита в этом байте в этих данных.
Все, наконец, переходим к прерыванию таймера, в котором соберем воедино все, что было подробно разобрано:
Все действия осуществляем при активном флаге:
Разберемся, что мы имеем в итоге с временными интервалами при текущей конфигурации.
В функцию HAL_TIM_PeriodElapsedCallback() мы попадаем каждые 10 мкс. При этом период кодирования равен 100 мкс. Каждый раз заходя в callback инкрементируем счетчик encodeTimerCnt , что приведет к тому, что через 100 мкс его значение будет равно рассчитанному ранее значению MANCH_ENCODE_TIMER_MAX . Далее отсчитывать не требуется, поэтому обнуляем счетчик в этой части функции:
Кроме того, поскольку прошло 100 мкс, что есть длительность передачи одного бита, то переходим к следующему биту, инкрементируя encodeData.bitIdx . Оставшееся просто — проверяем, не вышел ли индекс бита за пределы байта, и в случае выхода, переходим на следующий байт. А если счетчик байт равен кол-ву передаваемых байт ( encodeData.bytesNum ), то все, финиш, процесс завершается.
Осталась маленькая, но самая важная часть, которая осуществляет генерацию манчестерского кода:
Помните, мы обсуждали, что период виртуального тактового генератора должен быть вдвое меньше длительности бита? Так вот поэтому здесь мы проверяем счетчик на равенство двум значениям, так как этот кусок кода должен выполниться дважды за время, равное длительности передачи бита. И в этом куске получаем значение текущего исходного бита и рассчитываем значение, которое необходимо выдать на выход все по той же формуле:
И в завершение меняем значение virtTact с 0 на 1, либо с 1 на 0.
Дело за малым — запускаем процесс генерации Манчестер-II кода из main() и анализируем результат. Для этого запускаем таймер HAL_TIM_Base_Start_IT(&htim2) и в while(1) будем запускать генерацию каждые 500 мс:
Также здесь фигурирует txData — обычный массив тестовых данных, объявленный здесь же, в main.c:
Последний байт инкрементируем в цикле, чтобы при декодировании убедиться, что не теряем посылки. Компилируем, прошиваем, запускаем, встаем осциллографом на PA3:
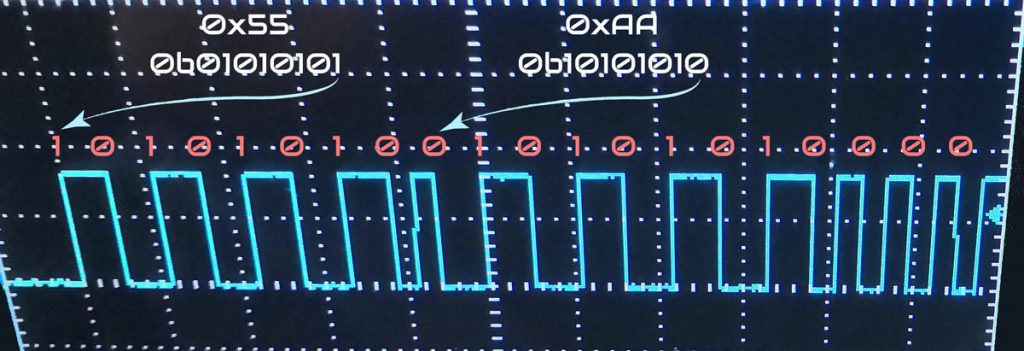
Переводим мысленно несколько байт наблюдаемого сигнала из манчестерского кода и получаем полное соответствие исходным данным (плюс синхрополе), что явно сигнализирует об успехе операции кодирования.
Засим откланиваюсь, в следующей статье этот же самый сигнал мы декодируем, причем этим же самым контроллером.
Манчестерский код — Manchester code
В телекоммуникациях и хранилище данных, Манчестерский код (также известный как фазовое кодирование или PE ) — это линейный код, в котором кодирование каждых данных бит либо младшее, затем высокое, либо высокое, затем низкое, в течение одинакового времени. Это сигнал самосинхронизации без составляющей постоянного тока. Следовательно, электрические соединения с использованием кода Манчестера легко гальванически изолированы..
Код Манчестера получил свое название от его разработки в Университете Манчестера, где кодирование использовалось для хранения данных на магнитных барабанах. компьютера Manchester Mark 1.
Манчестерский код широко использовался для магнитной записи на компьютерных лентах 1600 bpi до появления лент 6250 bpi, которые использовали более эффективную запись с групповым кодированием. Манчестерский код использовался в ранних стандартах физического уровня Ethernet и до сих пор используется в потребительских протоколах IR, RFID и связи ближнего поля.
Содержание
- 1 Характеристики
- 2 Кодирование и декодирование
- 2.1 Условные обозначения для представления данных
- 2.2 Декодирование
- 2.3 Кодирование
Характеристики
Манчестерское кодирование — это особый случай двоичной фазовой манипуляции (BPSK), где данные управляют фазой прямоугольной волны несущей, частота которой равна скорость передачи данных. Манчестерский код обеспечивает частые скачки напряжения в сети, прямо пропорциональные тактовой частоте; это помогает восстановлению тактовой частоты.
. Компонент постоянного тока кодированного сигнала не зависит от данных и, следовательно, не несет информации. Следовательно, соединения могут быть индуктивно или емкостными связанными, что позволяет удобно передавать сигнал через гальванически изолированную среду (например, Ethernet) с использованием изолятора сети — простой взаимно однозначный изолирующий трансформатор, который не может передавать составляющую постоянного тока.
Согласно Cisco, «Манчестерское кодирование вызывает некоторые сложные проблемы, связанные с частотой, которые делают его непригодным для использования при более высоких скоростях передачи данных».
Существуют более сложные коды, такие как 8B / 10B кодирование, которые используют меньшую полосу пропускания для достижения той же скорости передачи данных, но могут быть менее терпимы к ошибкам частоты и джиттеру в передатчике и приемнике эталонные часы.
Кодирование и декодирование
Пример манчестерского кодирования, показывающий оба соглашения для представления данных
Манчестерский код всегда имеет переход в середине каждого битового периода и может (в зависимости от относительно передаваемой информации) также имеют переход в начале периода. Направление перехода среднего бита указывает данные. Переходы на границах периодов не несут информации. Они существуют только для того, чтобы перевести сигнал в правильное состояние, чтобы разрешить переход среднего бита.
Соглашения для представления данных
Есть два противоположных соглашения для представления данных.
Первый из них был впервые опубликован Г. Э. Томасом в 1949 году, за ним следуют многочисленные авторы (например, Энди Таненбаум ). Он определяет, что для бита 0 уровни сигнала будут низко-высокими (при условии физического кодирования данных по амплитуде) — с низким уровнем в первой половине битового периода и высоким уровнем во второй половине. Для 1 бита уровни сигнала будут высокими-низкими. Это также известно как код Manchester II или Biphase-L.
Второму соглашению также следуют многочисленные авторы (например, Уильям Столлингс ), а также IEEE 802.4 (шина токена) и более низкоскоростные версии Стандарты IEEE 802.3 (Ethernet). В нем указано, что логический 0 представлен сигнальной последовательностью высокий-низкий, а логическая 1 представлена сигнальной последовательностью низкий-высокий.
Если сигнал, закодированный в манчестерском коде, инвертируется при обмене данными, он преобразуется из одного соглашения в другое. Эту неоднозначность можно преодолеть, используя дифференциальное манчестерское кодирование.
Декодирование
Наличие гарантированных переходов позволяет сигналу быть самосинхронизирующимся, а также позволяет приемнику правильно выравниваться; приемник может идентифицировать, если он не выровнен на половину периода битов, поскольку больше не всегда будет переход во время каждого периода битов. Цена этих преимуществ — удвоение требований к полосе пропускания по сравнению с более простыми схемами кодирования NRZ.
Кодирование
Кодирование данных с использованием исключительной или логики (соглашение 802.3)
Исходные данные Часы Манчестерское значение 0 XOR. ⊕ 0 = 0 1 1 1 0 1 1 0 Соглашения о кодировании следующим образом:
- Каждый бит передается в фиксированное время («период»).
- A 0 выражается переходом от низкого к высокому, a 1 переходом от высокого к низкому (согласно соглашению GE Thomas — в соглашении IEEE 802.3 верно обратное).
- Переходы, которые означают 0 или 1 , происходят в середине период.
- Переходы в начале периода являются служебными и не означают данных.
См. также
Ссылки
В эту статью включены материалы общественного достояния из документа Управления общих служб : «Федеральный стандарт 1037C».(в поддержку MIL-STD-188 )