Почему стоит научиться «парсить» сайты, или как написать свой первый парсер на Python
Для начала давайте разберемся, что же действительно означает на первый взгляд непонятное слово — парсинг. Прежде всего это процесс сбора данных с последующей их обработкой и анализом. К этому способу прибегают, когда предстоит обработать большой массив информации, с которым сложно справиться вручную. Понятно, что программу, которая занимается парсингом, называют — парсер. С этим вроде бы разобрались.
Перейдем к этапам парсинга.
- Поиск данных
- Извлечение информации
- Сохранение данных
И так, рассмотрим первый этап парсинга — Поиск данных.
Так как нужно парсить что-то полезное и интересное давайте попробуем спарсить информацию с сайта work.ua.
Для начала работы, установим 3 библиотеки Python.
pip install beautifulsoup4
Без цифры 4 вы ставите старый BS3, который работает только под Python(2.х).
pip install requests
pip install pandas
Теперь с помощью этих трех библиотек Python, можно проанализировать нашу веб-страницу.
Второй этап парсинга — Извлечение информации.
Попробуем получить структуру html-кода нашего сайта.
Давайте подключим наши новые библиотеки.
И сделаем наш первый get-запрос.
Статус 200 состояния HTTP — означает, что мы получили положительный ответ от сервера. Прекрасно, теперь получим код странички.
Получилось очень много, правда? Давайте попробуем получить названия вакансий на этой страничке. Для этого посмотрим в каком элементе html-кода хранится эта информация.
У нас есть тег h2 с классом «add-bottom-sm», внутри которого содержится тег a. Отлично, теперь получим title элемента a.
Хорошо, мы получили названия вакансий. Давайте спарсим теперь каждую ссылку на вакансию и ее описание. Описание находится в теге p с классом overflow. Ссылка находится все в том же элементе a.
Получаем такой код.
И последний этап парсинга — Сохранение данных.
Давайте соберем всю полученную информацию по страничке и запишем в удобный формат — csv.
Руководство по вэб-скрепингу на Python: приёмы и хитрости
Как-то я хотела купить авиабилеты и заметила, что цены изменяются несколько в течение дня. Я попыталась выяснить, когда наступает самый лучший момент для покупки билетов, но не нашла в Интернете ничего, что бы могло мне помочь решить эту задачу. Тогда я написала небольшую программу для автоматического сбора данных в Интернете — так называемую программу скрепинга. Программа извлекла информацию по моему запросу для определенного пункта назначения на выбранные мной даты и показала мне, когда стоимость становится минимальной.
Веб-скрепинг — это метод автоматизированного извлечения данных с веб-сайтов.
Я имею большой опыт веб-скрепинга и хочу с вами поделиться.
Этот пост предназначен для тех, кому интересно узнать об общих шаблонах проектирования, подвохах и правилах, связанных с веб-скрепингом. В статье представлено несколько реальных примеров и перечень типовых задач, таких как, например, что делать, чтобы вас не обнаружили, что можно делать, а что не следует и, наконец, как ускорить работу вашего скрепера с помощью распараллеливания.
Все примеры будут сопровождаться фрагментами кода на Python, так что вы можете сразу же ими воспользоваться. В этом материале также будет показано, как привлекать к работе полезные пакеты Python.
Реальные примеры
Существует различные причины и варианты необходимости использования сбора (скрэпинга) данных в Интернете. Позвольте мне перечислить некоторые из них:
-
, чтобы определить имеется ли в наличии одежда, которую вы хотите купить, со скидкой нескольких брендов одежды, собирая данные о них с вэб-страниц
- стоимость авиабилетов может меняться несколько раз в течение дня. Можно сканировать веб-сайт и дождаться момента, когда цена будет снижена
- проанализировать веб-сайты, чтобы определить, должна ли быть стартовая стоимость продажи низкой или высокой, чтобы привлечь больше участников на аукцион или коррелирует ли длительность проведения аукциона с более высокой ценой конечной ценой продажи
Руководство
- Применяемые пакеты
- Основной программный код
- Распространенные ошибки
- Общие правила
- Ускорение ‑ распараллеливание
Прежде чем мы приступим: БУДЬТЕ аккуратны с серверами; вы же НЕ ХОТИТЕ сломать вэб-сайт.
1. Известные пакеты и инструменты
Для веб-скрэпинга нет универсального решения, поскольку способ, с помощью которого хранится на каждом из веб-сайтов обычно специфичны. На самом деле, если вы хотите собрать данные с сайта, вам необходимо понять структуру сайта и, либо создать собственное решение, либо воспользоваться гибким и перенастраиваемым вариантом уже готового решения.
Изобретать колесо здесь не нужно: существует множество пакетов, которые скорее всего, вам вполне подойдут. В зависимости от ваших навыков программирования и предполагаемого варианта использования вы можете найти разные более или менее полезные для себя пакеты.
1.1 Проверяем параметры
Чтобы вам было проще проверять HTML-сайт, воспользуйтесь опцией инспектора в вашем вэб-браузере.
Раздел веб-сайта, который содержит мое имя, мой аватар и мое описание, называется hero hero—profile u-flexTOP (любопытно, что Medium называет своих писателей героями:)). Класс <h1>, который содержит мое имя, называется ui-h2 hero-title , а описание содержится в описании героя <p> классом ui-body hero-description .
Вы можете более подробно познакомиться с HTML-тэгами и различиями между классами и id здесь.
1.2 Скрэпинг
Существует отдельная готовая к использованию библиотека для извлечения данных под названием Scrapy. Кроме извлечения HTML, этот пакет располагает большим количеством функций, таких как экспорт данных в различные форматы, создание лог-файлов и т.д. Это достаточно гибкий и настраиваемый вариант: запуск отдельных скрэперов на разных процессах , отключение cookies (некоторые сайты используют cookies для идентификации ботов) и установка задержек загрузки (веб-сайт может быть перегружен из-за огромного количества запросов на сканирование). Его также можно использовать для извлечения данных с помощью API. Однако для начинающих программистов пакет, скорее всего, будет несколько сложноват: вам придется прочитать руководства и разобраться с примерами, прежде чем вы сможете приступить к работе.
В моем случае я воспользовалась готовым методом «из коробки»: я просто хотела извлечь ссылки со всех страниц, получить доступ по каждой ссылке и извлечь из нее информацию.
1.3 BeautifulSoup с библиотекой Request
BeautifulSoup — это библиотека, позволяющая сделать синтаксический разбор (парсинг) HTML-кода. Кроме того, вам также потребуется библиотека Request , которая будет отображать содержимое URL-адреса. Однако, вы также должны позаботиться и о решении ряда прочих вопросов, таких как обработка ошибок, экспорт данных, распараллеливание и т.д.
Я выбрала BeautifulSoup, поскольку эта библиотека помогла мне понять сколько всего Scrapy может делать самостоятельно и, я надеюсь, помогла мне быстрее научиться на своих собственных ошибках.
2. Основной программный код
Начать скэпить вэб-сайт очень просто. В большинстве случаев просматриваете HTML-сайт, вы обнаружите те классы и идентификаторы, которые могут вам могут понадобиться. Допустим, у нас есть следующая структура html, и мы хотим извлечь элементы main_price .
Примечание: элемент discounted_price является необязательным.
Основной код вэб-скрепера должен импортировать библиотеки, выполнить запрос, проанализировать html и затем найти класс class main_price .
Может случиться так, что класс main_price находится в другом разделе веб-сайта. Чтобы избежать извлечения ненужного класса main_price из какой-либо другой части веб-страницы, мы могли бы сначала обратиться к id listings_prices и только затем найти все элементы с классом main_price .
3. Распространенные ошибки
3.1 Check robots.txt
Правила скрэпинга веб-сайтов можно найти в файле robots.txt. Вы можете найти его, написав слова «robots.txt» после имени домена, например так: www.website_to_scrape.com/robots.txt . Эти правила определяют, какие части веб-сайтов не могут быть автоматически извлечены или как часто боту разрешено запрашивать данные со страницы. Большинство не заботятся об этих правилах, но все же постарайтесь хотя бы почитать их, даже если вы и не планируете следовать им.
3.2 HTML может быть злом
HTML-теги могут содержать идентификатор (id), класс или сразу оба этих элемента. Идентификатор (т.е. id) HTML описывает уникальный идентификатор, а класс HTML не является уникальным. Изменения в имени или элементе класса могут либо сломать ваш код, либо выдать вам неправильные результаты.
Есть два способа избежать, или, по крайней мере, предупредить это:
• Используйте конкретный идентификатор id , а не class , поскольку он с меньшей вероятностью будет изменен
- Проверьте, не возвращается ли элемент значение None.
Однако, поскольку некоторые поля могут быть необязательными (например, discounted_price в нашем HTML-примере), соответствующие элементы не будут отображаться в каждом списке. В этом случае вы можете подсчитать процентное соотношение частоты возврата None конкретным элементом в списке. Если это 100%, вы, возможно, захотите проверить, было ли изменено имя элемента.
3.3 Обмануть программу-агент
Каждый раз, когда вы посещаете веб-сайт, он получает информацию о вашем браузере через пользовательский агент. Некоторые веб-сайты не будут показывать вам какой-либо контент, если вы не предоставите им пользовательский агент. Кроме того, некоторые сайты предлагают разные материалы для разных браузеров. Веб-сайты не хотят блокировать разрешенных пользователей, но вы будете выглядеть подозрительно, если вы отправите 200 одинаковых запросов в секунду с помощью одного и того же пользовательского агента. Выход из этой ситуации может заключаться в том, чтобы сгенерировать (почти) случайного пользовательского агента или задать его самостоятельно.
3.4 Время ожидания запроса
По умолчанию Request будет продолжать ожидать ответ в течение неопределенного срока. Поэтому рекомендуется установить параметр таймаута.
3.5 Я заблокирован?
Частое появление кодов состояния, таких как 404 (не найдено), 403 (Запрещено), 408 (Тайм-аут запроса), может указывать на то, что вы заблокированы. Вы можете проверить эти коды ошибок и действовать соответственно.
Кроме того, будьте готовы обработать исключения из запроса.
3.6 Смена IP
Даже если вы рандомизировали своего пользовательского агента, все ваши запросы будут отправлены с одного и того же IP-адреса. Это вполне нормально, поскольку библиотеки, университеты, а также компании имеют всего несколько IP-адресов. Однако, если очень много запросов поступает с одного IP-адреса, сервер может это обнаружить.
Использование общих прокси, VPN или TOR может помочь вам стать незаметным;)
Если вы используете общий прокси-сервер, веб-сайт увидит IP-адрес прокси-сервера, а не ваш. VPN соединяет вас с другой сетью, а IP-адрес поставщика VPN будет отправлен на веб-сайт.
3.7 Ловушки для хакеров
Ловушки для хакеров — это средства для обнаружения сканеров или скреперов.
Такими средствами могут быть «скрытые» ссылки, которые не видны пользователям, но могут быть извлечены скреперами и/или вэб-спайдерами. Такие ссылки будут иметь набор стилей CSS display:none , их можно смешивать, задачая цвет фона или даже перемещаясь из видимой области страницы. Как только ваша программа посещает такую ссылку, ваш IP-адрес может быть помечен для дальнейшего расследования или даже мгновенно заблокирован.
Другой способ обнаружить хакеров — это добавить ссылки с бесконечно глубокими деревьями директорий. В этом случае вам нужно ограничить количество загруженных страниц или ограничить глубину обхода.
4. Общие правила
- Перед началом скрэпинга проверьте, есть ли у вас возможность воспользоваться публичными API. Публичные API предоставляют более простой и быстрый (и законный) поиск данных, по сравнению с веб-скрэпингом. Посмотрите API Twitter, который предоставляет API для различных целей.
- Если вы скрэпите много данных, вы можете воспользоваться базой данных, чтобы иметь возможность быстро анализировать получать данные с Интернета. В этом руководстве описано, как создать локальную базу данных с помощью Python.
- Будьте вежливы, терпеливы и уважительны. Как следует из этого ответа, рекомендуется оповещать пользователей о том, что вы собираете данные с их веб-сайта, чтобы они могли лучше отреагировать на возможные проблемы, причиной которых может стать ваш бот.
Опять таки, не перегружайте веб-сайт, отправляя сотни запросов в секунду.
5. Ускорение ‑ распараллеливание
Если вы решитесь на распараллеливание своей программы, будьте осторожны с реализацией, чтобы не “свалить” сервер. Обязательно прочитайте раздел «Распространенные ошибки», приведенный выше. Ознакомьтесь с определениями параллельного и последовательного выполнения, процессоров и потоков здесь и здесь.
Если вы извлекаете большое количество информации со страницы и выполняете некоторую предварительную обработку данных, количество повторных запросов в секунду, которое вы отправляете на страницу, может быть относительно низким.
В своем другом проекте я собирала цены на аренду квартиры и сделала для этого довольно сложную предварительную обработку данных, в результате чего мне удалось отправлять только один запрос в секунду. Чтобы собрать объявления размером в 4K, моя программа должна проработать около часа.
Чтобы отправлять запросы параллельно, вы можете воспользоваться пакетом multiprocessing.
Допустим, у нас есть 100 страниц, и мы хотим назначить каждому процессу равное количество страниц для обработки. Если n — количество процессоров, то вы можете равномерно распределить все страницы на n частей и назначить каждую часть отдельному процессору. Каждый процесс будет иметь свое имя, свою целевую функцию и свои аргументы для работы. После этого имя процесса можно использовать для включения записи данных в определенный файл.
Я назначила 1K страниц для каждого из 4-х процессоров, имевшихся у меня в распоряжении, в результате было создано 4 повторных запроса в секунду, что сократило время сбора данных моей программой до 17 минут.
Parsing HTML Tables in Python with BeautifulSoup and pandas
Something that seems daunting at first when switching from R to Python is replacing all the ready-made functions R has. For example, R has a nice CSV reader out of the box. Python users will eventually find pandas, but what about other R libraries like their HTML Table Reader from the xml package? That’s very helpful for scraping web pages, but in Python it might take a little more work. So in this post, we’re going to write a brief but robust HTML table parser.
Writing a Table Scraper
Our parser is going to be built on top of the Python package BeautifulSoup. It’s a convenient package and easy to use. Our use will focus on the “find_all” function, but before we start parsing, you need to understand the basics of HTML terminology.
An HTML object consists of a few fundamental pieces: a tag. The format that defines a tag is
and it could have attributes which consistes of a property and a value. A tag we are interested in is the table tag, which defined a table in a website. This table tag has many elements. An element is a component of the page which typically contains content. For a table in HTML, they consist of rows designated by elements within the tr tags, and then column content inside the td tags. A typical example is
It turns out that most sites keep data you’d like to scrape in tables, and so we’re going to learn to parse them.
Parsing a Table in BeautifulSoup
To parse the table, we are going to use the Python library BeautifulSoup. It constructs a tree from the HTML and gives you an API to access different elements of the webpage.
Let’s say we already have our table object returned from BeautifulSoup. To parse the table, we’d like to grab a row, take the data from its columns, and then move on to the next row ad nauseam. In the next bit of code, we define a website that is simply the HTML for a table. We load it into BeautifulSoup and parse it, returning a pandas data frame of the contents.
| 0 | 1 | |
|---|---|---|
| 0 | Hello! | Table |
As you can see, we grab all the tr elements from the table, followed by grabbing the td elements one at a time. We use the “get_text()” method from the td element (called a column in each iteration) and put it into our python object representing a table (it will eventually be a pandas dataframe).
Using Requests to Access a Web Content
Now, that we have our plan to parse a table, we probably need to figure out how to get to that point. That’s actually easier! We’re going to use the requests package in Python.
The Parser Object
So, now we can define our HTML table parser object. You’ll notice we added more bells and whistles to the html table parser. To summarize the functionality outside of basic parsing:
The tuples we return are in the form (table id, parsed table) for every table in the document.
Usage Example
Let’s do an example where we scrape a table from a website. We initialize the parser object and grab the table using our code above:
| Rank | Player | Team | Points | Games | Avg | |
|---|---|---|---|---|---|---|
| 0 | 1 | Cam Newton | CAR | 389.1 | 16 | 24.3 |
| 1 | 2 | Tom Brady | NE | 343.7 | 16 | 21.5 |
| 2 | 3 | Russell Wilson | SEA | 336.4 | 16 | 21.0 |
| 3 | 4 | Blake Bortles | JAC | 316.1 | 16 | 19.8 |
| 4 | 5 | Carson Palmer | ARI | 309.2 | 16 | 19.3 |
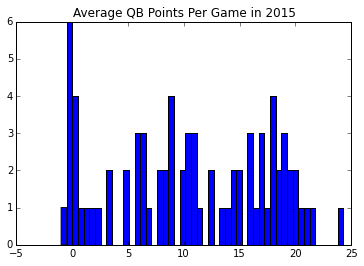
If you had looked at the URL above, you’d have seen that we were parsing QB stats from the 2015 season off of FantasyPros.com. Our data has been prepared in such a way that we can immediately start an analysis.
Final Thoughts
As you can see, this code may find it’s way into some scraper scripts once Football season starts again, but it’s perfectly capable of scraping any page with an HTML table. The code actually will scrape every table on a page, and you can just select the one you want from the resulting list. Happy scraping!
Web Parsing. Основы на Python
Рассмотрим еще один практический кейс парсинга сайтов с помощью библиотеки BeautifulSoup: что делать, если на сайте нет готовой выгрузки с данными и нет API для удобной работы, а страниц для ручного копирования очень много?
Недавно мне понадобилось получить данные с одного сайта. Готовой выгрузки с информацией на сайте нет. Данные я вижу, вот они передо мной, но не могу их выгрузить и обработать. Возник вопрос: как их получить? Немного «погуглив», я понял, что придется засучить рукава и самостоятельно парсить страницу (HTML). Какой тогда инструмент выбрать? На каком языке писать, чтобы с ним не возникло проблем? Языков программирования для данной задачи большой набор, выбор пал на Python за его большое разнообразие готовых библиотек.
Примером для разбора основ возьмем сайт с отзывами banki_ru и получим отзывы по какому-нибудь банку.
Задачу можно разбить на три этапа:
- Загружаем страницу в память компьютера или в текстовый файл.
- Разбираем содержимое (HTML), получаем необходимые данные (сущности).
- Сохраняем в необходимый формат, например, Excel.
Инструменты
Для начала нам необходимо отправлять HTTP-запросы на выбранный сайт. У Python для отправки запросов библиотек большое количество, но самые распространённые urllib/urllib2 и Requests. На мой взгляд, Requests — удобнее, примеры буду показывать на ней.
А теперь сам процесс. Были мысли пойти по тяжелому пути и анализировать страницу на предмет объектов, содержащих нужную информацию, проводить ручной поиск и разбирать каждый объект по частям для получения необходимого результата. Но немного походив по просторам интернета, я получил ответ: BeautifulSoup – одна из наиболее популярных библиотек для парсинга. Библиотеки найдены, приступаем к самому интересному: к получению данных.
Загрузка и обработка данных
Попробуем отправить запрос HTTP на сайт, чтобы получить первую страницу с отзывами по какому-нибудь банку и сохранить в файл, для того, чтобы убедиться, получаем ли мы нужную нам информацию.
После исполнения данного скрипта получится файл text.html.
Открываем данный файл и видим, что необходимые данные получили без проблем.
Теперь очередь для разбора страницы на нужные фрагменты. Обрабатывать будем последние 10 страниц плюс добавим модуль Pandas для сохранения результата в Excel.
Подгружаем необходимые библиотеки и задаем первоначальные настройки.
На данном этапе необходимо понять, где находятся необходимые фрагменты. Изучаем разметку страницы с отзывами и определяем, какие объекты будем вытаскивать из страницы.
Подробно покопавшись во внутренностях страницы, мы увидим, что необходимые данные «вопросы-ответы» находятся в блоках <table class:qaBlock >, соответственно, сколько этих блоков на странице, столько и вопросов.
Приступая к получению самих данных, я кратко расскажу о двух функциях, которые будут использованы:
- Find(‘table’) – проводит поиск по странице и возвращает первый найденный объект типа ‘table’. Вы можете искать и ссылки find(‘table’) и рисунки find(‘img’). В общем, все элементы, которые изображены на странице;
- find_all(‘table’) – проводит поиск по странице и возвращает все найденные объекты в виде списка
У каждой из этих функций есть методы. Я расскажу от тех, которые использовал:
- find(‘table’).text – этот метод вернет текст, находящийся в объекте;
- find(‘a’).get(‘href’) – этот метод вернет значение ссылки
Теперь, уже обладая этими знаниями и навыками программирования на Python, написал функцию, которая разбирает таблицу с отзывом на нужные данные. Каждые стадии кода дополнил комментариями.
Функция возвращает DataFrame, который можно накапливать и экспортировать в EXCEL.
В результате мы научились парсить web-сайты, познакомились с библиотеками Requests, BeautifulSoup, а также получили пригодные для дальнейшего анализа данные об отзывах с сайта banki.ru. А вот и сама результирующая таблица.
Приобретенные навыки можно использовать для получения данных с других сайтов и получать обобщенную и структурированную информацию с бескрайних просторов Интернета.
Я надеюсь, моя статья была полезна. Спасибо за внимание.
Парсер можно писать на чем угодно. Да и библиотеки не всегда нужны, использовал раньше только ssl для https. В некоторых случаях проще писать свой код. Единственное, что хорошо бы иметь — параллельные потоки и прокси. Писал давно универсальный парсер, столкнулся с неприятным моментом ошибок в коде доноров, отсутствии закрывающих тегов или генерации страниц скриптами. Решил гибкой системой настроек паттернов, в приложении добавил редактор данных в таблице, куда заносятся паттерны для поочередной обработки данных. Для увеличения скорости добавил стоп-паттерн (та уникальная часть кода страницы, после которой нет нужных данных), после которого не нужно ждать окончания загрузки, а можно сразу работать с кодом страницы. И для ускорения именно разбора добавил старт-позицию до которой не нужно анализировать данные. Ну ещё счетчик страниц, автосохранение данных и настроек и т.п.
Мои приветствия. А как изменится код, если необходимо пройти по куче однотипных ссылок вида http://ololo.ru/forum/forum_id, где forum_id — цифры по нарастающей и выдрать какую-то информацию?
Т.е. тут добавляется цикл хождения по ссылкам for forum_id in ()
И где-то здесь конкретно у меня появляется проблема, что в результат либо пишется информация по последней пройденной ссылке, либо выдается информация по всем ссылкам, но с дублированием заголовков, т.е. что-то такое:
заголовок1 заголовок2
0 инф1 инф2
заголовок1 заголовок2
0 инф1 инф2
Как сделать вывод одной нормальной таблицей? Целый, видимо, квест =(
Добрый день.
Необходимо понимать структуру формирования ссылки по которой формируется необходимая страница.
На некоторый сайтах добавляется такой параметр как offset(на разных сайтах может писаться по разному, но смысл должен быть один), т.е. сколько необходимо пропустить страниц или записей. Поперемещайтесь по страницам и посмотрите какой параметр меняется еще.
Очень круто написано. Понятно и доступно. Спасибо огромное.
Не сможет ли кто-то подсказать, как исправить такую ошибку ?
File "I:/PYTHON/Обучение/Study/. /Parsing_01.py", line 43, in parse_table
IndexError: list index out of range
Возникает, когда место проживания пишут типа (Балашиха (Московская область)), то есть две пары скобок 🙁 (Или хотя бы как прописать, чтобы игнорил эту ошибку и оставлял переменную пустой)