Веб-скрапинг динамического контента с Selenium и Python
Здравствуйте. В сегодняшней статье мы рассмотрим, как парсить некоторые динамические сайты при помощи Python и библиотеки Selenium. Многие современные сайты генерируют контент динамически или же имеют значения изменяющиеся в зависимости от условий. Парсинг подобных сайтов с помощью библиотеки bs4 может вызвать множестов проблем. Один из подходов заключается в том, чтобы имитировать взаимодействие пользователя на веб-сайте, прежде чем использовать bs4 для анализа интересующих вас элементов.
Ниже приведен рабочий пример получения динамического контента с помощью Selenium. Он предназначен только для иллюстративных целей.
from bs4 import BeautifulSoup
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from selenium import webdriver
import lxml
import time
link = r'https://www.cryptocompare.com/'
browser = webdriver.Chrome()
browser.get(link)
WebDriverWait(browser, 10).until(EC.presence_of_element_located(
(By.CLASS_NAME, "panel-body")))
crypt_elements = browser.find_element(By.CLASS_NAME, 'table-coins')
prices_html = BeautifulSoup(crypt_elements.get_attribute(
'innerHTML'), features='lxml').prettify()
# Затем вы можете разобрать price_html
# Вывод результата
print(prices_html)
# Запишем разметку в html файл
with open("coins.html","w") as f:
print(prices_html, file=f)
# Базовый try catch для проверки ошибок.
except Exception as e:
print(e)
time.sleep(2)
# закрываем браузер после всех манипуляций
browser.quit()
Здесь .get_attribute('innerHTML') используется для получения HTML выбранного элемента. Идея состоит в том, чтобы дождаться загрузки элементов браузером, найти интересующие вас элементы, а затем разобрать их через bs4 для получения окончательного результата.
Приведенный выше код извлекает цены один раз. Чтобы непрерывно получать цены, вы можете передать их через рекурсивный цикл.
Таким образом, мы попытались обработать динамический контент при помощи Selenium и bs4.

Копирование материалов разрешается только с указанием автора (Михаил Русаков) и индексируемой прямой ссылкой на сайт (http://myrusakov.ru)!
Добавляйтесь ко мне в друзья ВКонтакте: http://vk.com/myrusakov.
Если Вы хотите дать оценку мне и моей работе, то напишите её в моей группе: http://vk.com/rusakovmy.
Если Вы не хотите пропустить новые материалы на сайте,
то Вы можете подписаться на обновления: Подписаться на обновления
Если у Вас остались какие-либо вопросы, либо у Вас есть желание высказаться по поводу этой статьи, то Вы можете оставить свой комментарий внизу страницы.
Порекомендуйте эту статью друзьям:
Если Вам понравился сайт, то разместите ссылку на него (у себя на сайте, на форуме, в контакте):
Она выглядит вот так:
Комментарии ( 0 ):
Для добавления комментариев надо войти в систему.
Если Вы ещё не зарегистрированы на сайте, то сначала зарегистрируйтесь.
Python Web Scraping – Динамические сайты
В этой главе мы узнаем, как выполнять очистку веб-страниц на динамических веб-сайтах, а также подробные концепции.
Вступление
Соскоб в Интернете – сложная задача, и сложность увеличивается, если сайт динамический. Согласно Глобальному аудиту доступности веб-сайтов Организации Объединенных Наций, более 70% веб-сайтов являются динамичными по своей природе, и для своей функциональности они используют JavaScript.
Пример динамического сайта
Давайте посмотрим на пример динамического веб-сайта и узнаем о том, почему его трудно очистить. Здесь мы собираемся взять пример поиска с веб-сайта с именем http://example.webscraping.com/places/default/search. Но как мы можем сказать, что этот сайт имеет динамичный характер? Об этом можно судить по выводу следующего скрипта Python, который попытается очистить данные с вышеупомянутой веб-страницы –
Выход
Приведенный выше вывод показывает, что пример скребка не смог извлечь информацию, потому что элемент <div>, который мы пытаемся найти, пуст.
Подходы для очистки данных с динамических сайтов
Мы видели, что скребок не может очистить информацию с динамического веб-сайта, потому что данные загружаются динамически с помощью JavaScript. В таких случаях мы можем использовать следующие два метода для очистки данных с динамических JavaScript-зависимых веб-сайтов:
- Обратный инжиниринг JavaScript
- Рендеринг JavaScript
Обратный инжиниринг JavaScript
Процесс, называемый обратным инжинирингом, будет полезен и позволит нам понять, как данные загружаются динамически веб-страницами.
Для этого нам нужно щелкнуть вкладку inspect element для указанного URL. Далее мы перейдем на вкладку NETWORK, чтобы найти все запросы, сделанные для этой веб-страницы, включая search.json с путем / ajax . Вместо доступа к данным AJAX из браузера или через вкладку NETWORK, мы можем сделать это также с помощью следующего скрипта Python –
пример
Приведенный выше скрипт позволяет нам получить доступ к ответу JSON с помощью метода Python json. Точно так же мы можем загрузить необработанный строковый ответ и, используя метод json.loads в python, также можем загрузить его. Мы делаем это с помощью следующего скрипта Python. Он будет в основном очищать все страны, выполняя поиск буквы алфавита «а», а затем перебирая получившиеся страницы ответов JSON.
После запуска вышеприведенного скрипта мы получим следующий вывод, и записи будут сохранены в файле с именем country.txt.
Выход
Рендеринг JavaScript
В предыдущем разделе мы провели реверс-инжиниринг на веб-странице о том, как работает API и как мы можем использовать его для получения результатов в одном запросе. Тем не менее, мы можем столкнуться со следующими трудностями при выполнении обратного проектирования –
Иногда сайты могут быть очень сложными. Например, если веб-сайт создан с помощью расширенного инструмента браузера, такого как Google Web Toolkit (GWT), то полученный в результате код JS будет сгенерирован машинным способом и сложен для понимания и обратного инжиниринга.
Некоторые высокоуровневые фреймворки, такие как React.js, могут затруднить обратный инжиниринг, абстрагируя и без того сложную логику JavaScript.
Решение вышеуказанных трудностей состоит в том, чтобы использовать механизм рендеринга браузера, который анализирует HTML, применяет форматирование CSS и выполняет JavaScript для отображения веб-страницы.
пример
В этом примере для рендеринга Java Script мы будем использовать знакомый модуль Python Selenium. Следующий код Python будет визуализировать веб-страницу с помощью Selenium –
Во-первых, нам нужно импортировать веб-драйвер из селена следующим образом:
Теперь укажите путь к веб-драйверу, который мы скачали в соответствии с нашим требованием –
Теперь укажите URL, который мы хотим открыть в этом веб-браузере, который теперь контролируется нашим скриптом Python.
Теперь мы можем использовать идентификатор панели инструментов поиска для настройки элемента для выбора.
Далее, мы можем использовать java-скрипт для установки содержимого поля выбора следующим образом:
Следующая строка кода показывает, что поиск готов для нажатия на веб-странице –
Следующая строка кода показывает, что он будет ждать 45 секунд для завершения запроса AJAX.
Теперь для выбора ссылок на страны мы можем использовать селектор CSS следующим образом:
Теперь текст каждой ссылки может быть извлечен для создания списка стран –
Web Scraping с помощью python
Недавно заглянув на КиноПоиск, я обнаружила, что за долгие годы успела оставить более 1000 оценок и подумала, что было бы интересно поисследовать эти данные подробнее: менялись ли мои вкусы в кино с течением времени? есть ли годовая/недельная сезонность в активности? коррелируют ли мои оценки с рейтингом КиноПоиска, IMDb или кинокритиков?
Но прежде чем анализировать и строить красивые графики, нужно получить данные. К сожалению, многие сервисы (и КиноПоиск не исключение) не имеют публичного API, так что, приходится засучить рукава и парсить html-страницы. Именно о том, как скачать и распарсить web-cайт, я и хочу рассказать в этой статье.
В первую очередь статья предназначена для тех, кто всегда хотел разобраться с Web Scrapping, но не доходили руки или не знал с чего начать.
Off-topic: к слову, Новый Кинопоиск под капотом использует запросы, которые возвращают данные об оценках в виде JSON, так что, задача могла быть решена и другим путем.
Задача
- Этап 1: выгрузить и сохранить html-страницы
- Этап 2: распарсить html в удобный для дальнейшего анализа формат (csv, json, pandas dataframe etc.)
Инструменты
Регулярные выражения, конечно, нам пригодятся, но использовать только их, на мой взгляд, слишком хардкорный путь, и они немного не для этого. Были придуманы более удобные инструменты для разбора html, так что перейдем к ним. , lxml
Это две наиболее популярные библиотеки для парсинга html и выбор одной из них, скорее, обусловлен личными предпочтениями. Более того, эти библиотеки тесно переплелись: BeautifulSoup стал использовать lxml в качестве внутреннего парсера для ускорения, а в lxml был добавлен модуль soupparser. Подробнее про плюсы и минусы этих библиотек можно почитать в обсуждении. Для сравнения подходов я буду парсить данные с помощью BeautifulSoup и используя XPath селекторы в модуле lxml.html.
Это уже не просто библиотека, а целый open-source framework для получения данных с веб-страниц. В нем есть множество полезных функций: асинхронные запросы, возможность использовать XPath и CSS селекторы для обработки данных, удобная работа с кодировками и многое другое (подробнее можно почитать тут). Если бы моя задача была не разовой выгрузкой, а production процессом, то я бы выбрала его. В текущей постановке это overkill.
Загрузка данных
Первая попытка
Приступим к выгрузке данных. Для начала, попробуем просто получить страницу по url и сохранить в локальный файл.
Открываем полученный файл и видим, что все не так просто: сайт распознал в нас робота и не спешит показывать данные. 
Разберемся, как работает браузер
Однако, у браузера отлично получается получать информацию с сайта. Посмотрим, как именно он отправляет запрос. Для этого воспользуемся панелью «Сеть» в «Инструментах разработчика» в браузере (я использую для этого Firebug), обычно нужный нам запрос — самый продолжительный.
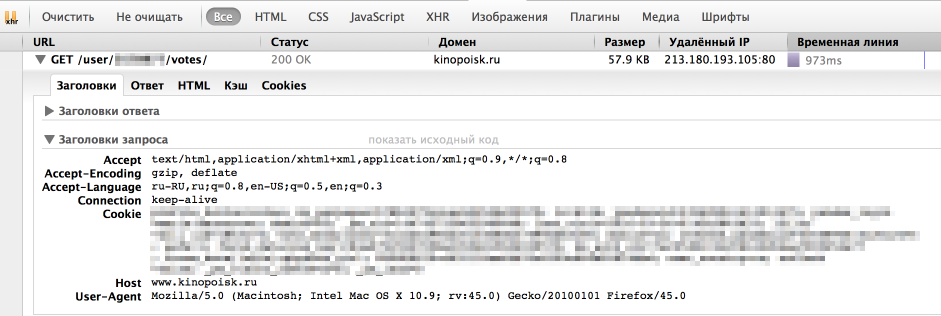
Как мы видим, браузер также передает в headers UserAgent, cookie и еще ряд параметров. Для начала попробуем просто передать в header корректный UserAgent.
На этот раз все получилось, теперь нам отдаются нужные данные. Стоит отметить, что иногда сайт также проверяет корректность cookie, в таком случае помогут sessions в библиотеке Requests.
Скачаем все оценки
Теперь мы умеем сохранять одну страницу с оценками. Но обычно у пользователя достаточно много оценок и нужно проитерироваться по всем страницам. Интересующий нас номер страницы легко передать непосредственно в url. Остается только вопрос: «Как понять сколько всего страниц с оценками?» Я решила эту проблему следующим образом: если указать слишком большой номер страницы, то нам вернется вот такая страница без таблицы с фильмами. Таким образом мы можем итерироваться по страницам до тех, пор пока находится блок с оценками фильмов ( <div > ).

Парсинг
Немного про XPath
XPath — это язык запросов к xml и xhtml документов. Мы будем использовать XPath селекторы при работе с библиотекой lxml (документация). Рассмотрим небольшой пример работы с XPath
Подробнее про синтаксис XPath также можно почитать на W3Schools.
Вернемся к нашей задаче
Теперь перейдем непосредственно к получению данных из html. Проще всего понять как устроена html-страница используя функцию «Инспектировать элемент» в браузере. В данном случае все довольно просто: вся таблица с оценками заключена в теге <div > . Выделим эту ноду:
Каждый фильм представлен как <div > или <div > . Рассмотрим, как вытащить русское название фильма и ссылку на страницу фильма (также узнаем, как получить текст и значение атрибута). 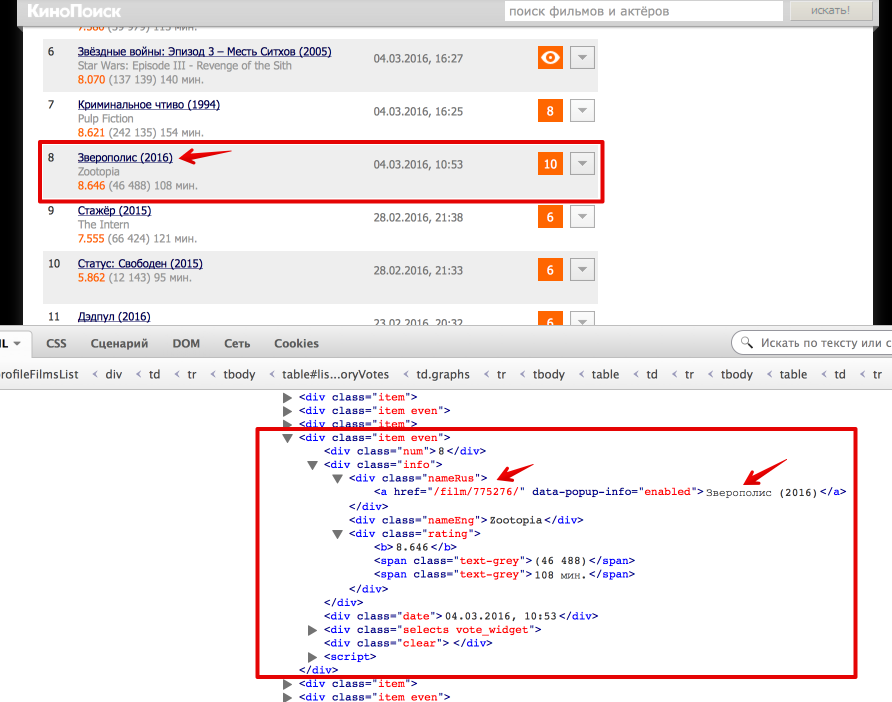
Еще небольшой хинт для debug’a: для того, чтобы посмотреть, что внутри выбранной ноды в BeautifulSoup можно просто распечатать ее, а в lxml воспользоваться функцией tostring() модуля etree.
Резюме
В результате, мы научились парсить web-сайты, познакомились с библиотеками Requests, BeautifulSoup и lxml, а также получили пригодные для дальнейшего анализа данные о просмотренных фильмах на КиноПоиске. 
Полный код проекта можно найти на github’e.
Руководство по вэб-скрепингу на Python: приёмы и хитрости
Как-то я хотела купить авиабилеты и заметила, что цены изменяются несколько в течение дня. Я попыталась выяснить, когда наступает самый лучший момент для покупки билетов, но не нашла в Интернете ничего, что бы могло мне помочь решить эту задачу. Тогда я написала небольшую программу для автоматического сбора данных в Интернете — так называемую программу скрепинга. Программа извлекла информацию по моему запросу для определенного пункта назначения на выбранные мной даты и показала мне, когда стоимость становится минимальной.
Веб-скрепинг — это метод автоматизированного извлечения данных с веб-сайтов.
Я имею большой опыт веб-скрепинга и хочу с вами поделиться.
Этот пост предназначен для тех, кому интересно узнать об общих шаблонах проектирования, подвохах и правилах, связанных с веб-скрепингом. В статье представлено несколько реальных примеров и перечень типовых задач, таких как, например, что делать, чтобы вас не обнаружили, что можно делать, а что не следует и, наконец, как ускорить работу вашего скрепера с помощью распараллеливания.
Все примеры будут сопровождаться фрагментами кода на Python, так что вы можете сразу же ими воспользоваться. В этом материале также будет показано, как привлекать к работе полезные пакеты Python.
Реальные примеры
Существует различные причины и варианты необходимости использования сбора (скрэпинга) данных в Интернете. Позвольте мне перечислить некоторые из них:
-
, чтобы определить имеется ли в наличии одежда, которую вы хотите купить, со скидкой нескольких брендов одежды, собирая данные о них с вэб-страниц
- стоимость авиабилетов может меняться несколько раз в течение дня. Можно сканировать веб-сайт и дождаться момента, когда цена будет снижена
- проанализировать веб-сайты, чтобы определить, должна ли быть стартовая стоимость продажи низкой или высокой, чтобы привлечь больше участников на аукцион или коррелирует ли длительность проведения аукциона с более высокой ценой конечной ценой продажи
Руководство
- Применяемые пакеты
- Основной программный код
- Распространенные ошибки
- Общие правила
- Ускорение ‑ распараллеливание
Прежде чем мы приступим: БУДЬТЕ аккуратны с серверами; вы же НЕ ХОТИТЕ сломать вэб-сайт.
1. Известные пакеты и инструменты
Для веб-скрэпинга нет универсального решения, поскольку способ, с помощью которого хранится на каждом из веб-сайтов обычно специфичны. На самом деле, если вы хотите собрать данные с сайта, вам необходимо понять структуру сайта и, либо создать собственное решение, либо воспользоваться гибким и перенастраиваемым вариантом уже готового решения.
Изобретать колесо здесь не нужно: существует множество пакетов, которые скорее всего, вам вполне подойдут. В зависимости от ваших навыков программирования и предполагаемого варианта использования вы можете найти разные более или менее полезные для себя пакеты.
1.1 Проверяем параметры
Чтобы вам было проще проверять HTML-сайт, воспользуйтесь опцией инспектора в вашем вэб-браузере.
Раздел веб-сайта, который содержит мое имя, мой аватар и мое описание, называется hero hero—profile u-flexTOP (любопытно, что Medium называет своих писателей героями:)). Класс <h1>, который содержит мое имя, называется ui-h2 hero-title , а описание содержится в описании героя <p> классом ui-body hero-description .
Вы можете более подробно познакомиться с HTML-тэгами и различиями между классами и id здесь.
1.2 Скрэпинг
Существует отдельная готовая к использованию библиотека для извлечения данных под названием Scrapy. Кроме извлечения HTML, этот пакет располагает большим количеством функций, таких как экспорт данных в различные форматы, создание лог-файлов и т.д. Это достаточно гибкий и настраиваемый вариант: запуск отдельных скрэперов на разных процессах , отключение cookies (некоторые сайты используют cookies для идентификации ботов) и установка задержек загрузки (веб-сайт может быть перегружен из-за огромного количества запросов на сканирование). Его также можно использовать для извлечения данных с помощью API. Однако для начинающих программистов пакет, скорее всего, будет несколько сложноват: вам придется прочитать руководства и разобраться с примерами, прежде чем вы сможете приступить к работе.
В моем случае я воспользовалась готовым методом «из коробки»: я просто хотела извлечь ссылки со всех страниц, получить доступ по каждой ссылке и извлечь из нее информацию.
1.3 BeautifulSoup с библиотекой Request
BeautifulSoup — это библиотека, позволяющая сделать синтаксический разбор (парсинг) HTML-кода. Кроме того, вам также потребуется библиотека Request , которая будет отображать содержимое URL-адреса. Однако, вы также должны позаботиться и о решении ряда прочих вопросов, таких как обработка ошибок, экспорт данных, распараллеливание и т.д.
Я выбрала BeautifulSoup, поскольку эта библиотека помогла мне понять сколько всего Scrapy может делать самостоятельно и, я надеюсь, помогла мне быстрее научиться на своих собственных ошибках.
2. Основной программный код
Начать скэпить вэб-сайт очень просто. В большинстве случаев просматриваете HTML-сайт, вы обнаружите те классы и идентификаторы, которые могут вам могут понадобиться. Допустим, у нас есть следующая структура html, и мы хотим извлечь элементы main_price .
Примечание: элемент discounted_price является необязательным.
Основной код вэб-скрепера должен импортировать библиотеки, выполнить запрос, проанализировать html и затем найти класс class main_price .
Может случиться так, что класс main_price находится в другом разделе веб-сайта. Чтобы избежать извлечения ненужного класса main_price из какой-либо другой части веб-страницы, мы могли бы сначала обратиться к id listings_prices и только затем найти все элементы с классом main_price .
3. Распространенные ошибки
3.1 Check robots.txt
Правила скрэпинга веб-сайтов можно найти в файле robots.txt. Вы можете найти его, написав слова «robots.txt» после имени домена, например так: www.website_to_scrape.com/robots.txt . Эти правила определяют, какие части веб-сайтов не могут быть автоматически извлечены или как часто боту разрешено запрашивать данные со страницы. Большинство не заботятся об этих правилах, но все же постарайтесь хотя бы почитать их, даже если вы и не планируете следовать им.
3.2 HTML может быть злом
HTML-теги могут содержать идентификатор (id), класс или сразу оба этих элемента. Идентификатор (т.е. id) HTML описывает уникальный идентификатор, а класс HTML не является уникальным. Изменения в имени или элементе класса могут либо сломать ваш код, либо выдать вам неправильные результаты.
Есть два способа избежать, или, по крайней мере, предупредить это:
• Используйте конкретный идентификатор id , а не class , поскольку он с меньшей вероятностью будет изменен
- Проверьте, не возвращается ли элемент значение None.
Однако, поскольку некоторые поля могут быть необязательными (например, discounted_price в нашем HTML-примере), соответствующие элементы не будут отображаться в каждом списке. В этом случае вы можете подсчитать процентное соотношение частоты возврата None конкретным элементом в списке. Если это 100%, вы, возможно, захотите проверить, было ли изменено имя элемента.
3.3 Обмануть программу-агент
Каждый раз, когда вы посещаете веб-сайт, он получает информацию о вашем браузере через пользовательский агент. Некоторые веб-сайты не будут показывать вам какой-либо контент, если вы не предоставите им пользовательский агент. Кроме того, некоторые сайты предлагают разные материалы для разных браузеров. Веб-сайты не хотят блокировать разрешенных пользователей, но вы будете выглядеть подозрительно, если вы отправите 200 одинаковых запросов в секунду с помощью одного и того же пользовательского агента. Выход из этой ситуации может заключаться в том, чтобы сгенерировать (почти) случайного пользовательского агента или задать его самостоятельно.
3.4 Время ожидания запроса
По умолчанию Request будет продолжать ожидать ответ в течение неопределенного срока. Поэтому рекомендуется установить параметр таймаута.
3.5 Я заблокирован?
Частое появление кодов состояния, таких как 404 (не найдено), 403 (Запрещено), 408 (Тайм-аут запроса), может указывать на то, что вы заблокированы. Вы можете проверить эти коды ошибок и действовать соответственно.
Кроме того, будьте готовы обработать исключения из запроса.
3.6 Смена IP
Даже если вы рандомизировали своего пользовательского агента, все ваши запросы будут отправлены с одного и того же IP-адреса. Это вполне нормально, поскольку библиотеки, университеты, а также компании имеют всего несколько IP-адресов. Однако, если очень много запросов поступает с одного IP-адреса, сервер может это обнаружить.
Использование общих прокси, VPN или TOR может помочь вам стать незаметным;)
Если вы используете общий прокси-сервер, веб-сайт увидит IP-адрес прокси-сервера, а не ваш. VPN соединяет вас с другой сетью, а IP-адрес поставщика VPN будет отправлен на веб-сайт.
3.7 Ловушки для хакеров
Ловушки для хакеров — это средства для обнаружения сканеров или скреперов.
Такими средствами могут быть «скрытые» ссылки, которые не видны пользователям, но могут быть извлечены скреперами и/или вэб-спайдерами. Такие ссылки будут иметь набор стилей CSS display:none , их можно смешивать, задачая цвет фона или даже перемещаясь из видимой области страницы. Как только ваша программа посещает такую ссылку, ваш IP-адрес может быть помечен для дальнейшего расследования или даже мгновенно заблокирован.
Другой способ обнаружить хакеров — это добавить ссылки с бесконечно глубокими деревьями директорий. В этом случае вам нужно ограничить количество загруженных страниц или ограничить глубину обхода.
4. Общие правила
- Перед началом скрэпинга проверьте, есть ли у вас возможность воспользоваться публичными API. Публичные API предоставляют более простой и быстрый (и законный) поиск данных, по сравнению с веб-скрэпингом. Посмотрите API Twitter, который предоставляет API для различных целей.
- Если вы скрэпите много данных, вы можете воспользоваться базой данных, чтобы иметь возможность быстро анализировать получать данные с Интернета. В этом руководстве описано, как создать локальную базу данных с помощью Python.
- Будьте вежливы, терпеливы и уважительны. Как следует из этого ответа, рекомендуется оповещать пользователей о том, что вы собираете данные с их веб-сайта, чтобы они могли лучше отреагировать на возможные проблемы, причиной которых может стать ваш бот.
Опять таки, не перегружайте веб-сайт, отправляя сотни запросов в секунду.
5. Ускорение ‑ распараллеливание
Если вы решитесь на распараллеливание своей программы, будьте осторожны с реализацией, чтобы не “свалить” сервер. Обязательно прочитайте раздел «Распространенные ошибки», приведенный выше. Ознакомьтесь с определениями параллельного и последовательного выполнения, процессоров и потоков здесь и здесь.
Если вы извлекаете большое количество информации со страницы и выполняете некоторую предварительную обработку данных, количество повторных запросов в секунду, которое вы отправляете на страницу, может быть относительно низким.
В своем другом проекте я собирала цены на аренду квартиры и сделала для этого довольно сложную предварительную обработку данных, в результате чего мне удалось отправлять только один запрос в секунду. Чтобы собрать объявления размером в 4K, моя программа должна проработать около часа.
Чтобы отправлять запросы параллельно, вы можете воспользоваться пакетом multiprocessing.
Допустим, у нас есть 100 страниц, и мы хотим назначить каждому процессу равное количество страниц для обработки. Если n — количество процессоров, то вы можете равномерно распределить все страницы на n частей и назначить каждую часть отдельному процессору. Каждый процесс будет иметь свое имя, свою целевую функцию и свои аргументы для работы. После этого имя процесса можно использовать для включения записи данных в определенный файл.
Я назначила 1K страниц для каждого из 4-х процессоров, имевшихся у меня в распоряжении, в результате было создано 4 повторных запроса в секунду, что сократило время сбора данных моей программой до 17 минут.